Erste SchritteAnleitung
Mehrstufiger Chat mit einer API: das messages-Array erneut senden
Das Modell erinnert sich zwischen Anfragen an nichts. Bauen Sie eine Python-Chat-Schleife, die das messages-Array erneut sendet, und sehen Sie, wie die Eingabe-Tokens wachsen.
Auf dieser Seite
Ihre zweite Frage erhält eine seltsame Antwort, weil die API Ihre erste nie gesehen hat. Das Modell behält zwischen Anfragen nichts, daher ist ein Chat etwas, das Sie bauen: Nach jeder Antwort hängen Sie sie an eine Liste namens messages an und senden die gesamte Liste erneut. Das ist der ganze Trick, und unten folgt eine funktionierende Python-Schleife dafür gegen die OpenAI-kompatible API von CheapTokens.
Zwei offizielle Dokumentationen beschreiben dasselbe. Die Messages-API-Referenz von Anthropic (geprüft am 30. Oktober 2026) bezeichnet die API als zustandslos und mehrstufig: Frühere Turns werden im Parameter messages übertragen. Der Textgenerierungs-Leitfaden von OpenAI (geprüft am 30. Oktober 2026) empfiehlt, den Kontext zu erhalten, indem frühere Turns als rollenmarkierte Nachrichten gesendet und jede Antwort vor der nächsten Anfrage angehängt wird.
Warum die zweite Frage einen leeren Blick erntet#
Angenommen, Sie tippen What is a token?, lesen die Antwort und tippen dann Explain it shorter. Für Sie ist "es" offensichtlich. Für die API ist Anfrage Nummer zwei die einzeilige Nachricht eines Fremden: Es gibt kein "es", nichts zu verkürzen. Sie erhalten eine Vermutung oder eine Rückfrage, keine kürzere Erklärung.
Die Lösung besteht darin, dass Anfrage zwei alles enthält, was Anfrage eins hatte, plus die Antwort, plus die neue Frage. Vergleichen Sie die beiden Payloads:
Vergleichen
Anfrage 2, mit und ohne Verlauf
Ohne Verlauf
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Das Modell hat keine Ahnung, was "es" ist.
Mit Verlauf
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Jetzt verweist "es" auf die erste Antwort.
Drei Rollen erledigen die ganze Arbeit. system legt die Regeln einmal fest (Ton, Länge, wofür der Bot da ist). user ist das, was die Person getippt hat. assistant ist das, was das Modell zuvor gesagt hat. Das Modell liest die Liste von oben nach unten und schreibt die nächste assistant-Nachricht.
Die Chat-Schleife in wenigen Zeilen#
Installieren Sie das SDK mit pip install openai und bewahren Sie Ihren Schlüssel in einer Umgebungsvariable auf, wie in how to store an API key safely. Die Basis-URL und die Modell-ID stammen aus der CheapTokens-Dokumentation und GET /v1/models (mehr in listing models to find the exact id). Für eine Lernschleife ist GLM-5.3-Flash gut geeignet: 390K Kontext und bis zu 8.192 Ausgabe-Tokens pro Antwort.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Führen Sie es aus, fragen Sie What is a token?, dann Explain it shorter. Die zweite Antwort bezieht sich nun auf die erste. Die letzte Zeile gibt usage. aus, die Eingabeseite der Rechnung für diesen Turn; beobachten Sie, wie sie mit jeder Frage steigt.
Die Reihenfolge innerhalb der Schleife ist wichtig, und das ist der Teil, den Anfänger am häufigsten falsch machen:
In die richtige Reihenfolge bringen
Einen Turn der Schleife in die richtige Reihenfolge bringen
Ziehe die Elemente oder benutze die Pfeile
- Die Frage des Nutzers an messages anhängen
- Die gesamte messages-Liste senden
- Die Antwort aus der Response lesen
- Die Antwort als Assistant-Nachricht anhängen
Überspringen Sie Schritt 4, und das Modell vergisst seine eigenen Antworten, sodass "erklär es kürzer" einmal funktioniert und dann bei der dritten Frage wieder scheitert.
Wie die Liste nach zwei Turns aussieht#
Nach What is a token? und Explain it shorter enthält die Liste in Ihrem Code fünf Einträge: die Systemregel, die erste Frage, die erste Antwort, die zweite Frage, die zweite Antwort. Die nächste Anfrage sendet alle fünf plus die dritte Frage.
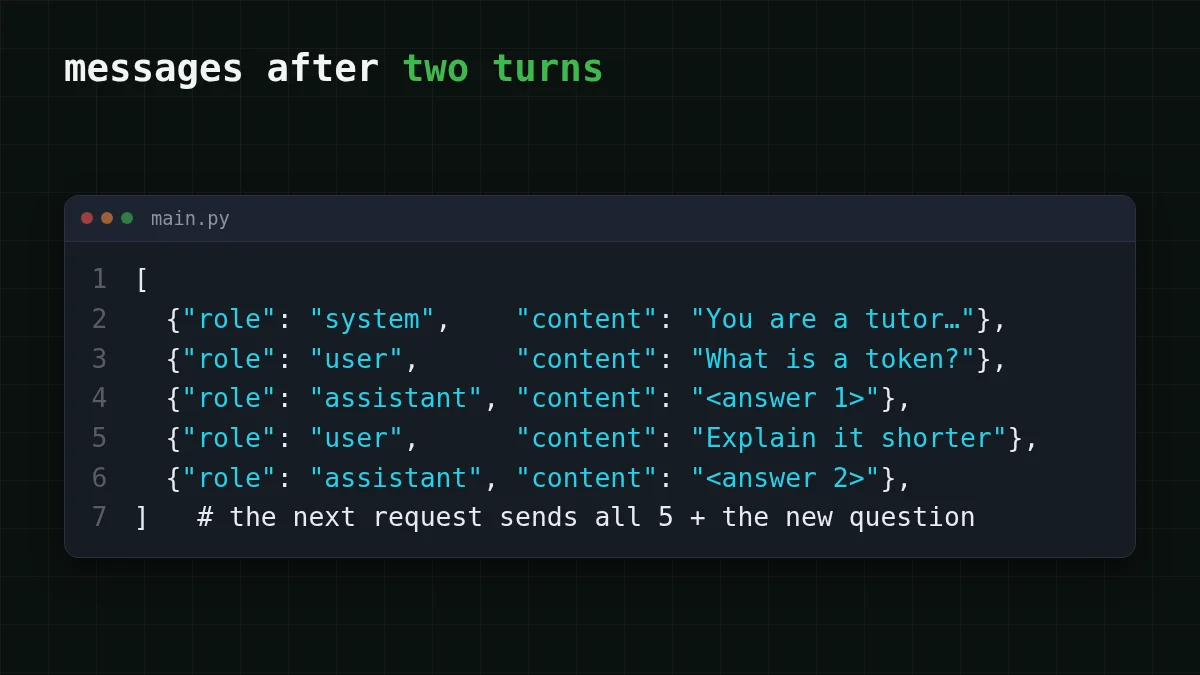
Die Systemnachricht wird jedes Mal gesendet. Die API "behält" sie nicht auf ihrer Seite; sie ist einfach der erste Eintrag der Liste. Der Leitfaden von OpenAI (geprüft am 30. Oktober 2026) merkt an, dass Anweisungen nur für die aktuelle Anfrage gelten, was dieselbe Idee aus der anderen Richtung ist. Wenn Sie diese erste Nachricht anpassen möchten, siehe system prompt and temperature explained.
Was mit den Eingabe-Tokens passiert, wenn der Chat wächst#
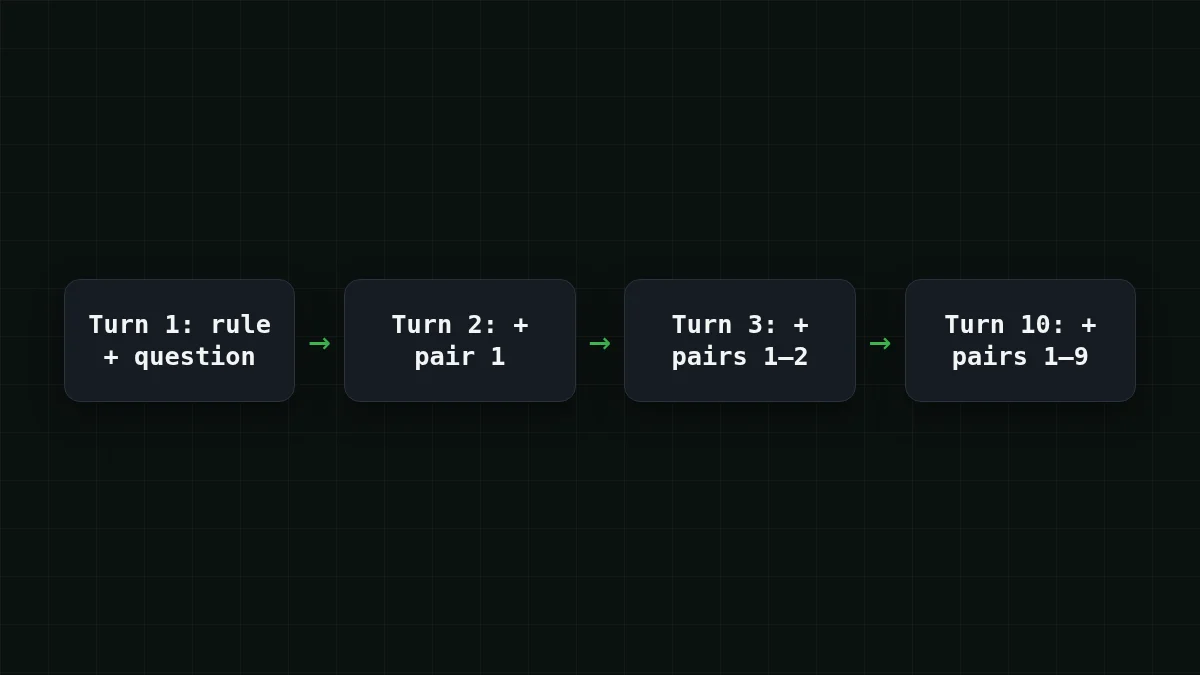
Jede Anfrage bezahlt die gesamte Liste erneut als Eingabe. Turn 1 sendet die Systemregel und eine Frage; Turn 10 sendet die Regel, neun frühere Frage-Antwort-Paare und die neue Frage. Die Eingabe wächst also mit jedem Turn, selbst wenn jede Ihrer Nachrichten kurz ist.
Nehmen wir einen 10-Turn-Chat mit diesen Annahmen: Die Systemregel umfasst etwa 50 Tokens, jede Frage etwa 150, jede Antwort etwa 250. Turn 1 sendet 50 + 150 = 200 Eingabe-Tokens. Jeder spätere Turn fügt ein weiteres 400-Token-Paar hinzu (150 + 250 = 400), sodass die gesamte Eingabe über zehn Turns 200 × 10 + 400 × 45 = 20.000 Tokens beträgt, wobei 45 = 0 + 1 + … + 9 ist. Die Ausgabe beträgt 250 × 10 = 2.500 Tokens. Zehn Nachrichten von Ihnen, und die Eingabe ist achtmal so groß wie die Ausgabe.
Hier ist dieser ganze Chat zu Live-Preisen kalkuliert, 20.000 Tokens Eingabe und 2.500 Ausgabe:
| Modell | Input $/1M | Output $/1M | Kosten | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20.000 Input- und 2.500 Output-Tokens insgesamt. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
In der Summe, mit Eingabe und Ausgabe zusammen gezählt, kosten GLM-5.3-Flash und DeepSeek-V4-Flash hier weniger als bei OpenRouter, und beide halten zu jeder Stunde einen Preis. Wenn Sie im selben Chat-Loop Antworten länger als 8.192 Tokens wünschen, erlaubt DeepSeek-V4-Flash bis zu 32.768 Ausgabe-Tokens pro Antwort bei einem 380K-Kontext; tauschen Sie die Modell-ID gegen deepseek- aus, und sonst ändert sich nichts in der Schleife.
Die tiefergehende Kostengeschichte steht in why a long AI chat costs more; input vs output tokens erklärt, warum die beiden Seiten getrennt bepreist werden.
Kurzer Check
Ihr Chat ist bei Turn 8. Was enthält die Anfrage für Turn 8?
Antwort anzeigen
Antwort: Die Systemnachricht und jede frühere Frage und Antwort, plus die neueste Frage
Die API erinnert sich an nichts, daher geht jedes Mal die vollständige Liste raus. Deshalb steigen auch die Eingabe-Tokens Turn für Turn.
Einen langen Chat unter Kontrolle halten#
Die Liste kann nicht ewig wachsen: Sie muss in das Kontextfenster des Modells passen (siehe what a context window is), und jeder zusätzliche Turn kostet Eingabe. Zwei Gewohnheiten halten sie für einen Prototyp vernünftig:
- Die ältesten Turns kürzen. Behalten Sie die Systemnachricht und die letzten paar Paare, zum Beispiel
messages = messages[:1] + messages[-vor jeder Anfrage. Entfernen Sie Paare gemeinsam, damit eine Frage nie ihre Antwort verliert.8:] - Für ein neues Thema eine frische Liste beginnen. Eine neue Aufgabe braucht nicht den Verlauf der alten.
Ein Support-Bot mit einem langlebigen Regelsatz ist dieselbe Schleife: Die Systemnachricht legt die Regeln einmal fest, jeder User-Turn und jede Antwort wird angehängt, und Sie kürzen, wenn die Liste schwer wird. Für die erste Anfrage selbst siehe your first API request with CheapTokens; die Modellliste und Preise stehen auf der pricing page.


