Початок роботиПосібник
Багатоходовий чат з API: повторно надсилайте масив messages
Модель нічого не пам'ятає між запитами. Побудуйте цикл чату на Python, який повторно надсилає масив messages, і подивіться, як зростають вхідні токени.
На цій сторінці
Ваше друге запитання отримує дивну відповідь, бо API ніколи не бачив першого. Модель нічого не зберігає між запитами, тож чат — це те, що ви будуєте: після кожної відповіді ви додаєте її до списку під назвою messages і надсилаєте весь список знову. Ось і весь трюк, а нижче — робочий цикл на Python для нього проти OpenAI-сумісного API CheapTokens.
Дві офіційні документації описують те саме. Довідка Anthropic Messages API (перевірено 30 жовтня 2026) називає API stateless і багатоходовим: попередні ходи передаються в параметрі messages. Посібник OpenAI з генерації тексту (перевірено 30 жовтня 2026) радить зберігати контекст, надсилаючи попередні ходи як повідомлення з ролями та додаючи кожну відповідь перед наступним запитом.
Чому друге запитання отримує порожній погляд#
Скажімо, ви вводите What is a token?, читаєте відповідь, а потім вводите Explain it shorter. Для вас "воно" очевидне. Для API запит номер два — це однорядкове повідомлення від незнайомця: немає ніякого "воно", нема чого скорочувати. Ви отримаєте здогадку або зустрічне запитання, а не коротше пояснення.
Рішення — зробити так, щоб запит два ніс усе, що мав запит один, плюс відповідь, плюс нове запитання. Порівняйте два payload'и:
Порівняйте
Запит 2, з історією та без неї
Без історії
messages = [
    {"role": "user", "content": "Explain it shorter"},
]
Модель гадки не має, що таке "воно".
З історією
messages = [
    {"role": "user", "content": "What is a token?"},
    {"role": "assistant", "content": "<the first answer>"},
    {"role": "user", "content": "Explain it shorter"},
]
Тепер "воно" вказує на першу відповідь.
Три ролі роблять усю роботу. system задає правила один раз (тон, довжина, для чого бот). user — це те, що ввела людина. assistant — це те, що модель сказала раніше. Модель читає список згори донизу і пише наступне повідомлення assistant.
Цикл чату в кілька рядків#
Встановіть SDK командою pip install openai і тримайте ключ у змінній середовища, як описано в як безпечно зберігати API-ключ. Базовий URL і id моделі беруться з документації CheapTokens та GET /v1/models (докладніше в перелік моделей, щоб знайти точний id). Для навчального циклу GLM-5.3-Flash — гарний вибір: контекст 390K і до 8 192 вихідних токенів на відповідь.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "zai-org/GLM-5.3-Flash"

messages = [
    {"role": "system", "content": "You are a patient tutor. Keep answers under 80 words."},
]

while True:
    question = input("you> ").strip()
    if question in ("", "exit"):
        break
    messages.append({"role": "user", "content": question})

    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        max_tokens=400,
    )
    answer = response.choices[0].message.content
    messages.append({"role": "assistant", "content": answer})

    print(answer)
    print(f"[input tokens this turn: {response.usage.prompt_tokens}]")
Запустіть його, запитайте What is a token?, потім Explain it shorter. Друга відповідь тепер посилається на першу. Останній рядок друкує usage. — вхідну частину рахунку за цей хід; спостерігайте, як вона зростає з кожним запитанням.
Порядок усередині циклу має значення, і саме тут початківці найчастіше помиляються:
Розставте по порядку
Упорядкуйте один хід циклу
Перетягніть елементи або скористайтеся стрілками
- Додайте запитання користувача до messages
- Надішліть весь список messages
- Прочитайте відповідь із response
- Додайте відповідь як повідомлення assistant
Пропустіть крок 4 — і модель забуде власні відповіді, тож "поясни коротше" спрацює один раз, а потім знову зламається на третьому запитанні.
Як виглядає список після двох ходів#
Після What is a token? та Explain it shorter список, який тримає ваш код, має п'ять елементів: системне правило, перше запитання, перша відповідь, друге запитання, друга відповідь. Наступний запит надішле всі п'ять плюс третє запитання.
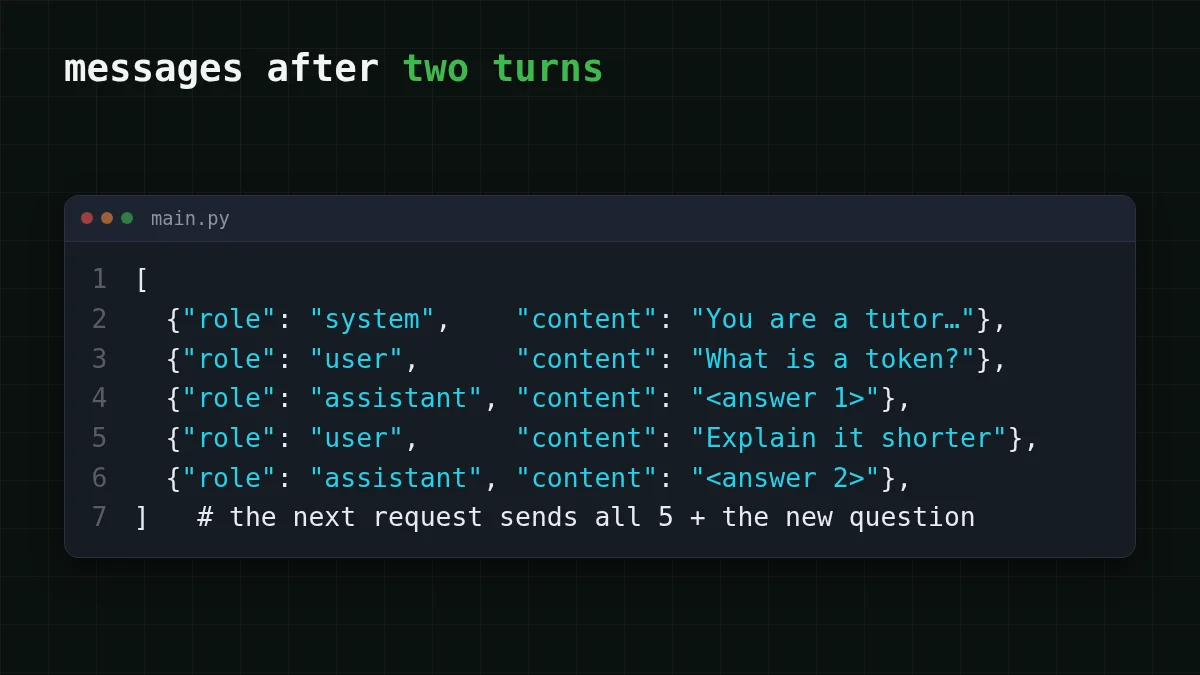
Системне повідомлення надсилається щоразу. API не "зберігає" його на своєму боці; це просто перший елемент списку. Посібник OpenAI (перевірено 30 жовтня 2026) зазначає, що інструкції застосовуються лише до поточного запиту, — це та сама ідея з іншого боку. Якщо хочете налаштувати це перше повідомлення, дивіться системний промпт і temperature пояснено.
Що відбувається з вхідними токенами, коли чат зростає#
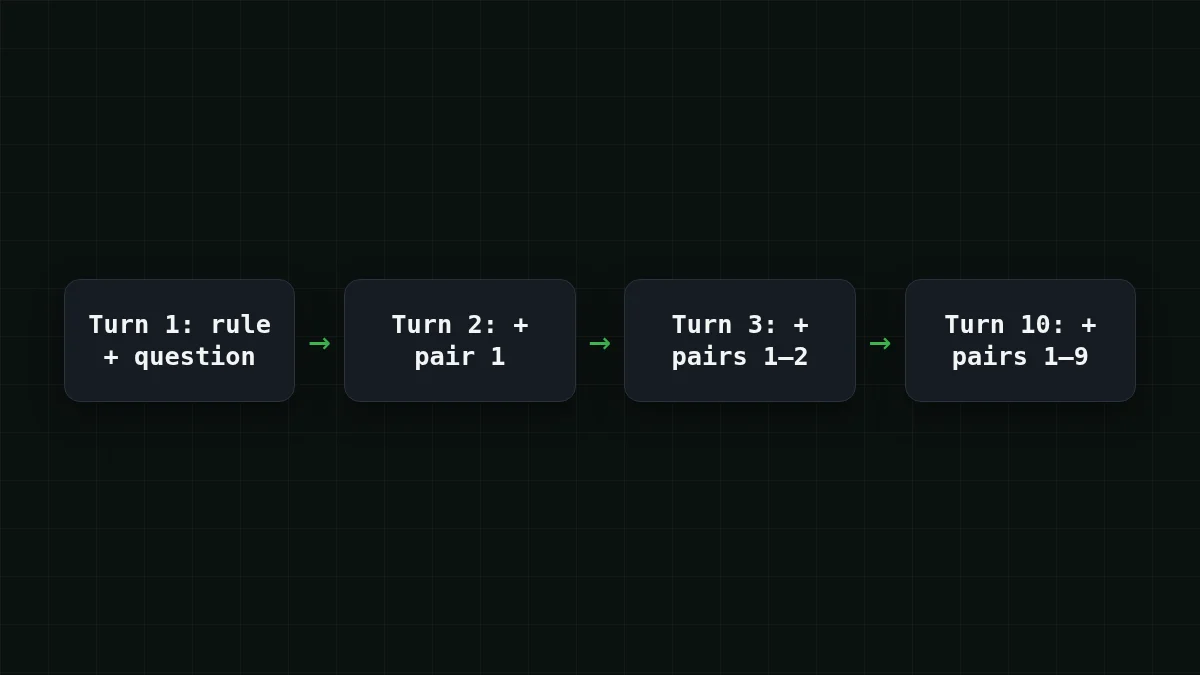
Кожен запит знову платить за весь список як за вхід. Хід 1 надсилає системне правило й одне запитання; хід 10 надсилає правило, дев'ять попередніх пар запитання-відповідь і нове запитання. Тож вхід зростає з кожним ходом, навіть якщо кожне ваше повідомлення коротке.
Скажімо, чат на 10 ходів із такими припущеннями: системне правило — близько 50 токенів, кожне запитання — близько 150, кожна відповідь — близько 250. Хід 1 надсилає 50 + 150 = 200 вхідних токенів. Кожен наступний хід додає ще одну пару на 400 токенів (150 + 250 = 400), тож загальний вхід за десять ходів становить 200 × 10 + 400 × 45 = 20 000 токенів, де 45 — це 0 + 1 + … + 9. Вихід — 250 × 10 = 2 500 токенів. Десять повідомлень від вас, а вхід у вісім разів більший за вихід.
Ось увесь цей чат, оцінений за живими тарифами, 20 000 токенів на вході та 2 500 на виході:
| Модель | Вхід $/1М | Вихід $/1М | Вартість | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0005 | $0.001 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00055 | $0.0013 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0014 | $0.009 |
20 000 вхідних і 2 500 вихідних токенів загалом. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
У підсумку, з урахуванням входу й виходу разом, GLM-5.3-Flash і DeepSeek-V4-Flash коштують тут менше, ніж в OpenRouter, і обидві тримають одну ціну в будь-яку годину. Якщо хочете відповіді довші за 8 192 токени в тому самому циклі чату, DeepSeek-V4-Flash дозволяє до 32 768 вихідних токенів на відповідь із контекстом 380K; замініть id моделі на deepseek- — і більше нічого в циклі не зміниться.
Глибша історія про витрати — в чому довгий AI-чат коштує дорожче; вхідні vs вихідні токени пояснює, чому ці дві сторони тарифікуються окремо.
Швидка перевірка
Ваш чат на ході 8. Що містить запит для ходу 8?
Показати відповідь
Відповідь: Системне повідомлення та кожне попереднє запитання й відповідь, плюс найновіше запитання
API нічого не пам'ятає, тож повний список надсилається щоразу. Ось чому вхідні токени зростають хід за ходом.
Як тримати довгий чат під контролем#
Список не може рости вічно: він має вміщатися у вікно контексту моделі (див. що таке вікно контексту), і кожен зайвий хід коштує входу. Дві звички тримають його розумним для прототипу:
- Обрізайте найстаріші ходи. Зберігайте системне повідомлення й останні кілька пар, наприклад
messages = messages[:1] + messages[-перед кожним запитом. Відкидайте пари разом, щоб запитання ніколи не втрачало своєї відповіді.8:] - Починайте новий список для нової теми. Нове завдання не потребує історії старого.
Бот підтримки з довготривалим набором правил — це той самий цикл: системне повідомлення задає правила один раз, кожен хід користувача й відповідь додаються, а ви обрізаєте, коли список стає важким. Щодо самого першого запиту дивіться ваш перший API-запит із CheapTokens; перелік моделей і ціни — на сторінці цін.


