AI для початківцівПосібник
Що таке контекстне вікно в AI? Що його заповнює і що робити
Контекстне вікно — це робоча пам'ять моделі для одного запиту: ваш промпт, історія чату та відповідь. Дізнайтеся, що його заповнює, як його оцінити та три звички.
На цій сторінці
Ваш чат нормально працював протягом двадцяти повідомлень, а тепер відповіді стають розпливчастими. Одна річ, яка зростає з кожним повідомленням, — це контекстне вікно: робоча пам'ять моделі для одного запиту. Воно містить усе, що ви надсилаєте, плюс відповідь, яку пише модель, і має фіксований розмір, наприклад 380K токенів для DeepSeek-V4-Flash.
Що таке контекстне вікно#
Уявіть стіл. Модель може працювати лише з тим, що зараз на столі: ваші інструкції, розмова на цей момент, вставлений документ і відповідь, яку вона пише. Усе, чого немає на столі, для неї не існує. Документація Anthropic про контекстні вікна (перевірено 27 жовтня 2026 року) формулює це так само: вікно — це весь текст, на який модель може посилатися, коли генерує відповідь, включаючи саму відповідь, і воно відокремлене від даних, на яких модель навчалася.
Стіл має фіксований розмір, що вимірюється в токенах. Токен — це фрагмент тексту, приблизно ¾ англійського слова; що таке токен в AI розповідає глибше. Ось три моделі на CheapTokens та їхні вікна:
- GLM-5.3-Flash: 390K токенів
- DeepSeek-V4-Flash: 380K токенів
- MiniMax-M2.7: 180K токенів
K означає тисяча. Вікно 380K — це приблизно 285 000 англійських слів: 380 000 × 0,75 = 285 000. Це кілька романів на одному столі, і воно все одно закінчується швидше, ніж ви думаєте.
Що зараховується до нього#
Усе в запиті зараховується, не лише ваше останнє повідомлення:
- системний промпт (постійні інструкції);
- кожне попереднє повідомлення, ваше й моделі;
- визначення інструментів і результати інструментів, якщо ви використовуєте агента або плагін редактора;
- документи та зображення, які ви прикріплюєте;
- сама відповідь, включаючи будь-яке міркування, яке робить модель.
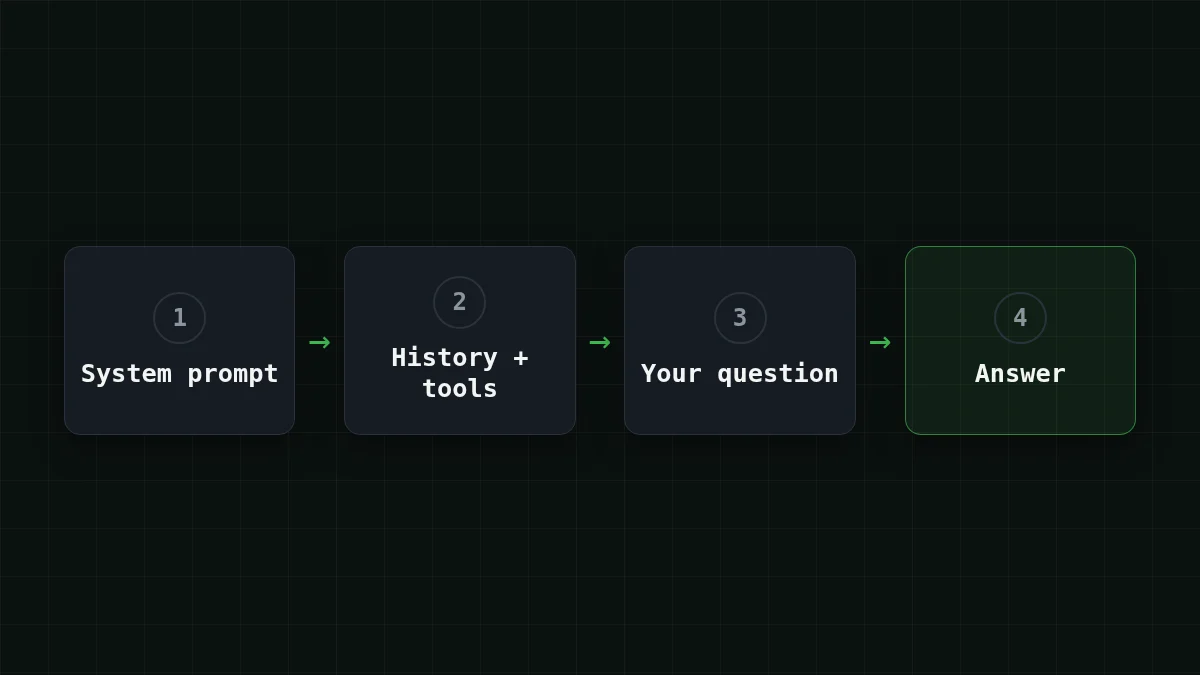
Агент редактора — це підступний випадок. На кожному кроці він знову надсилає список інструментів плюс усе, що він прочитав досі. Ви ввели одне речення; вікно бачить набагато більше.
Вам не потрібно вгадувати розмір. Кожна відповідь містить поле usage з кількістю токенів. Цей мінімальний цикл чату (API, сумісний з OpenAI, ідентифікатор моделі з документації CheapTokens) показує обидві речі одразу: вся історія надсилається на кожному кроці, і кількість повертається.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Викличте ask() десять разів і спостерігайте, як зростає перше число. Це зростання — вся суть цієї статті.
Вікно проти максимального виходу: два різні числа#
Кожна сторінка моделі перелічує два розміри, і початківці часто їх плутають. Вікно — це весь стіл, вхід і вихід разом. Ліміт виходу — це те, якою довгою може бути одна відповідь: до 32 768 токенів для DeepSeek-V4-Flash, до 8 192 для GLM-5.3-Flash і MiniMax-M2.7.
Вони ділять один і той самий простір. Скільки б не зайняв ваш вхід, відповідь має вміститися в те, що залишилося. Якщо ви хочете побачити, як виглядає обрізана відповідь, чому відповідь AI зупиняється посеред речення розбирає це.
Швидка перевірка
DeepSeek-V4-Flash має вікно 380K і ліміт виходу 32 768 токенів. Ви надсилаєте 375K токенів входу. Приблизно якою довгою може бути відповідь?
Показати відповідь
Відповідь: Близько 5K токенів, те, що залишилося у вікні
Вікно охоплює вхід і вихід разом: 380K − 375K залишає близько 5K, що нижче за обмеження 32 768.
Чому довгий чат заповнює вікно (і рахунок)#
Модель не пам'ятає ваше останнє повідомлення. Щоб продовжити розмову, API отримує всю історію знову на кожному кроці: попередні кроки зберігаються повністю, а відповідь моделі стає частиною наступного входу. (Чат-застосунки іноді тихо відкидають найстаріші повідомлення; API не робить цього за вас.)
Скажімо, ви спілкуєтеся з асистентом підтримки протягом 30 кроків. Припустімо, системний промпт на 400 токенів, 150 токенів на запитання і 450 на відповідь, тож кожен обмін додає 600 токенів до історії.
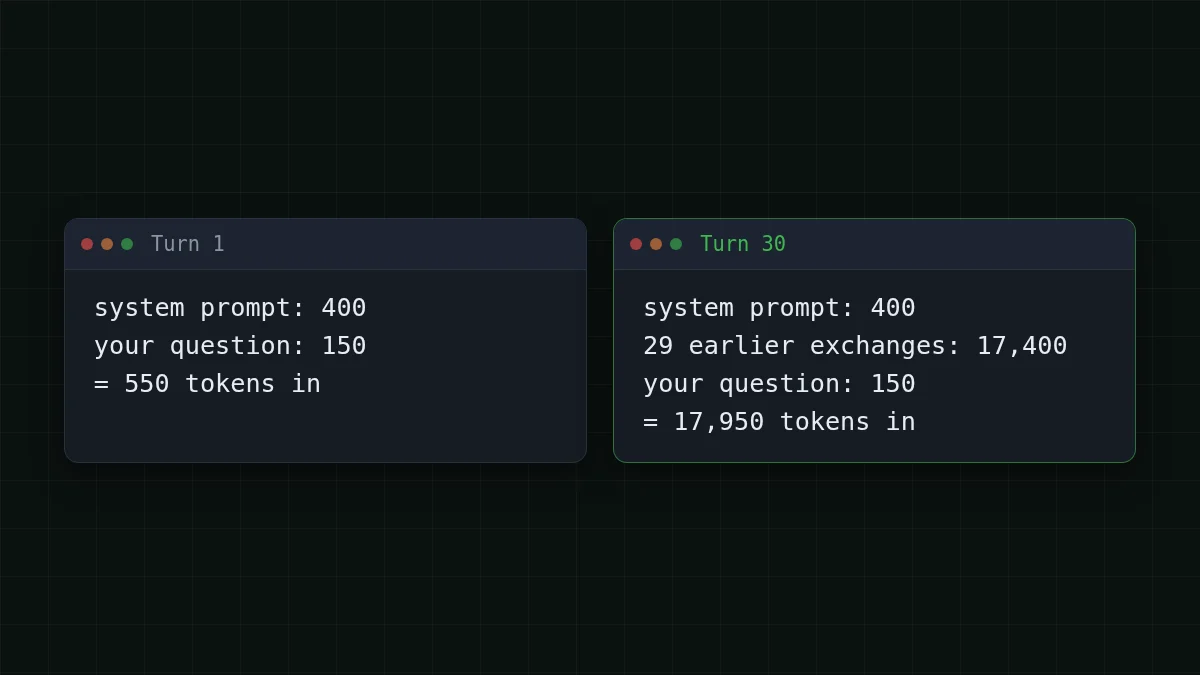
Крок 1 надсилає близько 550 токенів. Крок 30 надсилає 400 + 150 + 29 × 600 = 17 950. Якщо підсумувати за весь чат, кожен крок несе 550 токенів свого початку, тож 30 × 550 = 16 500. До того ж крок n повторно надсилає n − 1 попередніх обмінів по 600 токенів кожен: 600 × 435 = 261 000, де 435 = 1 + 2 + … + 29. Вхід усього чату становить 16 500 + 261 000 = 277 500 токенів, а відповіді додають 30 × 450 = 13 500.
На DeepSeek-V4-Flash весь цей чат коштує $0.0055. Ось усі три моделі, поруч із ними довідкова ціна OpenRouter; якщо рахувати вхід і вихід разом, кожна дешевша за OpenRouter для цього чату:
| Модель | Вхід $/1М | Вихід $/1М | Вартість | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277 500 вхідних і 13 500 вихідних токенів загалом. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
У середньому цей чат становить 277 500 ÷ 30 = 9 250 токенів на запит і 450 на вихід.
Хочете свій чат? Змініть числа нижче, наприклад на 100 кроків, і подивіться, як швидко зростає підсумок.
Калькулятор вартості
Той самий 30-кроковий чат, у середньому
Вхідні токени на запит: 9 250 · Вихідні токени на запит: 450 · Запитів на день: 30
| Модель | За день | За місяць |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Тепер чесна частина. 17 950 токенів — це менше ніж 5% вікна 380K, тож звичайний чат рідко впирається в стіну. Зростає рахунок і шум. Документація Anthropic зазначає, що точність і повнота відтворення погіршуються зі зростанням кількості токенів (вона називає це контекстним гниттям), тож більше вікно не обов'язково краще: те, що ви вкладаєте, має таке саме значення, як і те, скільки вміщується. Стіна з'являється в документах і агентах. В API самої Anthropic запит, вхід якого сам по собі більший за вікно, отримує помилку 400, промпт задовгий. Щодо витратної сторони того самого ефекту дивіться чому довгий чат AI коштує більше.
Чи вміститься мій документ?#
Грубе правило для англійського тексту: один токен — це приблизно ¾ слова, тож токени ≈ слова ÷ 0,75. Інші мови зазвичай потребують більше токенів на слово, тож залишайте додатковий запас. Спробуйте перед тим, як читати далі.
Вгадайте число
Скільки токенів у книзі на 90 000 слів?
Ваше припущення
0300 000
Показати відповідь
Відповідь: 120 000
Близько 120 000: 90 000 ÷ 0,75 = 120 000. Вона вміщується в будь-яке з трьох вікон із запасом.
Тепер більший випадок. Скажімо, у вас є архів листів підтримки на 150 000 слів, і ви хочете отримати підсумок: 150 000 ÷ 0,75 = 200 000 токенів. 200 000 токенів — це більше за вікно 180K, тож для цього архіву виберіть GLM-5.3-Flash (390K) або DeepSeek-V4-Flash (380K). DeepSeek-V4-Flash усе ще залишає 380 000 − 200 000 = 180 000 токенів місця на DeepSeek-V4-Flash, більш ніж достатньо для підсумку в межах його ліміту відповіді 32 768 токенів. Читання цих 200 000 токенів і написання підсумку на 2 000 токенів коштує $0.0032.
Менший випадок: звіт на 60 000 слів — це 60 000 ÷ 0,75 = 80 000 токенів. MiniMax-M2.7 впорається з ним із запасом 100K, що робить його вікно 180K достатнім для чатів і документів середнього розміру.
Три звички для майже заповненого вікна#
1. Підсумуйте й перезапустіть. На кроці 30 запит несе 17 950 токенів. Попросіть модель написати підсумок рішень на 200 токенів, а потім почніть новий чат із ним. Наступний запит — це 400 + 200 + 150 = 750 токенів на вході, і модель усе ще знає, що важливо.
2. Надсилайте лише потрібну частину. Вставляйте розділ, про який запитуєте, а не всю книгу; функцію, а не весь репозиторій. Менше на столі означає менший рахунок і, зважаючи на примітку Anthropic про контекстне гниття, модель, у якій менше можна загубитися.
3. Тримайте фіксовані частини ощадливими й стежте за usage. Системний промпт, визначення інструментів і довгі результати інструментів супроводжують кожен крок. Обрізайте те, що не використовуєте, друкуйте кількість токенів після кожної відповіді, як у циклі вище, і встановіть max_tokens на довжину, яка вам насправді потрібна.
Коли ви захочете спробувати це на справжній моделі, документація CheapTokens показує перший запит у кілька рядків, а сторінка цін перелічує актуальну ціну кожної моделі. Для довгих документів і циклів агентів DeepSeek-V4-Flash (контекст 380K, до 32 768 токенів виходу, одна фіксована ціна без пікових годин) і GLM-5.3-Flash (390K, найбільше вікно з трьох) — це ті, на які варто дивитися насамперед.


