Вирішення проблемПосібник
Запит задовгий: 400 проти 413, контекстне вікно та max_tokens
Відрізніть 413 (забагато байтів) від помилки довжини токенів (зазвичай 400), перевірте вхід плюс max_tokens щодо контекстного вікна та зменште запит.
На цій сторінці
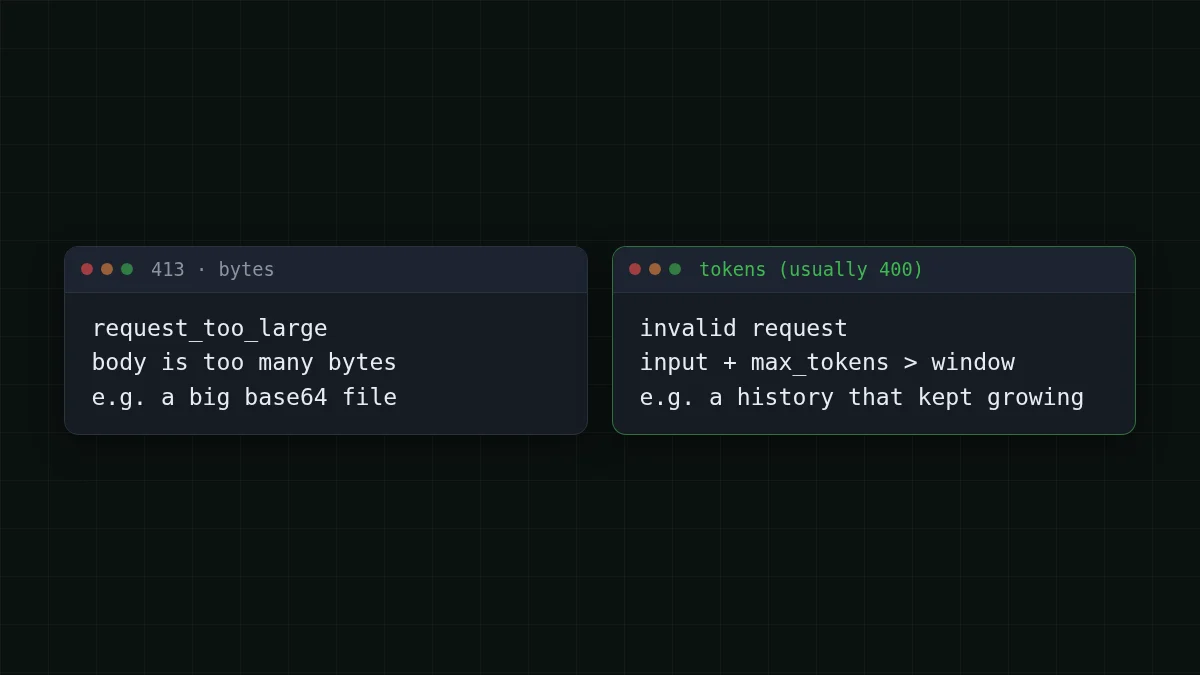
Ваш чат працював справно сорок ходів, а потім кожен запит почав падати. Коротка відповідь: «запит задовгий» приховує два різні обмеження. 413 означає, що запит завеликий у байтах і був відхилений ще до того, як його побачила модель. Якщо помилка скаржиться на довжину в токенах (зазвичай це невалідний запит класу 400), ваш вхід плюс відповідь, яку ви просите, не вміщуються в контекстне вікно; прочитайте error.message, щоб побачити, яке саме. Виправлення — виміряти, а потім скоротити.
Цей посібник показує, як розрізнити ці два випадки, як перевірити математику перед відправленням і чотири способи зменшити запит. Якщо термін новий, що таке контекстне вікно пояснює його простими словами.
Два обмеження, дві помилки#
413 — це пошта, яка відмовляється прийняти завелику посилку; помилка токенів — це модель, яка каже, що лист не вміщується в її вікно читання. Вони виникають у різних місцях і потребують різних виправлень.
Сторінка помилок API Anthropic (перевірено 29 жовтня 2026) описує 413 request_ як запит, що перевищує максимальну кількість байтів: 128 МБ для Messages API, 256 МБ для Batch API, 500 МБ для Files API. 400 invalid_ охоплює проблеми з форматом або вмістом запиту. Це ліміти Anthropic. Їхня сторінка не наводить повідомлення про кількість токенів, як і посібник OpenAI з кодів помилок, тому не будуйте логіку на точному формулюванні, яке ви бачили в темі на форумі.
На практиці текстові чати зазвичай зростають у токенах задовго до байтів. Байти стають проблемою, коли ви прикріплюєте зображення в base64 або цілі документи. Токени стають проблемою, коли зростає історія, і це типовий випадок.
З'єднайте пари
Зіставте кожен симптом із його причиною
Торкніться елемента ліворуч, потім його пари
- 413 request_too_largeТіло запиту містить забагато байтів, наприклад велике вкладення в base64
- Помилка довжини токенів одразу після вставлення великого логуСам лише промпт містить більше токенів, ніж контекстне вікно
- 400 після промпту приблизно на 375K токенів із max_tokens=32768 на моделі з 380KРазом вони можуть перевищити вікно
- Та сама історія, інша модельПеревірте вікно кожної моделі: історія, що вміщується в одну, може не вміститися в іншу
Тіло помилки — це JSON із полем верхнього рівня type: error, об'єктом error із власними type та message і ідентифікатором запиту. Прочитайте error.message і збережіть ідентифікатор запиту; з офіційними SDK перехоплюйте типізований виняток замість зіставлення рядків.
Перевірте математику перед відправленням#
Звичка, яка економить найбільше часу: не чекайте на помилку. Перед кожним викликом додайте три речі й порівняйте їх із вікном.
- Токени у ваших повідомленнях (системний промпт, історія, нове запитання).
max_tokens, який ви просите.- Контекстне вікно моделі.
Тримайте вхід плюс запитану відповідь у межах вікна. Вікна на CheapTokens становлять 390K для GLM-5.3-Flash, 380K для DeepSeek-V4-Flash і 180K для MiniMax-M2.7; відповіді сягають до 8 192 токенів на GLM і MiniMax та до 32 768 на DeepSeek-V4-Flash. Перевірте сторінки цін і моделей для актуального списку.
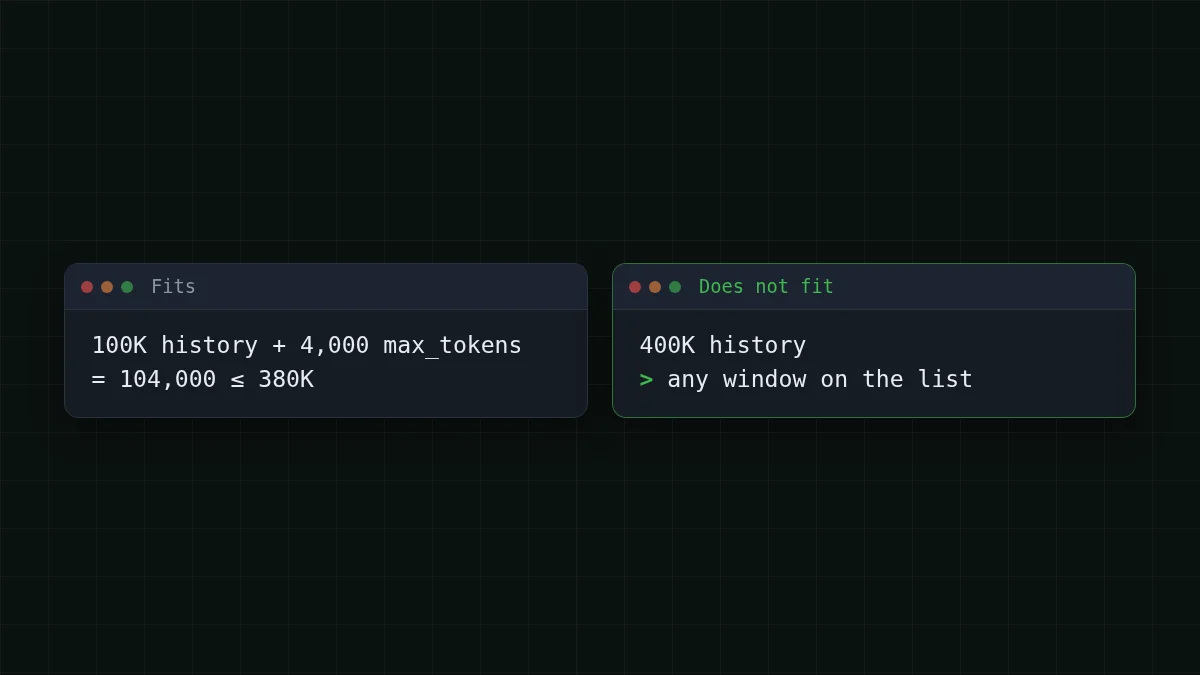
Скажімо, ваш агент надсилає історію на 100K токенів і просить 4 000 токенів у відповідь. Це 100 000 + 4 000 = 104 000 токенів, комфортно на будь-якій із трьох. Тепер той самий агент після ще п'ятдесяти кроків: 400K. Жодне вікно зі списку не вмістить це, який би max_tokens ви не встановили. Це момент, коли з'являється помилка, і вона здається раптовою лише тому, що історія зростала потроху з кожним ходом.
Приблизного лічильника достатньо для запобіжника. Англійський текст у середньому має близько 4 символів на токен; код і неанглійський текст використовують більше токенів на символ, тому залишайте запас:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Останній рядок — ваше калібрування: usage. — це те, що API фактично порахував. Порівняйте його з rough_ кілька разів і скоригуйте дільник і запас під ваш власний текст.
Чотири способи зменшити запит#
Виберіть найдешевше виправлення, яке працює, у такому порядку.
1. Зменште max_tokens. Просить лише ту відповідь, яка вам потрібна: вхід плюс max_tokens — це те, що ви маєте тримати в межах вікна, і кожна модель має власний ліміт на відповідь (8 192 або 32 768 токенів вище). Не встановлюйте max_tokens більше, ніж потрібно для відповіді, і не вище ліміту моделі на відповіді. Якщо відповідь обривається на встановленому ліміті, вона закінчується на finish_, що має власне виправлення.
2. Обріжте історію. Відкиньте найстаріші ходи, залиште системний промпт і останні кілька обмінів. Функція trim вище робить саме це. Для агента також скоротіть обсяг: виводи інструментів на 5 000 рядків рідко потрібно зберігати повністю після того, як агент їх використав.
3. Підсумуйте замість відкидання. Коли старі ходи важливі, попросіть модель один раз стиснути їх у коротку нотатку, а потім замініть старі повідомлення цією нотаткою. Ви платите за один додатковий виклик і зберігаєте нитку розмови.
4. Перейдіть на більше вікно. Перехід від MiniMax-M2.7 (180K) до GLM-5.3-Flash (390K) або DeepSeek-V4-Flash (380K) — це зміна ідентифікатора моделі в одному рядку. Якщо вам також потрібні довгі відповіді, DeepSeek-V4-Flash дозволяє до 32 768 вихідних токенів, і всі три мають спільний баланс, тож перемикання нічого не коштує в налаштуванні.
Чек-лист
Перед повторним надсиланням невдалого запиту
Скільки коштує довга історія#
Обрізання — це не лише про помилки. Кожен крок агента повторно надсилає всю історію, тому роздута історія — це також дорога частина рахунку. Візьміть завдання на 30 кроків, де кожен крок надсилає близько 100K токенів і отримує близько 1 500 у відповідь:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 30 запитів | OpenRouter, 30 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100 000 вхідних і 1 500 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Таблиця оцінює те саме завдання на кожній моделі за поточними тарифами. Скоротіть історію до чверті — і вхідна частина впаде приблизно на три чверті. Щоб побачити, де ваш власний агент витрачає токени, відстежуйте використання на запит у Python; щодо механіки, чому агенти використовують так багато токенів розбирає приклад на 20 кроків.
DeepSeek-V4-Flash наразі коштує $0.015 за 1M вхідних токенів і $0.10 за 1M вихідних токенів, одна ціна в будь-яку годину. Спробуйте свої цифри:
Калькулятор вартості
Завдання агента на 30 кроків з історією 100K
Вхідні токени на запит: 100 000 · Вихідні токени на запит: 1 500 · Запитів на день: 30
| Модель | За день | За місяць |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Якщо все ще не працює#
Довгі запити через повільне з'єднання мають окрему проблему: Anthropic радить потокову передачу або Batch API для довгих запитів із великим max_tokens, оскільки мережі можуть розривати неактивні з'єднання, а його SDK очікують, що не потокові запити завершаться протягом 10 хвилин. Якщо помилка — це тайм-аут або розірване з'єднання, а не 400, дивіться помилки з'єднання і встановіть stream=True.
Якщо повідомлення — 401 або 404, проблема в ключі, базовій URL-адресі або ідентифікаторі моделі: помилка API 401 або 404. Щоб отримати точну базову URL-адресу, ідентифікатори моделей і приклади, відкрийте документацію CheapTokens.


