DépannageGuide
Requête trop longue : 400 vs 413, fenêtre de contexte et max_tokens
Distinguez un 413 (trop d'octets) d'une erreur de longueur de tokens (généralement un 400), vérifiez l'entrée plus max_tokens par rapport à la fenêtre de contexte, et réduisez la requête.
Sur cette page
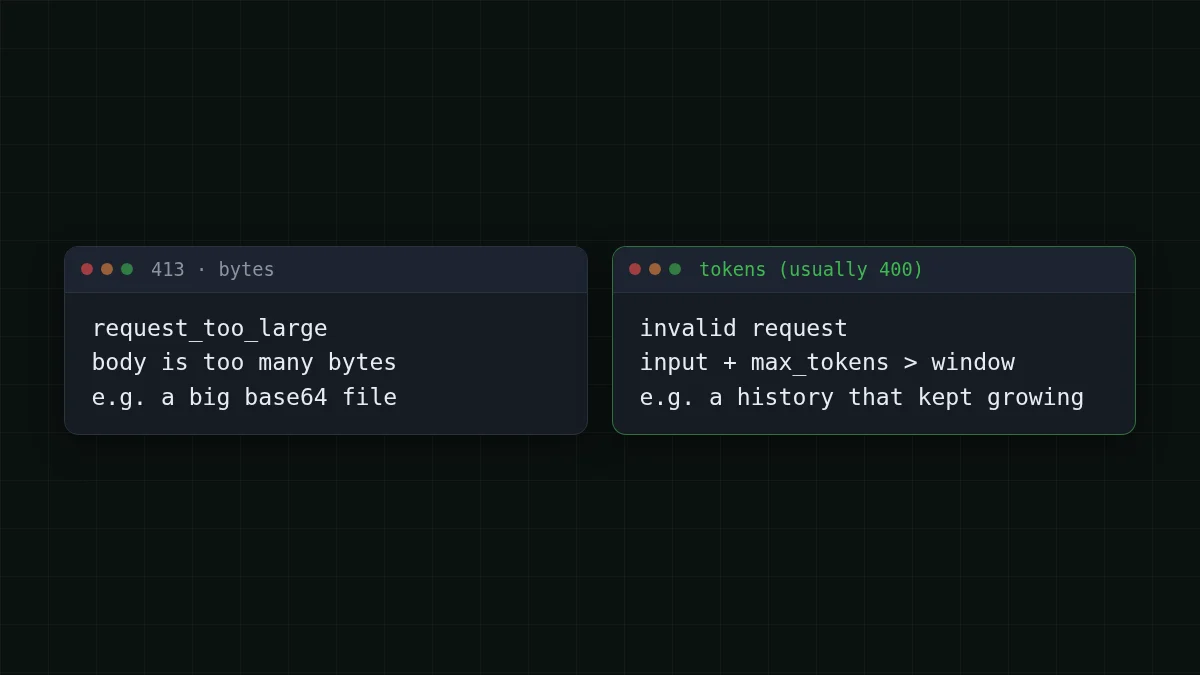
Votre conversation a bien fonctionné pendant quarante tours, puis chaque requête a commencé à échouer. La réponse courte : « request too long » masque deux limites différentes. Un 413 signifie que la requête est trop volumineuse en octets et a été rejetée avant qu'aucun modèle ne la voie. Si l'erreur se plaint de la longueur en tokens (généralement une requête invalide de classe 400), votre entrée plus la réponse demandée ne tient pas dans la fenêtre de contexte ; lisez error.message pour savoir laquelle. La solution est de mesurer, puis de réduire.
Ce guide montre comment distinguer les deux, comment vérifier le calcul avant d'envoyer, et quatre façons de réduire une requête. Si le terme est nouveau, what a context window is le couvre en termes simples.
Deux limites, deux erreurs#
Un 413, c'est le bureau de poste qui refuse un colis trop gros ; une erreur de tokens, c'est le modèle qui dit que la lettre ne tiendra pas dans sa fenêtre de lecture. Elles échouent à des endroits différents et nécessitent des corrections différentes.
La page des erreurs de l'API d'Anthropic (vérifiée le 29 octobre 2026) décrit 413 request_ comme une requête qui dépasse le nombre maximal d'octets : 128 Mo pour la Messages API, 256 Mo pour la Batch API, 500 Mo pour la Files API. Un 400 invalid_ couvre les problèmes de format ou de contenu de la requête. Ce sont les limites d'Anthropic. Leur page ne liste pas de message de comptage de tokens, et le guide des codes d'erreur d'OpenAI non plus, donc ne construisez pas de logique sur la formulation exacte que vous avez vue dans un fil de forum.
En pratique, les conversations en texte seul dépassent généralement les tokens bien avant les octets. Les octets deviennent le problème quand vous joignez des images en base64 ou des documents entiers. Les tokens deviennent le problème quand l'historique grandit, et c'est le cas courant.
Associer les paires
Associez chaque symptôme à sa cause
Touchez un élément à gauche, puis sa paire
- 413 request_too_largeLe corps contient trop d'octets, par exemple une grosse pièce jointe base64
- Une erreur de longueur de tokens juste après avoir collé un énorme journalLe prompt seul dépasse en tokens la fenêtre de contexte
- 400 après un prompt d'environ 375K tokens avec max_tokens=32768 sur un modèle à 380KEnsemble, ils peuvent dépasser la fenêtre
- Même historique, modèle différentVérifiez la fenêtre de chaque modèle : un historique qui tient dans l'un peut ne pas tenir dans l'autre
Le corps de l'erreur est du JSON avec un type: error de premier niveau, un objet error avec ses propres type et message, et un identifiant de requête. Lisez error.message et conservez l'identifiant de requête ; avec les SDK officiels, interceptez l'exception typée au lieu de comparer des chaînes.
Vérifiez le calcul avant d'envoyer#
L'habitude qui fait gagner le plus de temps : n'attendez pas l'erreur. Avant chaque appel, additionnez trois choses et comparez-les à la fenêtre.
- Les tokens de vos messages (prompt système, historique, la nouvelle question).
- Le
max_tokensque vous demandez. - La fenêtre de contexte du modèle.
Gardez l'entrée plus la réponse demandée à l'intérieur de la fenêtre. Les fenêtres sur CheapTokens sont de 390K pour GLM-5.3-Flash, 380K pour DeepSeek-V4-Flash et 180K pour MiniMax-M2.7 ; les réponses vont jusqu'à 8 192 tokens sur GLM et MiniMax et jusqu'à 32 768 sur DeepSeek-V4-Flash. Consultez pricing and model pages pour la liste actuelle.
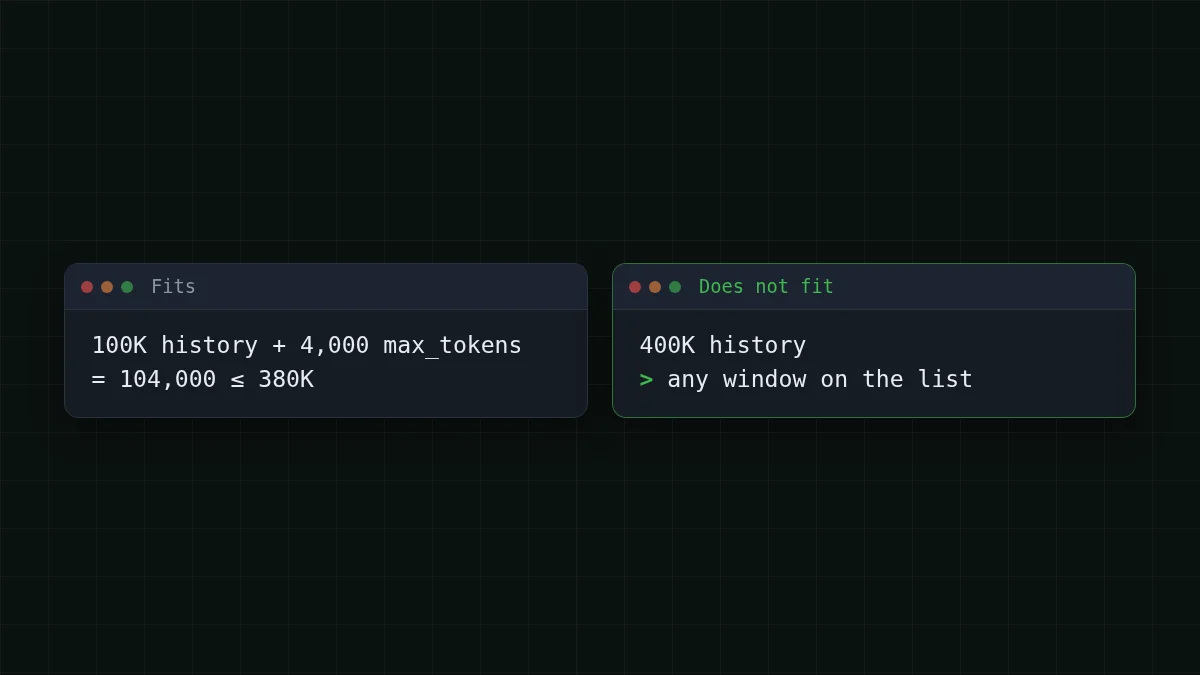
Supposons que votre agent envoie un historique de 100K tokens et demande 4 000 tokens en retour. Cela fait 100 000 + 4 000 = 104 000 tokens, confortable sur n'importe lequel des trois. Maintenant le même agent après cinquante étapes de plus : 400K. Aucune fenêtre de la liste ne l'accepte, quel que soit le max_tokens que vous définissez. C'est le moment où l'erreur apparaît, et elle ne semble soudaine que parce que l'historique a grandi un peu à chaque tour.
Un compteur approximatif suffit pour une garde. Le texte anglais fait en moyenne environ 4 caractères par token ; le code et le texte non anglais utilisent plus de tokens par caractère, alors laissez une marge :
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
La dernière ligne est votre calibration : usage. est ce que l'API a réellement compté. Comparez-le avec rough_ plusieurs fois et ajustez le diviseur et la marge à votre propre texte.
Quatre façons de réduire une requête#
Choisissez la correction la moins coûteuse qui fonctionne, dans cet ordre.
1. Réduisez max_tokens. Ne demandez que la réponse dont vous avez besoin : l'entrée plus max_tokens est ce que vous devez garder dans la fenêtre, et chaque modèle a son propre plafond sur la réponse (8 192 ou 32 768 tokens ci-dessus). Ne définissez pas max_tokens plus haut que ce dont la réponse a besoin, ni au-dessus du plafond de réponses du modèle. Si la réponse s'arrête à la limite que vous avez fixée, elle se termine par finish_, qui has its own fix.
2. Réduisez l'historique. Supprimez les tours les plus anciens, gardez le prompt système et les derniers échanges. La fonction trim ci-dessus fait exactement cela. Pour un agent, coupez aussi le volume : des sorties d'outils de 5 000 lignes ont rarement besoin de rester en entier après que l'agent les a utilisées.
3. Résumez au lieu de supprimer. Quand les anciens tours comptent, demandez une fois au modèle de les compresser en une courte note, puis remplacez les anciens messages par cette note. Vous payez un appel supplémentaire et conservez le fil.
4. Passez à une fenêtre plus grande. Passer de MiniMax-M2.7 (180K) à GLM-5.3-Flash (390K) ou DeepSeek-V4-Flash (380K) est un changement d'une ligne de l'identifiant de modèle. Si vous avez aussi besoin de réponses longues, DeepSeek-V4-Flash autorise jusqu'à 32 768 tokens de sortie, et les trois partagent un seul solde, donc changer ne coûte rien en configuration.
Liste de contrôle
Avant de renvoyer une requête échouée
Ce que coûte un long historique#
Réduire ne concerne pas seulement les erreurs. Chaque étape d'un agent renvoie tout l'historique, donc un historique gonflé est aussi la partie coûteuse de la facture. Prenons une tâche de 30 étapes où chaque étape envoie environ 100K tokens et reçoit environ 1 500 en retour :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 30 requêtes | OpenRouter, 30 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100 000 tokens d'entrée et 1 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Le tableau chiffre cette même tâche sur chaque modèle avec les tarifs en vigueur. Réduisez l'historique au quart et le côté entrée baisse d'environ trois quarts. Pour voir où votre propre agent dépense des tokens, track usage per request in Python ; pour les mécanismes, why agents use so many tokens parcourt un exemple de 20 étapes.
DeepSeek-V4-Flash coûte actuellement $0.015 par 1M de tokens d'entrée et $0.10 par 1M de tokens de sortie, un seul prix à toute heure. Essayez vos propres chiffres :
Calculateur de coût
A 30-step agent task with a 100K history
Tokens d'entrée par requête: 100 000 · Tokens de sortie par requête: 1 500 · Requêtes par jour: 30
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Si cela échoue encore#
Les requêtes longues sur une liaison lente ont une défaillance distincte : Anthropic conseille le streaming ou la Batch API pour les requêtes longues avec un grand max_tokens, car les réseaux peuvent couper les connexions inactives, et ses SDK attendent que les requêtes non-streaming se terminent en 10 minutes. Si l'erreur est un timeout ou une connexion coupée plutôt qu'un 400, voir connection errors et définissez stream=True.
Si le message est un 401 ou un 404, le problème vient plutôt de la clé, de l'URL de base ou de l'identifiant de modèle : API 401 or 404 error. Pour l'URL de base exacte, les identifiants de modèles et des exemples, ouvrez la CheapTokens docs.


