Modèles & comparaisonsComparaison
GPT-6.1 Terra vs Sol vs Luna pour le code : coût par tâche
Terra, Sol ou Luna pour le code ? Une tâche chiffrée sur les trois niveaux OpenAI, une méthode pour choisir où commencer, et quand un modèle moins cher suffit.
Sur cette page
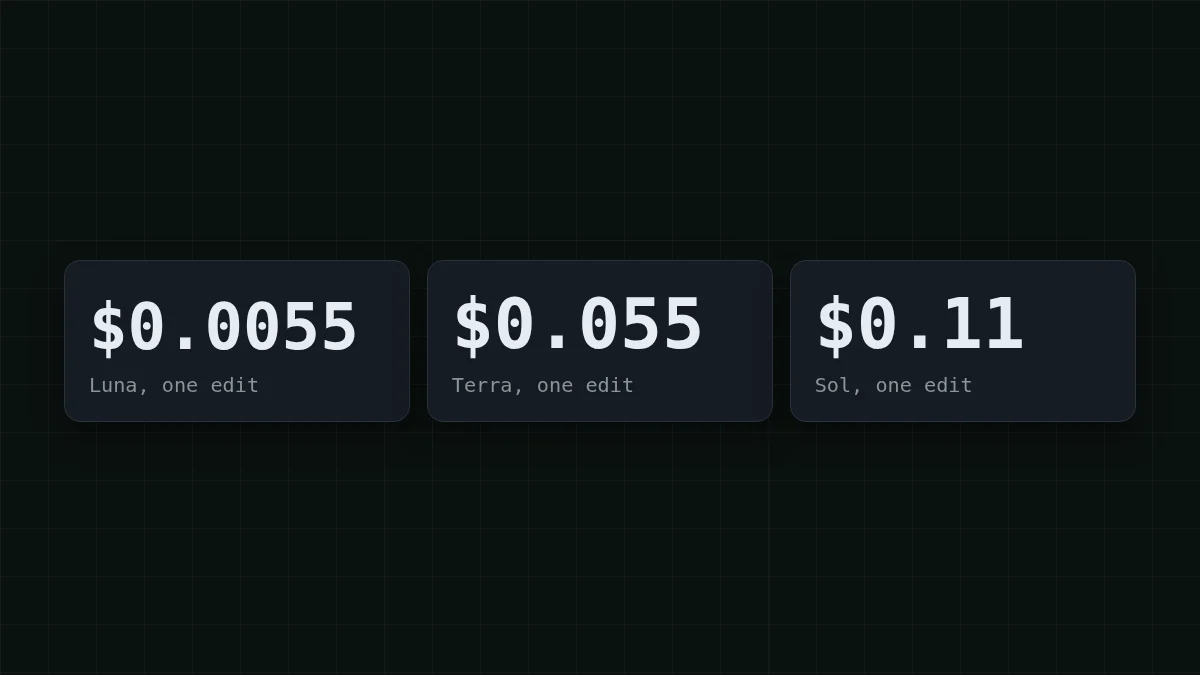
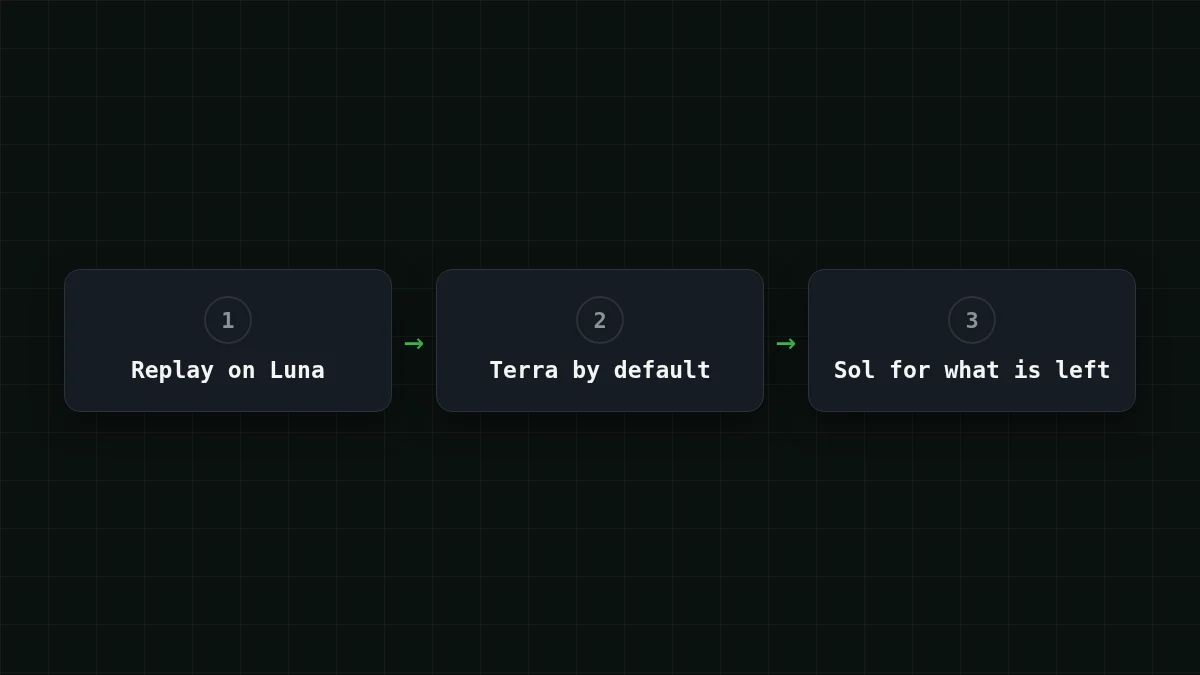
Votre session d'agent est terminée, le diff est correct, et vous vous demandez maintenant si le niveau le plus cher était nécessaire. Réponse courte : commencez sur Terra, envoyez les étapes simples en masse sur Luna, et ne payez Sol que pour la tâche que Terra a déjà ratée. Sur une modification identique (40 000 tokens en entrée, 3 000 en sortie), les prix standard OpenAI donnent 0,0055 $ sur Luna, 0,055 $ sur Terra et 0,11 $ sur Sol.
Ce que dit la grille tarifaire#
La page de tarification d'OpenAI (consultée le 29 octobre 2026, niveau standard, entrée jusqu'à 272K tokens) affiche ces prix par million de tokens :
Faites défiler le tableau vers la droite →
| Niveau | Entrée | Entrée en cache | Sortie | Une modification : 40K en entrée, 3K en sortie |
|---|---|---|---|---|
GPT-6 Luna (gpt-6-luna) |
0,10 $ | 0,01 $ | 0,50 $ | 0,0055 $ |
GPT-6.1 Terra (gpt-6.1-terra) |
1,00 $ | 0,05 $ | 5,00 $ | 0,055 $ |
GPT-6.1 Sol (gpt-6.1-sol) |
2,00 $ | 0,10 $ | 10,00 $ | 0,11 $ |
Le schéma est net. Sol vaut exactement le double de Terra sur chaque colonne. Luna représente un dixième de Terra en entrée et en sortie, et un cinquième en entrée en cache. L'échelle des coûts est donc fixe, et la vraie question est la fréquence à laquelle un échelon moins cher suffit.
La dernière colonne est de l'arithmétique simple. Sur Terra : 40 000 × 1,00 / 1 000 000 = 0,04 pour l'entrée et 3 000 × 5,00 / 1 000 000 = 0,015 pour la sortie, donc 0,04 + 0,015 = 0,055. Sur Sol, le même calcul donne 0,08 + 0,03 = 0,11, sur Luna 0,004 + 0,0015 = 0,0055.
Une modification, puis cinquante#
Disons que vous faites 50 modifications de ce type par jour : réécrire une fonction, corriger les tests qu'elle a cassés, environ 40 000 tokens de fichiers et d'instructions en entrée et 3 000 tokens de patch et d'explication en sortie. Une journée coûte alors 50 × 0,055 = 2,75 dollars sur Terra, 50 × 0,11 = 5,50 sur Sol et 50 × 0,0055 = 0,275 sur Luna.
Personne ne ressent 0,11 $ sur une modification. Un mois de Sol à ce rythme, c'est une autre conversation, et c'est la raison de choisir le niveau une fois par type de tâche plutôt qu'une fois par humeur.
Voici tout le calcul en quelques lignes que vous pouvez coller et relancer avec vos propres nombres de tokens (prix d'exemple du tableau ci-dessus, remplacez-les par les prix actuels) :
PRICES = {  # $ per 1M tokens: (input, output), OpenAI, 29 Oct 2026
    'luna': (0.10, 0.50),
    'terra': (1.00, 5.00),
    'sol': (2.00, 10.00),
}

def cost(tier, tokens_in, tokens_out):
    p_in, p_out = PRICES[tier]
    return (tokens_in * p_in + tokens_out * p_out) / 1_000_000

print(cost('terra', 40_000, 3_000))  # 0.055
Boucles d'agent : l'entrée fait la facture#
Une modification, c'est une requête. Un agent, c'est vingt requêtes d'affilée, et chaque étape relit les fichiers et l'historique accumulé. Prenons une boucle de 20 étapes où chaque étape envoie environ 30 000 tokens et en reçoit environ 1 000. Cela fait 600 000 tokens en entrée et 20 000 en sortie.
Sur Terra : 600 000 × 1,00 / 1 000 000 = 0,60 pour l'entrée et 20 000 × 5,00 / 1 000 000 = 0,10 pour la sortie, donc 0,60 + 0,10 = 0,70 dollar. Sol double à 1,40, Luna réduit à 0,07. Regardez la répartition : 0,60 $ sur les 0,70 $ correspondent à ce que vous envoyez, pas à ce que le modèle écrit. C'est l'inverse de ce que la plupart des gens imaginent.
Le cache change la donne, si votre préfixe se répète vraiment. Supposons que 25 000 des 30 000 tokens de chaque étape soient le même préfixe et touchent le cache : 100 000 × 1,00 / 1 000 000 = 0,10 d'entrée fraîche, 500 000 × 0,05 / 1 000 000 = 0,025 d'entrée en cache, plus 0,10 de sortie, donc Terra arrive à 0,10 + 0,025 + 0,10 = 0,225. Le fonctionnement est décrit dans qu'est-ce que le prompt caching ; la raison pour laquelle l'historique ne cesse de grossir est dans pourquoi les agents IA utilisent autant de tokens.
Le calculateur ci-dessous exécute la même boucle sur les modèles CheapTokens. Modifiez les étapes et les tokens pour correspondre à votre agent.
Calculateur de coût
La même boucle de 20 étapes sur les modèles CheapTokens
Tokens d'entrée par requête: 30 000 · Tokens de sortie par requête: 1 000 · Requêtes par jour: 20
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0128 | $0.384 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.011 | $0.33 |
| MiniMax-M2.7$0.05$0.15 | $0.033 | $0.99 |
Quel niveau pour quelle tâche#
Un auteur de chaîne Telegram, qui mène des expériences sur l'IA, a comparé Terra avec Sol et Luna dans Codex et publié une vidéo le 28 octobre 2026. Sa conclusion, dans son propre titre, est que Terra est un niveau intermédiaire et que ce n'est pas un défaut (la publication). Ce cadrage est un bon repère : l'échelon du milieu est la valeur par défaut, et les deux autres exigent une raison.
La raison, ce sont généralement les nouvelles tentatives. À nombre de tokens égal, deux tentatives Terra coûtent 2 × 0,055 = 0,11, soit une tentative Sol. Et dix tentatives Luna coûtent 10 × 0,0055 = 0,055, soit une tentative Terra. Donc si Sol est le seul niveau qui réussit une classe de tâches du premier coup, il se rentabilise sur ces tâches. Si Luna réussit une classe de tâches plus d'une fois sur dix, c'est le moyen le moins cher de les obtenir, avant même de compter le temps passé à examiner les échecs.
Choisissez la situation la plus proche de la vôtre :
Choisissez votre cas
Sur quel niveau commencez-vous ?
Choisissez une option pour voir la réponse
Des milliers de petites étapes
Messages de commit, classification de tickets, courtes explications de code. Commencez sur Luna : le coût par étape est un dixième de celui de Terra, donc tout taux d'échec qui n'est pas extrême reste moins cher. Montez d'un niveau uniquement pour le type d'étape qui échoue sans cesse.
Modifications et refactorisations quotidiennes
Commencez sur Terra et restez-y. C'est l'échelon du milieu de la grille tarifaire, et une modification à 40K en entrée et 3K en sortie coûte 0,055 $. Ne regardez Sol qu'après deux échecs de Terra sur le même type de tâche.
Une tâche que Terra a déjà ratée
Essayez Sol une fois avec le même prompt. À tokens égaux, cela coûte le même prix que la deuxième tentative Terra aurait coûté, et vous apprenez si le niveau supplémentaire est ce dont la tâche a besoin.
Une longue boucle d'agent
La facture est dominée par l'entrée, donc réduisez d'abord ce que chaque étape renvoie et gardez le préfixe stable pour le cache. Choisissez le niveau après, pas avant.
Quand un modèle open-weight moins cher suffit#
La même modification sur les trois niveaux OpenAI à côté de trois modèles CheapTokens, avec les mêmes 40 000 tokens en entrée et 3 000 en sortie :
Les barres montrent le prix, pas les résultats. Savoir si l'un de ces modèles est assez bon pour vos modifications se vérifie de la même façon que pour Luna : rejouez de vraies tâches et lisez les diffs. S'il passe, la facture baisse encore. Pour les boucles d'agent, DeepSeek-V4-Flash dispose d'un contexte de 380K, de jusqu'à 32 768 tokens dans une réponse et d'un prix unique à toute heure de la journée. GLM-5.3-Flash a un contexte de 390K et MiniMax-M2.7 de 180K ; tous les prix sont sur la page de tarification, et les étapes de connexion sont dans la documentation.
Rejouez vos propres tâches#
Le tableau vous donne le coût. La qualité, vous la découvrez en un après-midi : prenez dix tâches de votre historique récent, exécutez chacune sur Luna, puis sur Terra, et comparez les diffs côte à côte. Les seuls chiffres dont vous avez besoin sont dans la réponse, dans le champ usage, ce qui permet de chiffrer une exécution exactement. Avec CheapTokens, cela ressemble à ceci :
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Rename the variable x to retry_count in this function: ..."}]}'
Dans le JSON renvoyé, usage. et usage. sont votre entrée et votre sortie pour cette tâche. Passez-les au helper cost() ci-dessus, et vous obtenez le coût par tâche pour tout modèle ayant un prix. Pour les détails de lancement du nouveau niveau, voir prix de l'API GPT-6.1 Terra ; pour la répartition entrée/sortie, tokens d'entrée vs de sortie.
Vérification rapide
Vous exécutez la même tâche sur Terra et sur Sol avec des nombres de tokens identiques. Que vous dit la grille tarifaire à elle seule ?
Afficher la réponse
Réponse: Sol coûte exactement deux fois plus cher, car chaque prix de sa ligne est le double de celui de Terra
L'entrée, l'entrée en cache et la sortie sont chacune à 2× sur Sol, donc la facture est à 2× quel que soit le mélange. Savoir si l'argent supplémentaire achète un meilleur résultat, c'est la partie que seul votre replay peut montrer.


