Modèles & comparaisonsComparaison
Modèle API OpenAI le moins cher en 2026 : gpt-5-nano vs gpt-6-luna
Les modèles API OpenAI les moins chers avec les prix officiels vérifiés le 28 oct. 2026, et ce que coûtent les mêmes 1 000 requêtes sur des modèles à poids ouverts.
Sur cette page
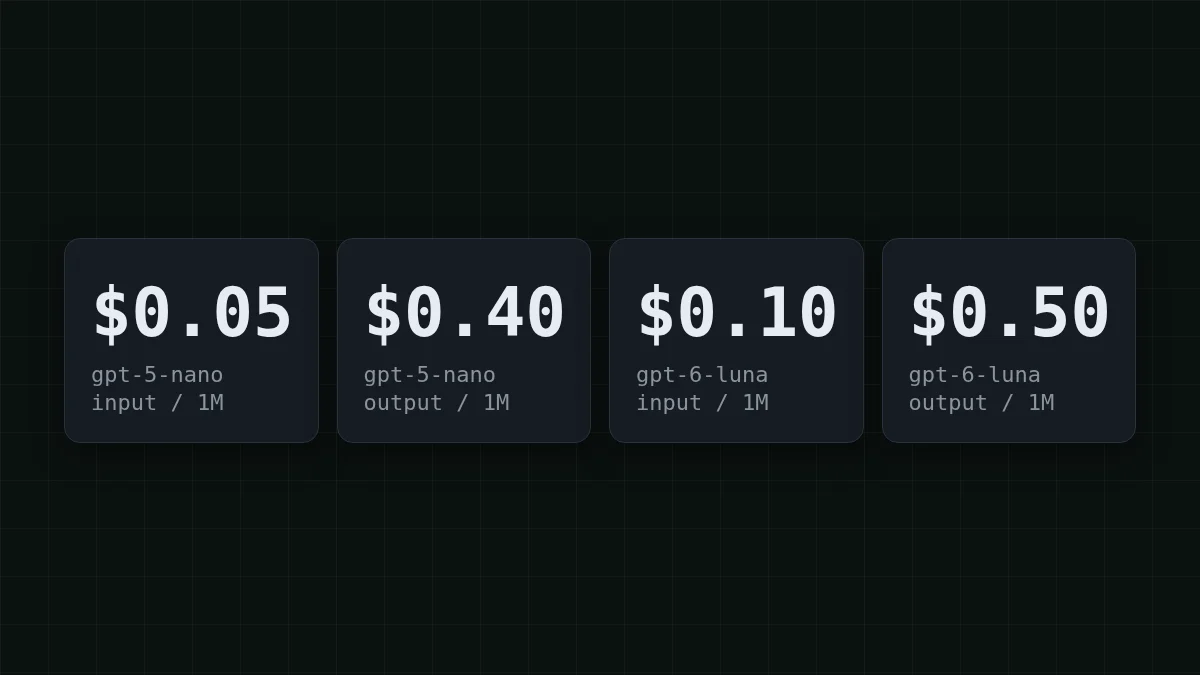
Le modèle texte OpenAI le moins cher sur sa page tarifaire est gpt-5-nano : $0.05 par 1M de tokens d'entrée et $0.40 par 1M de tokens de sortie. Dans la gamme GPT-6 plus récente, le moins cher est gpt-6-luna à $0.10 en entrée et $0.50 en sortie. Ces chiffres proviennent de la page tarifaire d'OpenAI, vérifiée le 28 octobre 2026. La page n'indique aucune date de publication, c'est donc la date de vérification qui fait foi.
Mais un prix bas par token n'est pas la même chose qu'un prix bas par tâche. Pour les petits volumes à forte fréquence, les modèles à poids ouverts sur CheapTokens, comme GLM-5.3-Flash et DeepSeek-V4-Flash, reviennent moins cher au total. Ci-dessous, vous le voyez sur une tâche concrète, puis vous pouvez y mettre vos propres chiffres.
L'échelle tarifaire OpenAI, par le bas#
Tous les prix sont par 1M de tokens, palier standard, contexte court (jusqu'à 272K tokens d'entrée). La dernière colonne est un calcul pour une tâche concrète : 1 000 requêtes, chacune avec 500 tokens d'entrée et 200 de sortie. Pensez à un bot de support qui étiquette des tickets.
Faites défiler le tableau vers la droite →
| Modèle | Entrée | Sortie | Entrée en cache | 1 000 requêtes (500 in / 200 out) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
Deux choses ressortent. Premièrement, gpt-5-nano a le prix d'entrée le plus bas et égale gpt-4.1-nano en sortie, donc si vous restez chez OpenAI et que la tâche est simple, c'est le point de départ. Deuxièmement, gpt-4o-mini, que beaucoup de projets ont choisi comme modèle bon marché, coûte désormais plus cher que gpt-5-nano en entrée comme en sortie. Si c'est votre modèle, vous avez une option moins chère sans quitter OpenAI.
Au-dessus du tableau se trouvent gpt-4.1-mini ($0.40 / $1.60) et gpt-5.4-mini ($0.75 / $4.50). Des paliers plus élevés pour comparer : gpt-6.1-terra à $1 / $5 (nous l'avons traité dans GPT-6.1 Terra API price), gpt-6.1-sol à $2 / $10 et gpt-6-astra à $10 / $50. Une mise en garde issue de la même page : les endpoints de traitement régional appliquent une majoration de 10 % pour les modèles publiés le 5 mars 2026 ou après. La page ne liste que les prix, donc vérifiez la page de chaque modèle pour la taille de contexte et les limites avant de déplacer une tâche.
Où va l'argent sur 1 000 petites requêtes#
Prenez le bot d'étiquetage de tickets. Chaque requête envoie environ 500 tokens (l'instruction plus le ticket) et en reçoit environ 200 en retour. Sur gpt-5-nano, 1 000 de ces requêtes coûtent :
- Entrée : 0,5M de tokens × $0.05 = $0.025
- Sortie : 0,2M de tokens × $0.40 = $0.08
- Total : $0.025 + $0.08 = $0.105
Regardez la répartition. La réponse courte représente moins d'un tiers des tokens, mais elle pèse $0.08 sur les $0.105. C'est le piège quand on cherche un modèle bon marché : le prix de sortie décide plus souvent de la facture que le prix d'entrée. Pour la version longue de cette idée, input vs output tokens la détaille.
OpenAI indique aussi un tarif d'entrée en cache : $0.005 par 1M pour gpt-5-nano (le fonctionnement est expliqué dans what is prompt caching). Supposez que toute votre entrée de 500 tokens soit un prompt répété et passe en cache. L'entrée tombe à 0,5M × $0.005 = $0.0025, et la tâche coûte $0.0025 + $0.08 = $0.0825. La facture bouge à peine, car les 200 tokens de sortie coûtent toujours $0.08.
Essayez le même calcul à plus grande échelle :
Devinez le nombre
Un étiqueteur envoie 200 000 requêtes par jour à gpt-5-nano, chacune avec 500 tokens en entrée et 200 en sortie. Combien de dollars cela fait-il par jour ?
Votre estimation
0100
Afficher la réponse
Réponse: 21
$21. Entrée : 100M de tokens × $0.05 = $5. Sortie : 40M de tokens × $0.40 = $16. Total $5 + $16 = $21.
La même tâche sur des modèles à poids ouverts#
Maintenant les mêmes 1 000 requêtes de 500 en entrée et 200 en sortie, tarifées sur CheapTokens aux tarifs actuels :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 tokens d'entrée et 200 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
En chiffres : GLM-5.3-Flash prend $0.018, DeepSeek-V4-Flash $0.0275 et MiniMax-M2.7 $0.055. Comparez avec les $0.105 de gpt-5-nano. Le tableau est en direct, il suit donc la liste de prix actuelle. GLM-5.3-Flash a un contexte de 390K et répond jusqu'à 8 192 tokens, ce qui suffit largement pour une étiquette ou une réponse courte. DeepSeek-V4-Flash a un contexte de 380K et répond jusqu'à 32 768 tokens, ce qui compte quand la sortie est un rapport ou un long morceau de code. Les deux gardent un prix unique à toute heure, sans tarification de pointe.
Un autre scénario, un chatbot encore sur gpt-4o-mini. Supposez que chaque conversation envoie environ 1 200 tokens (historique plus la nouvelle question), en reçoit 250 en retour, et que vous servez 3 000 conversations par jour. Sur gpt-4o-mini, cela fait 3,6M de tokens d'entrée × $0.15 = $0.54 et 0,75M de tokens de sortie × $0.60 = $0.45, soit $0.99 par jour. Sur gpt-5-nano, la même journée coûte 3,6M × $0.05 = $0.18 plus 0,75M × $0.40 = $0.30, soit $0.48. Voici le même trafic sur CheapTokens ; modifiez les chiffres pour correspondre à votre bot :
Calculateur de coût
Une journée de chatbot : 3 000 conversations
Tokens d'entrée par requête: 1 200 · Tokens de sortie par requête: 250 · Requêtes par jour: 3 000
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
Basculer demande trois petits changements#
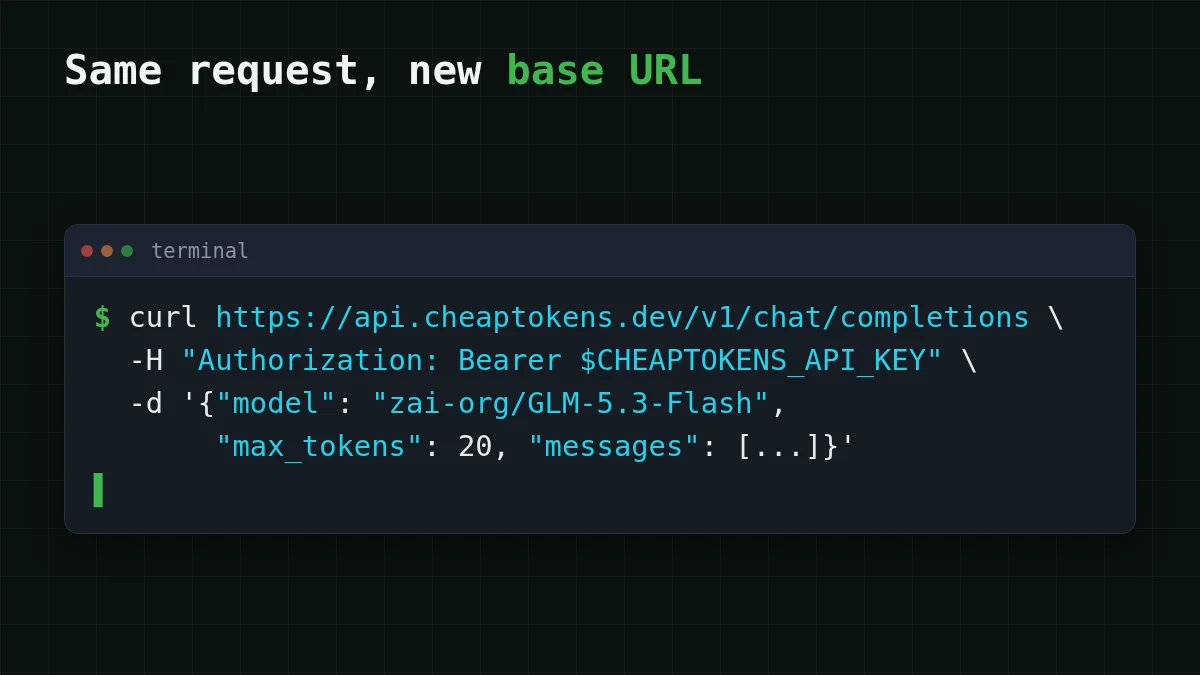
CheapTokens parle l'API OpenAI, donc le code que vous avez continue de fonctionner. Vous changez l'URL de base, la clé et l'id du modèle. Prenez l'id dans la documentation, car les fournisseurs nomment les modèles différemment. Pour GLM-5.3-Flash, c'est zai-, et l'URL de base est https:/.
Une requête d'étiquetage, deux façons
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Lancez-la sur 50 de vos vrais tickets et lisez les réponses vous-même. Le champ usage de chaque réponse donne les comptes exacts de tokens d'entrée et de sortie, et ces deux nombres sont tout ce dont le calculateur ci-dessus a besoin. Les clés, le solde et le premier appel sont dans your first API request.
Lequel pour quelle tâche#
Choisissez votre cas
Que faites-vous tourner ?
Choisissez une option pour voir la réponse
Étiquetage ou classification de textes courts
Réponses courtes, volume énorme. Sur OpenAI, gpt-5-nano est le moins cher. Sur CheapTokens, essayez GLM-5.3-Flash : contexte de 390K, jusqu'à 8 192 tokens de sortie, un prix unique à toute heure.
Réponses longues : rapports, brouillons, code
Essayez DeepSeek-V4-Flash. Il écrit jusqu'à 32 768 tokens en une réponse, et il a un contexte de 380K.
Une boucle d'agent ou un outil de codage
Essayez MiniMax-M2.7 ou DeepSeek-V4-Flash. Les deux partagent un solde avec les autres modèles, vous pouvez donc passer de l'un à l'autre sans nouveau compte.
Vous devez rester sur OpenAI
Utilisez gpt-5-nano pour le prix le plus bas, ou gpt-6-luna si vous voulez le modèle le moins cher de la gamme GPT-6. Si vous êtes sur gpt-4o-mini, gpt-5-nano est moins cher des deux côtés.
Quel que soit votre choix, testez-le sur vos propres exemples avant de déplacer toute la charge. Le tableau des prix vous dit ce que coûte un token ; seules vos données vous disent si les réponses sont assez bonnes. Les prix actuels de chaque modèle sont sur la page tarifaire, et how much AI tokens cost met côte à côte les budgets de 1M et 10M de tokens.


