Modelos e comparaçõesComparação
Modelo de API OpenAI mais barato em 2026: gpt-5-nano vs gpt-6-luna
Os modelos de API OpenAI mais baratos com preços oficiais verificados em 28 de outubro de 2026, e quanto custam as mesmas 1.000 requisições em modelos de pesos abertos.
Nesta página
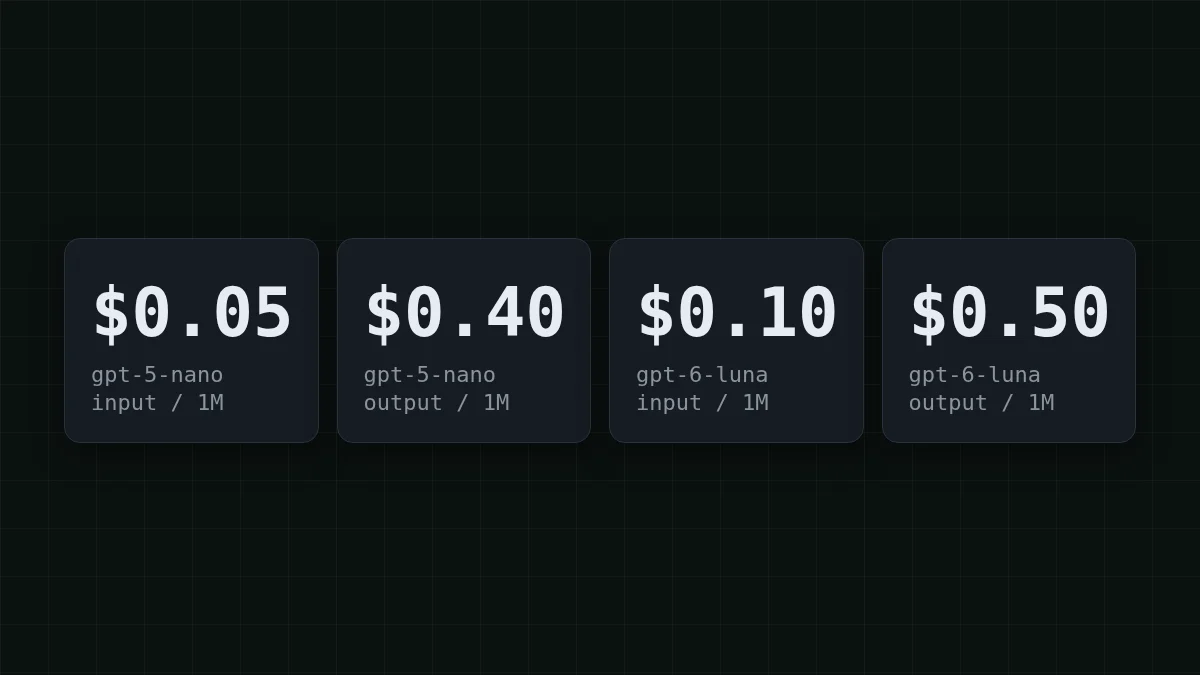
O modelo de texto OpenAI mais barato na página de preços é o gpt-5-nano: $0.05 por 1M de tokens de entrada e $0.40 por 1M de tokens de saída. Na linha mais recente GPT-6, o mais barato é o gpt-6-luna, a $0.10 de entrada e $0.50 de saída. Esses números vêm da página de preços da OpenAI, verificada em 28 de outubro de 2026. A página não traz data de publicação, então a data da verificação é a que vale.
Mas preço baixo por token não é o mesmo que preço baixo por tarefa. Para trabalhos pequenos e de alto volume, modelos de pesos abertos na CheapTokens, como GLM-5.3-Flash e DeepSeek-V4-Flash, saem mais baratos no total. Abaixo você vê isso em um trabalho concreto e depois encaixa seus próprios números.
A escada de preços da OpenAI, de baixo para cima#
Todos os preços são por 1M de tokens, nível padrão, contexto curto (até 272K tokens de entrada). A última coluna é um cálculo para um trabalho concreto: 1.000 requisições, cada uma com 500 tokens de entrada e 200 de saída. Pense em um bot de suporte que etiqueta tickets.
Role a tabela para a direita →
| Modelo | Entrada | Saída | Entrada em cache | 1.000 requisições (500 in / 200 out) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
Duas coisas chamam atenção. Primeiro, o gpt-5-nano tem o menor preço de entrada e empata com o gpt-4.1-nano na saída, então se você fica na OpenAI e a tarefa é simples, ele é o ponto de partida. Segundo, o gpt-4o-mini, que muitos projetos escolheram como modelo barato, agora custa mais que o gpt-5-nano tanto na entrada quanto na saída. Se esse é o seu modelo, você tem uma opção mais barata sem sair da OpenAI.
Acima da tabela ficam o gpt-4.1-mini ($0.40 / $1.60) e o gpt-5.4-mini ($0.75 / $4.50). Níveis maiores para comparação: gpt-6.1-terra a $1 / $5 (cobrimos em GPT-6.1 Terra API price), gpt-6.1-sol a $2 / $10 e gpt-6-astra a $10 / $50. Uma ressalva da mesma página: endpoints de processamento regional têm acréscimo de 10% para modelos lançados em ou após 5 de março de 2026. A página lista apenas preços, então confira a página de cada modelo para tamanho de contexto e limites antes de migrar uma tarefa.
Para onde vai o dinheiro em 1.000 requisições pequenas#
Pegue o bot de etiquetar tickets. Cada requisição envia cerca de 500 tokens (a instrução mais o ticket) e recebe cerca de 200 de volta. No gpt-5-nano, 1.000 dessas custam:
- Entrada: 0,5M de tokens × $0.05 = $0.025
- Saída: 0,2M de tokens × $0.40 = $0.08
- Total: $0.025 + $0.08 = $0.105
Repare na divisão. A resposta curta tem menos de um terço dos tokens, mas é $0.08 dos $0.105. Essa é a pegadinha de procurar modelo barato: o preço de saída decide a conta com mais frequência do que o de entrada. Se quiser a versão longa dessa ideia, input vs output tokens explica em detalhe.
A OpenAI também lista uma tarifa de entrada em cache: $0.005 por 1M para o gpt-5-nano (como isso funciona está em what is prompt caching). Digamos que toda a sua entrada de 500 tokens seja um prompt repetido e entre em cache. A entrada cai para 0,5M × $0.005 = $0.0025, e o trabalho custa $0.0025 + $0.08 = $0.0825. A conta quase não muda, porque os 200 tokens de saída ainda custam $0.08.
Tente a mesma aritmética em escala maior:
Adivinhar o número
Um etiquetador envia 200.000 requisições por dia para o gpt-5-nano, cada uma com 500 tokens de entrada e 200 de saída. Quantos dólares isso dá por dia?
O seu palpite
0100
Mostrar resposta
Resposta: 21
$21. Entrada: 100M de tokens × $0.05 = $5. Saída: 40M de tokens × $0.40 = $16. Total $5 + $16 = $21.
O mesmo trabalho em modelos de pesos abertos#
Agora as mesmas 1.000 requisições de 500 in e 200 out, com preços na CheapTokens pelas tarifas de hoje:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 tokens de entrada e 200 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Em números: GLM-5.3-Flash fica em $0.018, DeepSeek-V4-Flash em $0.0275 e MiniMax-M2.7 em $0.055. Compare com os $0.105 do gpt-5-nano. A tabela é ao vivo, então acompanha a lista de preços atual. O GLM-5.3-Flash tem contexto de 390K e responde até 8.192 tokens, o que é de sobra para uma etiqueta ou uma resposta curta. O DeepSeek-V4-Flash tem contexto de 380K e responde até 32.768 tokens, o que importa quando a saída é um relatório ou um trecho longo de código. Ambos mantêm um único preço a qualquer hora, sem tarifa de pico.
Mais um cenário: um chatbot que ainda está no gpt-4o-mini. Digamos que cada chat envia cerca de 1.200 tokens (histórico mais a nova pergunta), recebe 250 de volta, e você atende 3.000 chats por dia. No gpt-4o-mini isso dá 3,6M de tokens de entrada × $0.15 = $0.54 e 0,75M de tokens de saída × $0.60 = $0.45, ou seja, $0.99 por dia. No gpt-5-nano o mesmo dia fica em 3,6M × $0.05 = $0.18 mais 0,75M × $0.40 = $0.30, ou seja, $0.48. Aqui está o mesmo tráfego na CheapTokens; troque os números para casar com o seu bot:
Calculadora de custos
Um dia de chatbot: 3.000 chats
Tokens de entrada por solicitação: 1.200 · Tokens de saída por solicitação: 250 · Solicitações por dia: 3.000
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
A troca exige três pequenas mudanças#
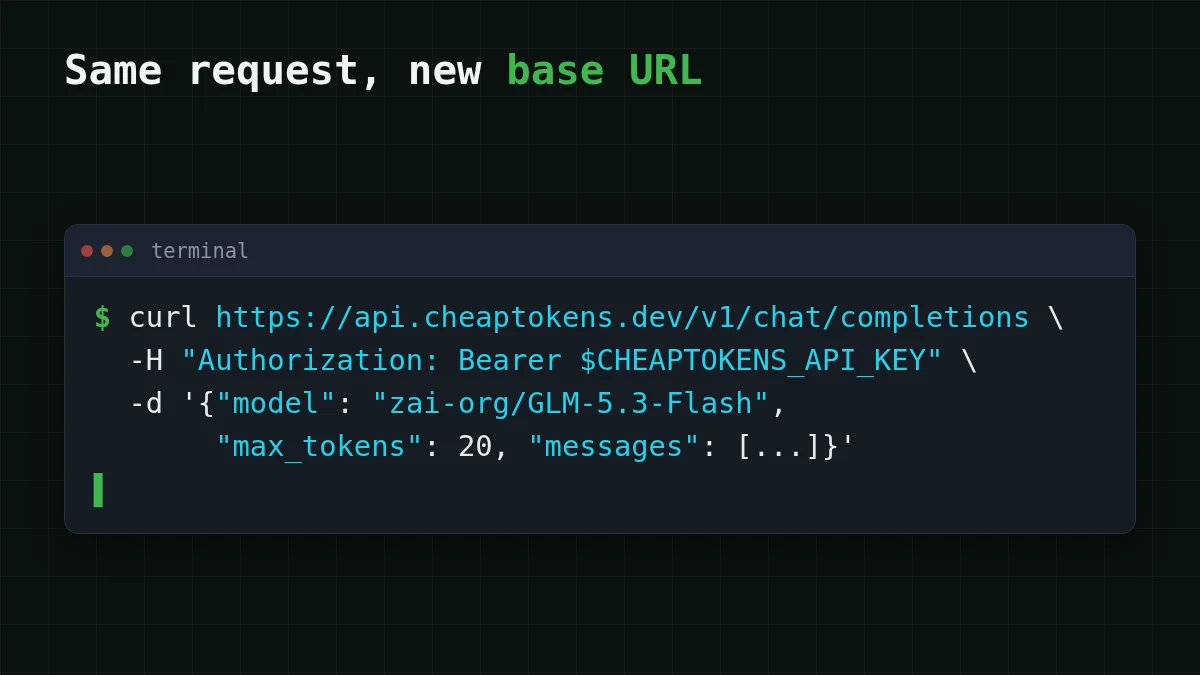
A CheapTokens fala a API da OpenAI, então o código que você já tem continua funcionando. Você muda a base URL, a chave e o id do modelo. Pegue o id na docs, porque os provedores nomeiam modelos de formas diferentes. Para o GLM-5.3-Flash é zai-, e a base URL é https:/.
Uma requisição de etiquetagem, duas formas
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Rode em 50 dos seus tickets reais e leia as respostas você mesmo. O campo usage em cada resposta dá a contagem exata de tokens de entrada e saída, e esses dois números são tudo de que a calculadora acima precisa. Chaves, saldo e a primeira chamada estão em your first API request.
Qual usar para cada trabalho#
Escolha o seu caso
O que você está rodando?
Escolha uma opção para ver a resposta
Etiquetar ou classificar textos curtos
Respostas curtas, volume enorme. Na OpenAI, o gpt-5-nano é o mais barato. Na CheapTokens, experimente o GLM-5.3-Flash: contexto de 390K, até 8.192 tokens de saída, um preço a qualquer hora.
Respostas longas: relatórios, rascunhos, código
Experimente o DeepSeek-V4-Flash. Ele escreve até 32.768 tokens em uma resposta e tem contexto de 380K.
Um loop de agente ou uma ferramenta de código
Experimente o MiniMax-M2.7 ou o DeepSeek-V4-Flash. Ambos ficam no mesmo saldo que os outros modelos, então você alterna entre eles sem criar conta nova.
Você precisa ficar na OpenAI
Use o gpt-5-nano para o menor preço, ou o gpt-6-luna se quiser o modelo mais barato da linha GPT-6. Se você está no gpt-4o-mini, o gpt-5-nano é mais barato dos dois lados.
Seja qual for a escolha, teste nos seus próprios exemplos antes de migrar a carga inteira. A tabela de preços diz quanto custa um token; só os seus dados dizem se as respostas são boas o suficiente. Os preços atuais de cada modelo estão na pricing page, e how much AI tokens cost coloca orçamentos de 1M e 10M de tokens lado a lado.


