모델 & 비교비교
2026년 가장 저렴한 OpenAI API 모델: gpt-5-nano vs gpt-6-luna
2026년 10월 28일에 확인한 공식 가격 기준 OpenAI의 가장 저렴한 API 모델과, 같은 1,000건 요청이 오픈 웨이트 모델에서 얼마인지.
이 페이지의 내용
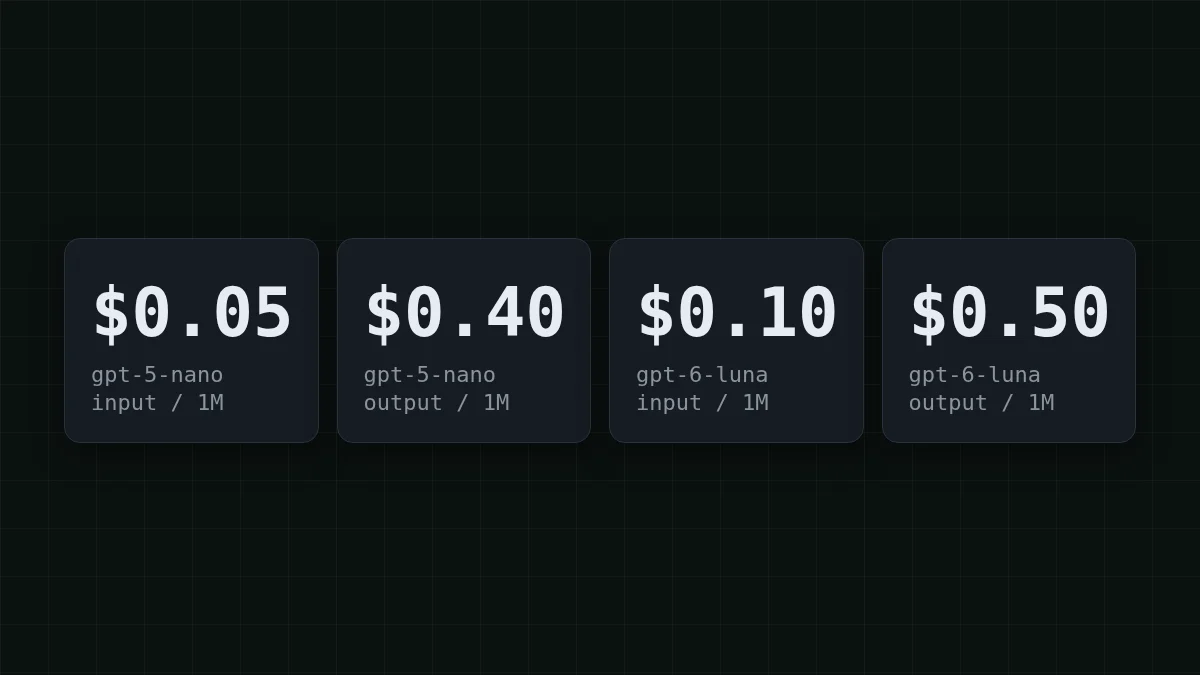
OpenAI 가격 페이지에서 가장 저렴한 텍스트 모델은 gpt-5-nano로, 입력 1M 토큰당 $0.05, 출력 1M 토큰당 $0.40입니다. 최신 GPT-6 라인에서는 gpt-6-luna가 입력 $0.10, 출력 $0.50으로 가장 저렴합니다. 이 수치는 2026년 10월 28일에 확인한 OpenAI 가격 페이지에서 가져왔습니다. 페이지에 게시 날짜가 없으므로 확인 날짜를 신뢰해야 합니다.
하지만 토큰당 낮은 가격이 작업당 낮은 가격과 같은 것은 아닙니다. 소규모 고볼륨 작업에서는 CheapTokens의 오픈 웨이트 모델, 예를 들어 GLM-5.3-Flash와 DeepSeek-V4-Flash가 총비용에서 더 낮게 나옵니다. 아래에서 구체적인 작업으로 확인한 뒤 자신의 수치를 대입해 보세요.
아래에서부터 보는 OpenAI 가격 사다리#
모든 가격은 1M 토큰당, 표준 티어, 짧은 컨텍스트(입력 최대 272K 토큰) 기준입니다. 마지막 열은 구체적인 작업 하나에 대한 계산입니다: 요청 1,000건, 각각 입력 500토큰과 출력 200토큰. 티켓에 태그를 붙이는 지원 봇을 생각하면 됩니다.
표를 오른쪽으로 스크롤하세요 →
| 모델 | 입력 | 출력 | 캐시 입력 | 1,000건 요청 (입력 500 / 출력 200) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
두 가지가 눈에 띕니다. 첫째, gpt-5-nano는 입력 가격이 가장 낮고 출력에서 gpt-4.1-nano와 동률이므로, OpenAI에 머물면서 작업이 단순하다면 이것이 출발점입니다. 둘째, 많은 프로젝트가 저렴한 모델로 선택했던 gpt-4o-mini는 이제 입력과 출력 모두에서 gpt-5-nano보다 비쌉니다. 이것이 당신의 모델이라면 OpenAI를 떠나지 않고도 더 저렴한 옵션이 있습니다.
표 위에는 gpt-4.1-mini($0.40 / $1.60)와 gpt-5.4-mini($0.75 / $4.50)가 있습니다. 대조를 위한 더 큰 티어: gpt-6.1-terra는 $1 / $5(GPT-6.1 Terra API price에서 다뤘습니다), gpt-6.1-sol은 $2 / $10, gpt-6-astra는 $10 / $50입니다. 같은 페이지에서 나온 주의사항 하나: 지역 처리 엔드포인트는 2026년 3월 5일 이후 출시된 모델에 대해 10% 할증이 붙습니다. 페이지에는 가격만 나와 있으므로 작업을 옮기기 전에 각 모델의 자체 페이지에서 컨텍스트 크기와 제한을 확인하세요.
1,000건의 소규모 요청에서 돈이 어디로 가는가#
티켓 태깅 봇을 예로 들어 봅시다. 각 요청은 약 500토큰(지시문과 티켓)을 보내고 약 200토큰을 돌려받습니다. gpt-5-nano에서 1,000건의 비용은 다음과 같습니다:
- 입력: 0.5M 토큰 × $0.05 = $0.025
- 출력: 0.2M 토큰 × $0.40 = $0.08
- 합계: $0.025 + $0.08 = $0.105
분배를 보세요. 짧은 답변은 토큰의 3분의 1도 안 되지만, $0.105 중 $0.08을 차지합니다. 저렴한 모델을 고를 때의 함정이 바로 이것입니다: 출력 가격이 입력 가격보다 청구서를 더 자주 결정합니다. 이 아이디어의 더 긴 버전을 원한다면 input vs output tokens에서 자세히 다룹니다.
OpenAI는 캐시 입력 요율도 명시합니다: gpt-5-nano의 경우 1M당 $0.005입니다(작동 방식은 what is prompt caching에 있습니다). 500토큰 입력 전체가 반복 프롬프트라서 캐시된다고 가정해 봅시다. 입력은 0.5M × $0.005 = $0.0025로 떨어지고, 작업 비용은 $0.0025 + $0.08 = $0.0825가 됩니다. 200개의 출력 토큰이 여전히 $0.08이므로 청구서는 거의 움직이지 않습니다.
더 큰 규모로 같은 계산을 해 보세요:
숫자 맞히기
태거가 하루에 200,000건의 요청을 gpt-5-nano로 보내고, 각각 입력 500토큰과 출력 200토큰입니다. 하루에 몇 달러입니까?
내 추측
0100
정답 보기
정답: 21
$21. 입력: 100M 토큰 × $0.05 = $5. 출력: 40M 토큰 × $0.40 = $16. 합계 $5 + $16 = $21.
오픈 웨이트 모델에서 같은 작업#
이제 입력 500, 출력 200의 같은 1,000건 요청을 CheapTokens의 오늘 요율로 계산하면:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,000회 요청 | OpenRouter, 1,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
요청당 입력 500개 및 출력 200개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
숫자로 보면: GLM-5.3-Flash는 $0.018, DeepSeek-V4-Flash는 $0.0275, MiniMax-M2.7은 $0.055입니다. 이것을 gpt-5-nano의 $0.105와 나란히 놓아 보세요. 표는 실시간이므로 현재 가격표를 따릅니다. GLM-5.3-Flash는 390K 컨텍스트에 최대 8,192토큰까지 답하며, 태그나 짧은 답변에는 충분합니다. DeepSeek-V4-Flash는 380K 컨텍스트에 최대 32,768토큰까지 답하며, 출력이 보고서나 긴 코드일 때 중요합니다. 둘 다 시간대와 관계없이 하나의 가격을 유지하며 피크 요금이 없습니다.
시나리오 하나 더, 아직 gpt-4o-mini를 쓰는 챗봇입니다. 각 채팅이 약 1,200토큰(히스토리와 새 질문)을 보내고 250토큰을 돌려받으며, 하루에 3,000건의 채팅을 처리한다고 가정해 봅시다. gpt-4o-mini에서는 3.6M 입력 토큰 × $0.15 = $0.54, 0.75M 출력 토큰 × $0.60 = $0.45로 하루 $0.99입니다. gpt-5-nano에서 같은 하루는 3.6M × $0.05 = $0.18 더하기 0.75M × $0.40 = $0.30으로 $0.48입니다. 같은 트래픽을 CheapTokens에서 계산한 것입니다; 봇에 맞게 수치를 바꾸세요:
비용 계산기
챗봇 하루: 채팅 3,000건
요청당 입력 토큰: 1,200 · 요청당 출력 토큰: 250 · 일일 요청 수: 3,000
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
전환에는 세 가지 작은 변경만 필요합니다#
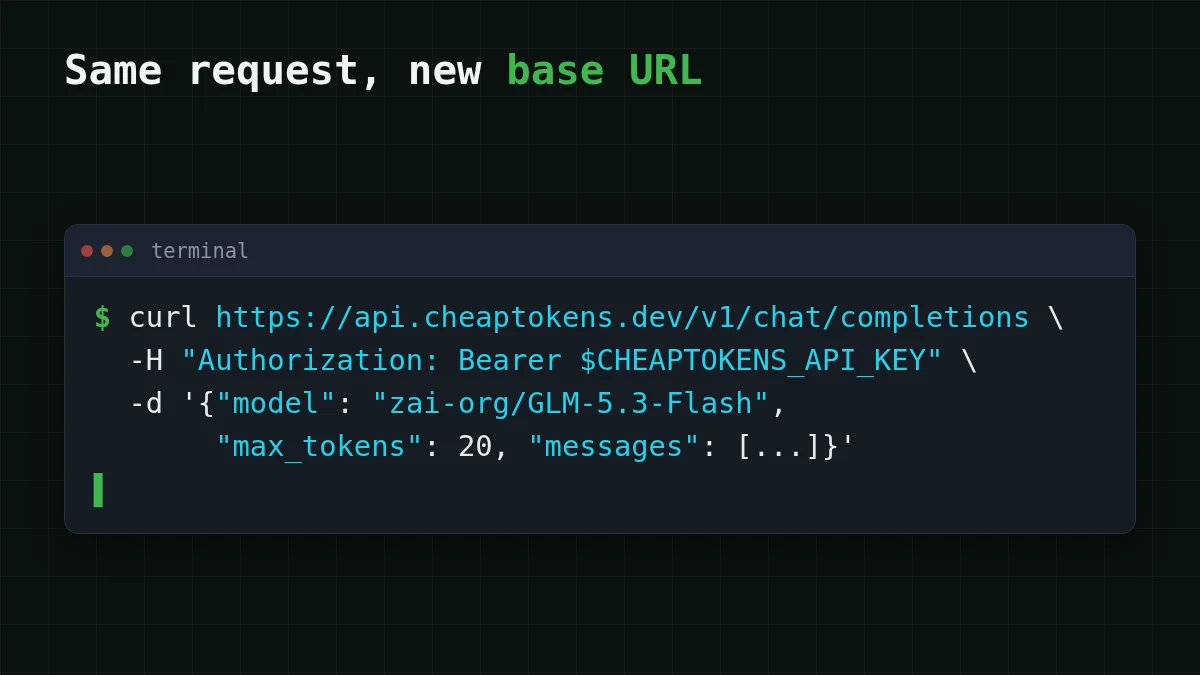
CheapTokens는 OpenAI API를 사용하므로 기존 코드가 계속 작동합니다. 기본 URL, 키, 모델 id를 바꾸면 됩니다. 공급자마다 모델 이름이 다르므로 id는 docs에서 가져오세요. GLM-5.3-Flash의 경우 zai-이고 기본 URL은 https:/입니다.
태깅 요청 하나, 두 가지 방법
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
실제 티켓 50건에 실행해 보고 답변을 직접 읽어 보세요. 각 응답의 usage 필드는 정확한 입력 및 출력 토큰 수를 제공하며, 위 계산기에는 이 두 숫자만 있으면 됩니다. 키, 잔액, 첫 호출은 your first API request에 있습니다.
어떤 작업에 무엇을 쓸까#
사례 선택하기
무엇을 운영하고 있나요?
답을 보려면 옵션을 선택하세요
짧은 텍스트 태깅 또는 분류
짧은 답변, 막대한 볼륨. OpenAI에서는 gpt-5-nano가 가장 저렴합니다. CheapTokens에서는 GLM-5.3-Flash를 시도해 보세요: 390K 컨텍스트, 최대 8,192 출력 토큰, 시간대와 관계없이 하나의 가격.
긴 답변: 보고서, 초안, 코드
DeepSeek-V4-Flash를 시도해 보세요. 한 답변에서 최대 32,768토큰을 작성하며 380K 컨텍스트를 갖습니다.
에이전트 루프 또는 코딩 도구
MiniMax-M2.7 또는 DeepSeek-V4-Flash를 시도해 보세요. 둘 다 다른 모델과 같은 잔액에 있으므로 새 계정 없이 전환할 수 있습니다.
OpenAI에 머물러야 함
최저 가격을 원하면 gpt-5-nano를, GPT-6 라인의 가장 저렴한 모델을 원하면 gpt-6-luna를 사용하세요. gpt-4o-mini를 쓰고 있다면 gpt-5-nano가 양쪽 모두 더 저렴합니다.
무엇을 고르든 전체 워크로드를 옮기기 전에 자신의 예시로 테스트하세요. 가격표는 토큰 비용을 알려주지만, 답변이 충분히 좋은지는 오직 당신의 데이터만 알려줍니다. 모든 모델의 현재 가격은 pricing page에 있고, how much AI tokens cost는 1M과 10M 토큰 예산을 나란히 보여줍니다.


