模型与对比对比
2026 年最便宜的 OpenAI API 模型:gpt-5-nano 与 gpt-6-luna
OpenAI 最便宜的 API 模型及 2026 年 10 月 28 日查询的官方价格,以及同样的 1,000 次请求在开放权重模型上的成本。
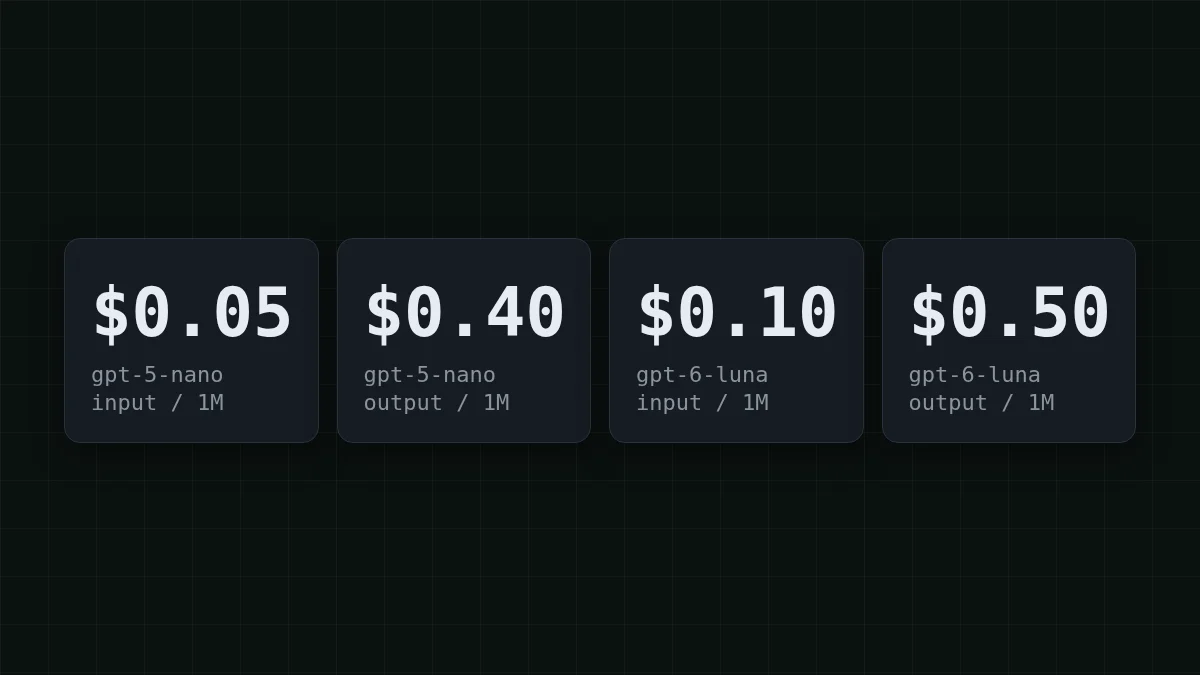
OpenAI 定价页面上最便宜的文本模型是 gpt-5-nano:每 1M 输入 token 收费 $0.05,每 1M 输出 token 收费 $0.40。在较新的 GPT-6 系列中,最便宜的是 gpt-6-luna,输入 $0.10、输出 $0.50。这些数字来自 OpenAI 的定价页面,查询日期为 2026 年 10 月 28 日。该页面没有标注发布日期,因此应以查询日期为准。
但每 token 价格低并不等于每任务价格低。对于小规模、高并发的任务,CheapTokens 上的开放权重模型(例如 GLM-5.3-Flash 和 DeepSeek-V4-Flash)总成本更低。下面你会看到一个具体任务上的对比,然后可以代入你自己的数字。
从底部看 OpenAI 的价格阶梯#
所有价格均为每 1M token、标准层级、短上下文(最多 272K 输入 token)。最后一列是针对一个具体任务的计算:1,000 次请求,每次 500 输入 token 和 200 输出 token。可以想象成一个给工单打标签的客服机器人。
向右滚动表格 →
| 模型 | 输入 | 输出 | 缓存输入 | 1,000 次请求(500 输入 / 200 输出) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
有两点很突出。第一,gpt-5-nano 的输入价格最低,输出价格与 gpt-4.1-nano 持平,因此如果你继续使用 OpenAI 且任务简单,它就是起点。第二,许多项目曾选作廉价模型的 gpt-4o-mini,现在在输入和输出上都比 gpt-5-nano 更贵。如果那是你正在用的模型,那么你不必离开 OpenAI 就有更便宜的选择。
表格上方是 gpt-4.1-mini($0.40 / $1.60)和 gpt-5.4-mini($0.75 / $4.50)。作为对比,更大的层级:gpt-6.1-terra 为 $1 / $5(我们在 GPT-6.1 Terra API 价格 中介绍过),gpt-6.1-sol 为 $2 / $10,gpt-6-astra 为 $10 / $50。同一页面还有一个注意事项:对于 2026 年 3 月 5 日或之后发布的模型,区域处理端点会有 10% 的加价。该页面只列出价格,因此在迁移任务之前,请查看每个模型自己的页面以了解上下文大小和限制。
1,000 次小请求的钱花在哪里#
以工单打标签机器人为例。每次请求发送约 500 token(指令加工单),返回约 200 token。在 gpt-5-nano 上,1,000 次这样的请求花费:
- 输入:0.5M token × $0.05 = $0.025
- 输出:0.2M token × $0.40 = $0.08
- 总计:$0.025 + $0.08 = $0.105
看看这个拆分。简短回答的 token 不到三分之一,但它在 $0.105 中占了 $0.08。这就是挑选廉价模型时的陷阱:输出价格比输入价格更常决定账单。如果你想看这个观点的更长版本,输入与输出 token 有详细说明。
OpenAI 还列出了缓存输入费率:gpt-5-nano 为每 1M $0.005(其工作原理见 什么是提示缓存)。假设你全部 500 token 的输入都是重复的提示并被缓存。输入降至 0.5M × $0.005 = $0.0025,任务成本为 $0.0025 + $0.08 = $0.0825。账单几乎不变,因为 200 个输出 token 仍然花费 $0.08。
在更大规模上试试同样的算术:
猜数字
一个打标签程序每天向 gpt-5-nano 发送 200,000 次请求,每次 500 输入 token 和 200 输出 token。每天多少美元?
你的猜测
0100
显示答案
答案: 21
$21。输入:100M token × $0.05 = $5。输出:40M token × $0.40 = $16。总计 $5 + $16 = $21。
开放权重模型上的同一任务#
现在同样的 1,000 次请求(500 输入、200 输出),按 CheapTokens 今天的费率计价:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
每次请求 500 个输入 token 和 200 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
用数字表示:GLM-5.3-Flash 花费 $0.018,DeepSeek-V4-Flash 花费 $0.0275,MiniMax-M2.7 花费 $0.055。把它与 gpt-5-nano 的 $0.105 放在一起看。该表格是实时的,因此会跟随当前价格表。GLM-5.3-Flash 有 390K 上下文,最多回答 8,192 token,对于标签或简短回复来说绰绰有余。DeepSeek-V4-Flash 有 380K 上下文,最多回答 32,768 token,当输出是报告或长段代码时这很重要。两者在任何时段都保持一个价格,没有高峰定价。
还有一个场景:一个仍在使用 gpt-4o-mini 的聊天机器人。假设每次聊天发送约 1,200 token(历史记录加新问题),返回 250 token,你每天服务 3,000 次聊天。在 gpt-4o-mini 上,这是 3.6M 输入 token × $0.15 = $0.54 和 0.75M 输出 token × $0.60 = $0.45,所以每天 $0.99。在 gpt-5-nano 上,同一天是 3.6M × $0.05 = $0.18 加上 0.75M × $0.40 = $0.30,所以是 $0.48。下面是 CheapTokens 上的相同流量;修改数字以匹配你的机器人:
成本计算器
聊天机器人的一天:3,000 次聊天
每次请求的输入 token 数: 1,200 · 每次请求的输出 token 数: 250 · 每日请求数: 3,000
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
切换只需三处小改动#
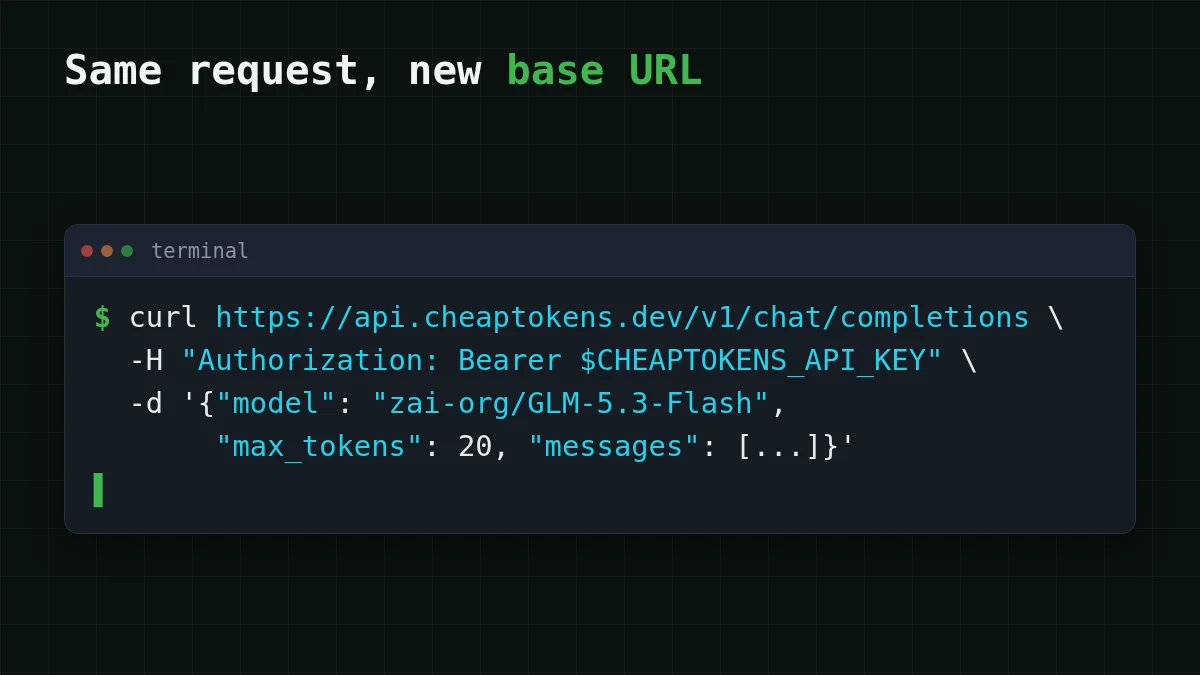
CheapTokens 兼容 OpenAI API,因此你现有的代码可以继续工作。你只需更改基础 URL、密钥和模型 ID。从文档中获取 ID,因为各提供商对模型的命名不同。对于 GLM-5.3-Flash,它是 zai-,基础 URL 是 https:/。
一次打标签请求,两种方式
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
在你真实的 50 张工单上运行它,并亲自阅读回答。每个响应中的 usage 字段给出确切的输入和输出 token 数,这两个数字就是上面的计算器所需要的全部。密钥、余额和首次调用见你的第一个 API 请求。
哪个任务用哪个模型#
选择你的情况
你在运行什么?
选择一个选项以查看答案
短文本打标签或分类
简短回答,巨大流量。在 OpenAI 上,gpt-5-nano 价格最低。在 CheapTokens 上,试试 GLM-5.3-Flash:390K 上下文,最多 8,192 输出 token,任何时段一个价格。
长回答:报告、草稿、代码
试试 DeepSeek-V4-Flash。它一次回答最多写 32,768 token,并且有 380K 上下文。
智能体循环或编码工具
试试 MiniMax-M2.7 或 DeepSeek-V4-Flash。两者与其他模型共用一个余额,因此你可以在它们之间切换而无需新账户。
你必须留在 OpenAI 上
使用 gpt-5-nano 以获得最低价格,或者如果你想要 GPT-6 系列中最便宜的模型,就用 gpt-6-luna。如果你在用 gpt-4o-mini,gpt-5-nano 在输入和输出两边都更便宜。
无论你选哪个,在迁移整个工作负载之前,先在你自己的例子上测试它。价格表告诉你一个 token 的成本;只有你的数据才能告诉你回答是否足够好。每个模型的最新价格在定价页面上,AI token 要花多少钱并排比较了 1M 和 10M token 的预算。


