Mga modelo at paghahambingPaghahambing
Pinakamurang OpenAI API model sa 2026: gpt-5-nano vs gpt-6-luna
Ang pinakamurang OpenAI API models na may opisyal na presyo na sinuri noong 28 Okt 2026, at magkano ang parehong 1,000 requests sa open-weight models.
Sa pahinang ito
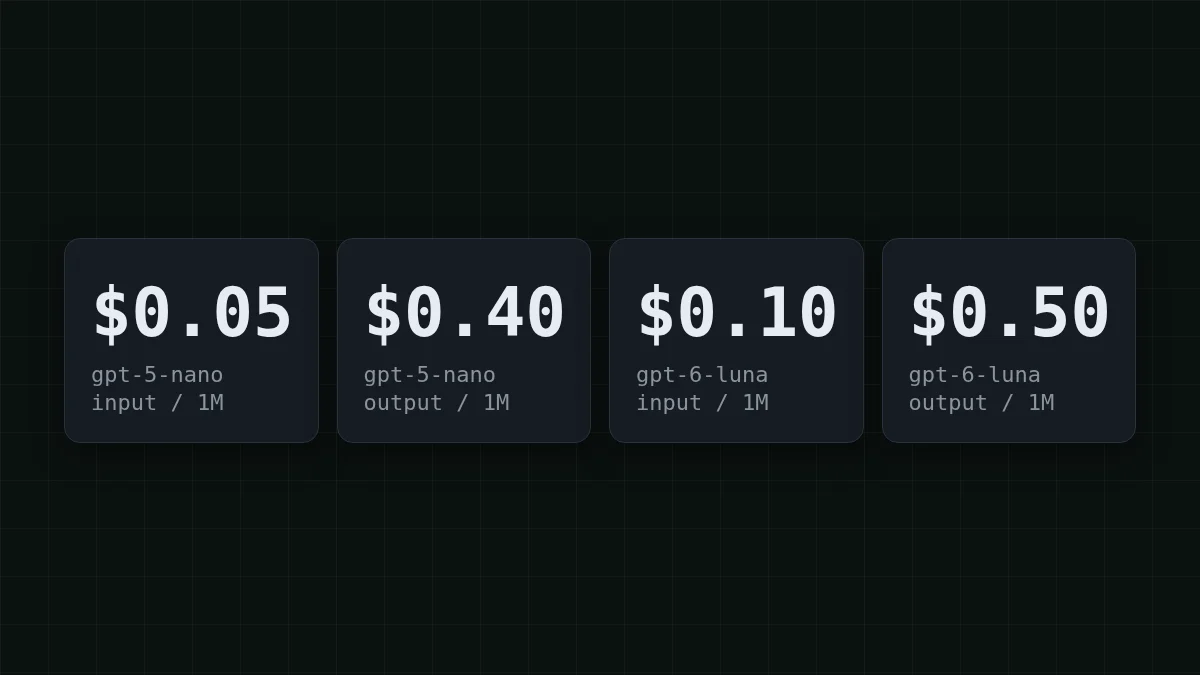
Ang pinakamurang OpenAI text model sa kanilang pricing page ay gpt-5-nano: $0.05 kada 1M input tokens at $0.40 kada 1M output tokens. Sa loob ng mas bagong GPT-6 line, ang pinakamura ay gpt-6-luna sa $0.10 in at $0.50 out. Ang mga numerong iyon ay galing sa OpenAI's pricing page, sinuri noong 28 Oktubre 2026. Walang petsa ng publikasyon ang page, kaya ang petsa ng pagsusuri ang dapat paniwalaan.
Ngunit ang mababang presyo kada token ay hindi katulad ng mababang presyo kada gawain. Para sa maliliit, mataas na volume na trabaho, ang open-weight models sa CheapTokens, tulad ng GLM-5.3-Flash at DeepSeek-V4-Flash, ay lumalabas na mas mababa ang kabuuan. Sa ibaba makikita mo ito sa isang konkretong gawain, pagkatapos ay ilagay ang sarili mong mga numero.
Ang OpenAI price ladder, mula sa ibaba#
Ang lahat ng presyo ay kada 1M tokens, standard tier, short context (hanggang 272K input tokens). Ang huling column ay kalkulasyon para sa isang konkretong gawain: 1,000 requests, bawat isa may 500 input at 200 output tokens. Isipin ang isang support bot na nagta-tag ng tickets.
I-scroll ang table pakanan →
| Model | Input | Output | Cached input | 1,000 requests (500 in / 200 out) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
Dalawang bagay ang kapansin-pansin. Una, ang gpt-5-nano ang may pinakamababang input price at kapantay ng gpt-4.1-nano sa output, kaya kung mananatili ka sa OpenAI at simple ang gawain, ito ang simula. Ikalawa, ang gpt-4o-mini, na pinili ng maraming proyekto bilang murang modelo, ay mas mahal na ngayon kaysa gpt-5-nano sa input at output. Kung iyon ang modelo mo, mayroon kang mas murang opsyon nang hindi lumalabas sa OpenAI.
Sa itaas ng table ay ang gpt-4.1-mini ($0.40 / $1.60) at gpt-5.4-mini ($0.75 / $4.50). Mas malalaking tier para sa paghahambing: gpt-6.1-terra sa $1 / $5 (tinalakay namin ito sa GPT-6.1 Terra API price), gpt-6.1-sol sa $2 / $10 at gpt-6-astra sa $10 / $50. Isang caveat mula sa parehong page: ang regional-processing endpoints ay may 10% uplift para sa mga modelong inilabas noong o pagkatapos ng 5 Marso 2026. Mga presyo lamang ang nakalista sa page, kaya tingnan ang sariling page ng bawat modelo para sa context size at limits bago mo ilipat ang isang gawain.
Saan napupunta ang pera sa 1,000 maliliit na requests#
Kunin ang ticket-tagging bot. Bawat request ay nagpapadala ng mga 500 tokens (ang instruction kasama ang ticket) at nakakakuha ng mga 200 pabalik. Sa gpt-5-nano, 1,000 sa mga iyon ay nagkakahalaga ng:
- Input: 0.5M tokens × $0.05 = $0.025
- Output: 0.2M tokens × $0.40 = $0.08
- Total: $0.025 + $0.08 = $0.105
Tingnan ang split. Ang maikling sagot ay wala pang ikatlong bahagi ng tokens, ngunit ito ay $0.08 ng $0.105. Iyon ang catch sa pagbili ng murang modelo: ang output price ang mas madalas na nagpapasya sa bill kaysa sa input price. Kung gusto mo ang mas mahabang bersyon ng ideyang iyon, input vs output tokens ang naglalakad dito.
Naglista rin ang OpenAI ng cached-input rate: $0.005 kada 1M para sa gpt-5-nano (kung paano ito gumagana ay nasa what is prompt caching). Sabihin nating ang buong 500-token input mo ay paulit-ulit na prompt at na-cache. Bumababa ang input sa 0.5M × $0.005 = $0.0025, at ang gawain ay nagkakahalaga ng $0.0025 + $0.08 = $0.0825. Bahagya lang gumagalaw ang bill, dahil ang 200 output tokens ay $0.08 pa rin.
Subukan ang parehong arithmetic sa mas malaking scale:
Hulaan ang numero
Ang isang tagger ay nagpapadala ng 200,000 requests kada araw sa gpt-5-nano, bawat isa may 500 tokens in at 200 out. Ilang dolyar iyon kada araw?
Ang iyong hula
0100
Ipakita ang sagot
Sagot: 21
$21. Input: 100M tokens × $0.05 = $5. Output: 40M tokens × $0.40 = $16. Total $5 + $16 = $21.
Ang parehong gawain sa open-weight models#
Ngayon ang parehong 1,000 requests ng 500 in at 200 out, na-presyuhan sa CheapTokens sa mga rate ngayon:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 input at 200 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa mga numero: GLM-5.3-Flash ay tumatagal ng $0.018, DeepSeek-V4-Flash $0.0275 at MiniMax-M2.7 $0.055. Ilagay iyon sa tabi ng $0.105 para sa gpt-5-nano. Live ang table, kaya sinusundan nito ang kasalukuyang price list. Ang GLM-5.3-Flash ay may 390K context at sumasagot ng hanggang 8,192 tokens, na sapat para sa isang tag o maikling sagot. Ang DeepSeek-V4-Flash ay may 380K context at sumasagot ng hanggang 32,768 tokens, na mahalaga kapag ang output ay isang report o mahabang piraso ng code. Pareho silang may isang presyo sa anumang oras, walang peak pricing.
Isa pang senaryo, isang chatbot na nasa gpt-4o-mini pa rin. Sabihin nating bawat chat ay nagpapadala ng mga 1,200 tokens (history kasama ang bagong tanong), nakakakuha ng 250 pabalik, at nagse-serve ka ng 3,000 chats kada araw. Sa gpt-4o-mini iyon ay 3.6M input tokens × $0.15 = $0.54 at 0.75M output tokens × $0.60 = $0.45, kaya $0.99 kada araw. Sa gpt-5-nano ang parehong araw ay 3.6M × $0.05 = $0.18 plus 0.75M × $0.40 = $0.30, kaya $0.48. Narito ang parehong traffic sa CheapTokens; palitan ang mga numero para tumugma sa iyong bot:
Calculator ng gastos
Isang araw ng chatbot: 3,000 chats
Mga input token bawat kahilingan: 1,200 · Mga output token bawat kahilingan: 250 · Mga kahilingan bawat araw: 3,000
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
Tatlong maliit na pagbabago ang kailangan sa paglipat#
Nagsasalita ng OpenAI API ang CheapTokens, kaya gumagana pa rin ang code mo. Palitan mo ang base URL, ang key at ang model id. Kunin ang id mula sa docs, dahil iba-iba ang pangalan ng mga modelo ng providers. Para sa GLM-5.3-Flash ito ay zai-, at ang base URL ay https:/.
Isang tagging request, dalawang paraan
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Patakbuhin ito sa 50 sa iyong mga tunay na ticket at basahin mo mismo ang mga sagot. Ang usage field sa bawat response ay nagbibigay ng eksaktong input at output token counts, at ang dalawang numerong iyon ang kailangan ng calculator sa itaas. Ang mga key, balance at unang call ay nasa your first API request.
Alin para sa aling gawain#
Piliin ang iyong kaso
Ano ang pinapatakbo mo?
Pumili ng opsyon upang makita ang sagot
Pag-tag o pag-classify ng maiikling teksto
Maiikling sagot, napakalaking volume. Sa OpenAI, gpt-5-nano ang pinakamababang presyo. Sa CheapTokens, subukan ang GLM-5.3-Flash: 390K context, hanggang 8,192 output tokens, isang presyo sa anumang oras.
Mahahabang sagot: reports, drafts, code
Subukan ang DeepSeek-V4-Flash. Sumusulat ito ng hanggang 32,768 tokens sa isang sagot, at may 380K context.
Agent loop o coding tool
Subukan ang MiniMax-M2.7 o DeepSeek-V4-Flash. Pareho silang nasa isang balance kasama ang iba pang modelo, kaya makakalipat ka sa pagitan nila nang walang bagong account.
Kailangan mong manatili sa OpenAI
Gamitin ang gpt-5-nano para sa pinakamababang presyo, o gpt-6-luna kung gusto mo ang pinakamurang modelo ng GPT-6 line. Kung nasa gpt-4o-mini ka, ang gpt-5-nano ay mas mura sa parehong panig.
Alinman ang piliin mo, subukan ito sa sarili mong mga halimbawa bago mo ilipat ang buong workload. Sinasabi ng price table kung magkano ang isang token; ang data mo lang ang magsasabi kung sapat na ba ang mga sagot. Ang kasalukuyang presyo para sa bawat modelo ay nasa pricing page, at ang how much AI tokens cost ay naglalagay ng 1M at 10M token budgets nang magkatabi.


