Modelos y comparativasComparativa
El modelo de API de OpenAI más barato en 2026: gpt-5-nano vs gpt-6-luna
Los modelos de API de OpenAI más baratos con precios oficiales consultados el 28 de octubre de 2026, y cuánto cuestan las mismas 1.000 solicitudes en modelos de pesos abiertos.
En esta página
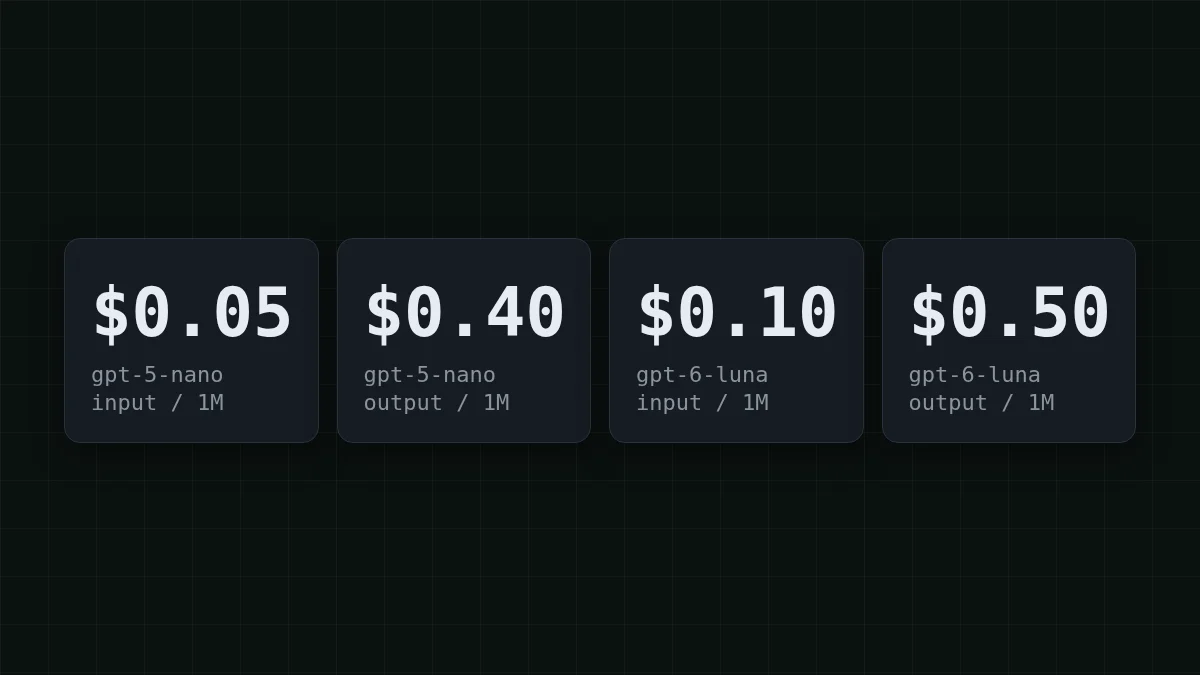
El modelo de texto de OpenAI más barato en su página de precios es gpt-5-nano: $0.05 por 1M de tokens de entrada y $0.40 por 1M de tokens de salida. Dentro de la línea GPT-6 más reciente, el más barato es gpt-6-luna a $0.10 de entrada y $0.50 de salida. Esos números provienen de la página de precios de OpenAI, consultada el 28 de octubre de 2026. La página no tiene fecha de publicación, así que la fecha de consulta es la que hay que tener en cuenta.
Pero un precio bajo por token no es lo mismo que un precio bajo por tarea. Para trabajos pequeños y de gran volumen, los modelos de pesos abiertos en CheapTokens, como GLM-5.3-Flash y DeepSeek-V4-Flash, salen más baratos en total. Abajo puedes verlo en un trabajo concreto y luego introducir tus propios números.
La escala de precios de OpenAI, desde abajo#
Todos los precios son por 1M de tokens, nivel estándar, contexto corto (hasta 272K tokens de entrada). La última columna es un cálculo para un trabajo concreto: 1.000 solicitudes, cada una con 500 tokens de entrada y 200 de salida. Piensa en un bot de soporte que etiqueta tickets.
Desplaza la tabla hacia la derecha →
| Modelo | Entrada | Salida | Entrada en caché | 1.000 solicitudes (500 in / 200 out) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
Dos cosas destacan. Primero, gpt-5-nano tiene el precio de entrada más bajo y empata con gpt-4.1-nano en salida, así que si te quedas en OpenAI y la tarea es simple, es el punto de partida. Segundo, gpt-4o-mini, que muchos proyectos eligieron como modelo barato, ahora cuesta más que gpt-5-nano tanto en entrada como en salida. Si ese es tu modelo, tienes una opción más barata sin salir de OpenAI.
Por encima de la tabla están gpt-4.1-mini ($0.40 / $1.60) y gpt-5.4-mini ($0.75 / $4.50). Niveles más grandes para contrastar: gpt-6.1-terra a $1 / $5 (lo cubrimos en GPT-6.1 Terra API price), gpt-6.1-sol a $2 / $10 y gpt-6-astra a $10 / $50. Una advertencia de la misma página: los endpoints de procesamiento regional tienen un recargo del 10% para modelos lanzados el 5 de marzo de 2026 o después. La página solo lista precios, así que revisa la página propia de cada modelo para el tamaño de contexto y los límites antes de mover una tarea.
A dónde va el dinero en 1.000 solicitudes pequeñas#
Toma el bot de etiquetado de tickets. Cada solicitud envía unos 500 tokens (la instrucción más el ticket) y recibe unos 200 de vuelta. En gpt-5-nano, 1.000 de esas cuestan:
- Entrada: 0,5M tokens × $0.05 = $0.025
- Salida: 0,2M tokens × $0.40 = $0.08
- Total: $0.025 + $0.08 = $0.105
Fíjate en el reparto. La respuesta corta es menos de un tercio de los tokens, pero son $0.08 de los $0.105. Esa es la trampa de buscar modelos baratos: el precio de salida decide la factura más a menudo que el de entrada. Si quieres la versión larga de esa idea, input vs output tokens lo explica.
OpenAI también lista una tarifa de entrada en caché: $0.005 por 1M para gpt-5-nano (cómo funciona está en what is prompt caching). Supón que toda tu entrada de 500 tokens es un prompt repetido y se cachea. La entrada baja a 0,5M × $0.005 = $0.0025, y el trabajo cuesta $0.0025 + $0.08 = $0.0825. La factura apenas se mueve, porque los 200 tokens de salida siguen costando $0.08.
Prueba la misma aritmética a mayor escala:
Adivina el número
Un etiquetador envía 200.000 solicitudes al día a gpt-5-nano, cada una con 500 tokens de entrada y 200 de salida. ¿Cuántos dólares son eso al día?
Tu respuesta
0100
Mostrar respuesta
Respuesta: 21
$21. Entrada: 100M tokens × $0.05 = $5. Salida: 40M tokens × $0.40 = $16. Total $5 + $16 = $21.
El mismo trabajo en modelos de pesos abiertos#
Ahora las mismas 1.000 solicitudes de 500 de entrada y 200 de salida, con precios en CheapTokens a las tarifas de hoy:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 tokens de entrada y 200 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En números: GLM-5.3-Flash toma $0.018, DeepSeek-V4-Flash $0.0275 y MiniMax-M2.7 $0.055. Pon eso al lado de los $0.105 de gpt-5-nano. La tabla está en vivo, así que sigue la lista de precios actual. GLM-5.3-Flash tiene un contexto de 390K y responde hasta 8.192 tokens, que es más que suficiente para una etiqueta o una respuesta corta. DeepSeek-V4-Flash tiene un contexto de 380K y responde hasta 32.768 tokens, lo que importa cuando la salida es un informe o un fragmento de código largo. Ambos mantienen un precio a cualquier hora, sin precios pico.
Otro escenario más, un chatbot que sigue en gpt-4o-mini. Supón que cada chat envía unos 1.200 tokens (historial más la nueva pregunta), recibe 250 de vuelta y atiendes 3.000 chats al día. En gpt-4o-mini eso son 3,6M tokens de entrada × $0.15 = $0.54 y 0,75M tokens de salida × $0.60 = $0.45, así que $0.99 al día. En gpt-5-nano el mismo día son 3,6M × $0.05 = $0.18 más 0,75M × $0.40 = $0.30, así que $0.48. Aquí está el mismo tráfico en CheapTokens; cambia los números para que coincidan con tu bot:
Calculadora de costos
Un día de chatbot: 3.000 chats
Tokens de entrada por solicitud: 1200 · Tokens de salida por solicitud: 250 · Solicitudes por día: 3000
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
Cambiar requiere tres pequeños ajustes#
CheapTokens habla la API de OpenAI, así que el código que tienes sigue funcionando. Cambias la URL base, la clave y el id del modelo. Toma el id de la documentación, porque los proveedores nombran los modelos de forma distinta. Para GLM-5.3-Flash es zai-, y la URL base es https:/.
Una solicitud de etiquetado, dos formas
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Pruébalo con 50 de tus tickets reales y lee las respuestas tú mismo. El campo usage de cada respuesta da los recuentos exactos de tokens de entrada y salida, y esos dos números son todo lo que necesita la calculadora de arriba. Las claves, el saldo y la primera llamada están en your first API request.
Cuál para cada trabajo#
Elige tu caso
¿Qué estás ejecutando?
Elige una opción para ver la respuesta
Etiquetar o clasificar textos cortos
Respuestas cortas, volumen enorme. En OpenAI, gpt-5-nano es el de menor precio. En CheapTokens, prueba GLM-5.3-Flash: contexto de 390K, hasta 8.192 tokens de salida, un precio a cualquier hora.
Respuestas largas: informes, borradores, código
Prueba DeepSeek-V4-Flash. Escribe hasta 32.768 tokens en una respuesta y tiene un contexto de 380K.
Un bucle de agente o una herramienta de programación
Prueba MiniMax-M2.7 o DeepSeek-V4-Flash. Ambos comparten un saldo con los demás modelos, así que puedes cambiar entre ellos sin una cuenta nueva.
Necesitas quedarte en OpenAI
Usa gpt-5-nano para el precio más bajo, o gpt-6-luna si quieres el modelo más barato de la línea GPT-6. Si estás en gpt-4o-mini, gpt-5-nano es más barato en ambos lados.
Elijas lo que elijas, pruébalo con tus propios ejemplos antes de mover toda la carga de trabajo. La tabla de precios te dice cuánto cuesta un token; solo tus datos te dicen si las respuestas son suficientemente buenas. Los precios actuales de cada modelo están en la página de precios, y how much AI tokens cost pone los presupuestos de 1M y 10M de tokens uno al lado del otro.


