Modelli e confrontiConfronto
Il modello API OpenAI più economico nel 2026: gpt-5-nano vs gpt-6-luna
I modelli API OpenAI più economici con prezzi ufficiali verificati il 28 ottobre 2026, e quanto costano le stesse 1.000 richieste sui modelli open-weight.
In questa pagina
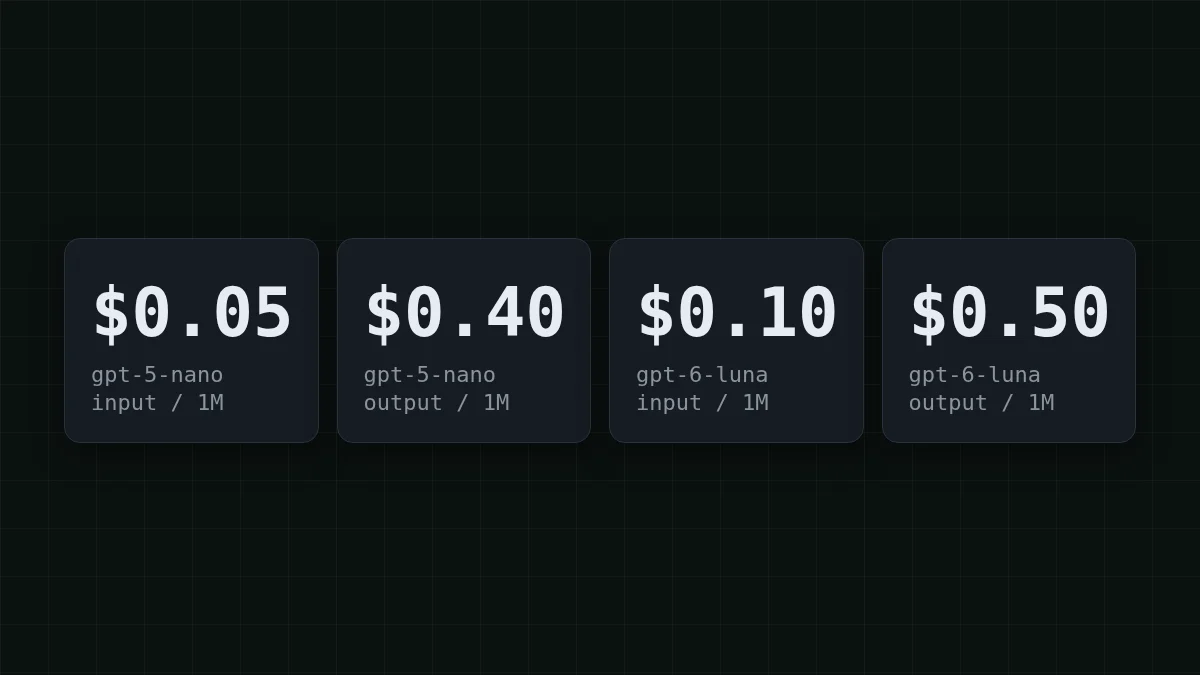
Il modello di testo OpenAI più economico sulla sua pagina dei prezzi è gpt-5-nano: $0.05 per 1M di token in input e $0.40 per 1M di token in output. Nella più recente linea GPT-6, il più economico è gpt-6-luna a $0.10 in input e $0.50 in output. Questi numeri provengono dalla pagina dei prezzi di OpenAI, verificata il 28 ottobre 2026. La pagina non riporta una data di pubblicazione, quindi la data di verifica è quella da considerare.
Ma un prezzo basso per token non equivale a un prezzo basso per attività. Per lavori piccoli e ad alto volume, i modelli open-weight su CheapTokens, come GLM-5.3-Flash e DeepSeek-V4-Flash, risultano più economici nel totale. Qui sotto puoi vederlo su un'attività concreta, poi inserisci i tuoi numeri.
La scala dei prezzi OpenAI, partendo dal basso#
Tutti i prezzi sono per 1M di token, tier standard, contesto breve (fino a 272K token in input). L'ultima colonna è un calcolo per un'attività concreta: 1.000 richieste, ciascuna con 500 token in input e 200 in output. Pensiamo a un bot di supporto che etichetta i ticket.
Scorri la tabella verso destra →
| Modello | Input | Output | Input in cache | 1.000 richieste (500 in / 200 out) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
Due cose saltano all'occhio. Primo, gpt-5-nano ha il prezzo di input più basso e pareggia gpt-4.1-nano sull'output, quindi se resti su OpenAI e l'attività è semplice, è il punto di partenza. Secondo, gpt-4o-mini, che molti progetti hanno scelto come modello economico, ora costa più di gpt-5-nano sia in input che in output. Se è il tuo modello, hai un'opzione più economica senza lasciare OpenAI.
Sopra la tabella ci sono gpt-4.1-mini ($0.40 / $1.60) e gpt-5.4-mini ($0.75 / $4.50). Tier più grandi per confronto: gpt-6.1-terra a $1 / $5 (ne abbiamo parlato in GPT-6.1 Terra API price), gpt-6.1-sol a $2 / $10 e gpt-6-astra a $10 / $50. Un avvertimento dalla stessa pagina: gli endpoint di elaborazione regionale hanno un aumento del 10% per i modelli rilasciati il 5 marzo 2026 o dopo. La pagina elenca solo i prezzi, quindi controlla la pagina di ogni modello per dimensione del contesto e limiti prima di spostare un'attività.
Dove finiscono i soldi in 1.000 piccole richieste#
Prendi il bot che etichetta i ticket. Ogni richiesta invia circa 500 token (l'istruzione più il ticket) e ne riceve circa 200 indietro. Su gpt-5-nano, 1.000 di queste costano:
- Input: 0,5M di token × $0.05 = $0.025
- Output: 0,2M di token × $0.40 = $0.08
- Totale: $0.025 + $0.08 = $0.105
Guarda la ripartizione. La risposta breve è meno di un terzo dei token, ma è $0.08 dei $0.105. Ecco il tranello quando si cerca il modello economico: il prezzo dell'output decide la bolletta più spesso del prezzo dell'input. Se vuoi la versione più lunga di questo concetto, input vs output tokens lo spiega nel dettaglio.
OpenAI elenca anche una tariffa per l'input in cache: $0.005 per 1M per gpt-5-nano (come funziona è in what is prompt caching). Supponiamo che tutto il tuo input di 500 token sia un prompt ripetuto e venga messo in cache. L'input scende a 0,5M × $0.005 = $0.0025, e l'attività costa $0.0025 + $0.08 = $0.0825. La bolletta si muove appena, perché i 200 token di output costano comunque $0.08.
Prova la stessa aritmetica su scala più grande:
Indovina il numero
Un tagger invia 200.000 richieste al giorno a gpt-5-nano, ciascuna con 500 token in input e 200 in output. Quanti dollari sono al giorno?
La tua risposta
0100
Mostra risposta
Risposta: 21
$21. Input: 100M di token × $0.05 = $5. Output: 40M di token × $0.40 = $16. Totale $5 + $16 = $21.
La stessa attività sui modelli open-weight#
Ora le stesse 1.000 richieste da 500 in input e 200 in output, prezzate su CheapTokens alle tariffe di oggi:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 token di input e 200 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
In numeri: GLM-5.3-Flash costa $0.018, DeepSeek-V4-Flash $0.0275 e MiniMax-M2.7 $0.055. Mettilo accanto ai $0.105 di gpt-5-nano. La tabella è live, quindi segue il listino prezzi attuale. GLM-5.3-Flash ha un contesto di 390K e risponde fino a 8.192 token, più che sufficiente per un tag o una risposta breve. DeepSeek-V4-Flash ha un contesto di 380K e risponde fino a 32.768 token, il che conta quando l'output è un report o un pezzo di codice lungo. Entrambi mantengono un unico prezzo a qualsiasi ora, senza prezzi di picco.
Un altro scenario, un chatbot ancora su gpt-4o-mini. Supponiamo che ogni chat invii circa 1.200 token (cronologia più la nuova domanda), ne riceva 250 indietro, e tu serva 3.000 chat al giorno. Su gpt-4o-mini sono 3,6M di token in input × $0.15 = $0.54 e 0,75M di token in output × $0.60 = $0.45, quindi $0.99 al giorno. Su gpt-5-nano lo stesso giorno è 3,6M × $0.05 = $0.18 più 0,75M × $0.40 = $0.30, quindi $0.48. Ecco lo stesso traffico su CheapTokens; cambia i numeri per adattarli al tuo bot:
Calcolatore di costi
Una giornata di chatbot: 3.000 chat
Token di input per richiesta: 1200 · Token di output per richiesta: 250 · Richieste al giorno: 3000
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
Passare richiede tre piccole modifiche#
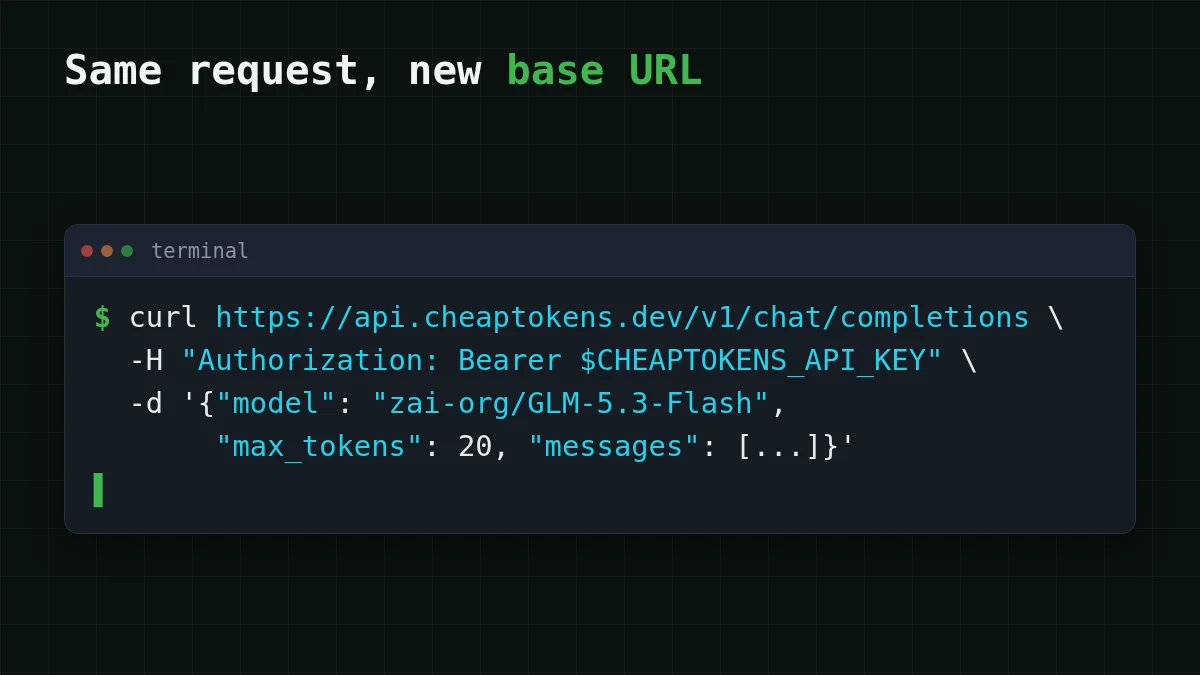
CheapTokens parla l'API OpenAI, quindi il codice che hai continua a funzionare. Cambi l'URL di base, la chiave e l'id del modello. Prendi l'id dalla documentazione, perché i provider nominano i modelli in modo diverso. Per GLM-5.3-Flash è zai-, e l'URL di base è https:/.
Una richiesta di tagging, in due modi
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Eseguilo su 50 dei tuoi ticket reali e leggi tu stesso le risposte. Il campo usage in ogni risposta fornisce i conteggi esatti dei token in input e in output, e quei due numeri sono tutto ciò che serve al calcolatore qui sopra. Chiavi, saldo e la prima chiamata sono in your first API request.
Quale per quale attività#
Scegli il tuo caso
Cosa stai eseguendo?
Scegli un'opzione per vedere la risposta
Etichettare o classificare testi brevi
Risposte brevi, volume enorme. Su OpenAI, gpt-5-nano è il più economico. Su CheapTokens, prova GLM-5.3-Flash: contesto di 390K, fino a 8.192 token in output, un unico prezzo a qualsiasi ora.
Risposte lunghe: report, bozze, codice
Prova DeepSeek-V4-Flash. Scrive fino a 32.768 token in una risposta e ha un contesto di 380K.
Un loop di agenti o uno strumento di coding
Prova MiniMax-M2.7 o DeepSeek-V4-Flash. Entrambi stanno su un unico saldo con gli altri modelli, quindi puoi passare dall'uno all'altro senza un nuovo account.
Devi restare su OpenAI
Usa gpt-5-nano per il prezzo più basso, oppure gpt-6-luna se vuoi il modello più economico della linea GPT-6. Se sei su gpt-4o-mini, gpt-5-nano è più economico su entrambi i fronti.
Qualunque tu scelga, provalo sui tuoi esempi prima di spostare l'intero carico di lavoro. La tabella dei prezzi ti dice quanto costa un token; solo i tuoi dati ti dicono se le risposte sono abbastanza buone. I prezzi attuali di ogni modello sono sulla pagina dei prezzi, e how much AI tokens cost mette a confronto i budget da 1M e 10M di token.


