Modele i porównaniaPorównanie
Najtańszy model API OpenAI w 2026: gpt-5-nano vs gpt-6-luna
Najtańsze modele API OpenAI z oficjalnymi cenami sprawdzonymi 28 października 2026 i ile kosztuje te same 1000 żądań na modelach open-weight.
Na tej stronie
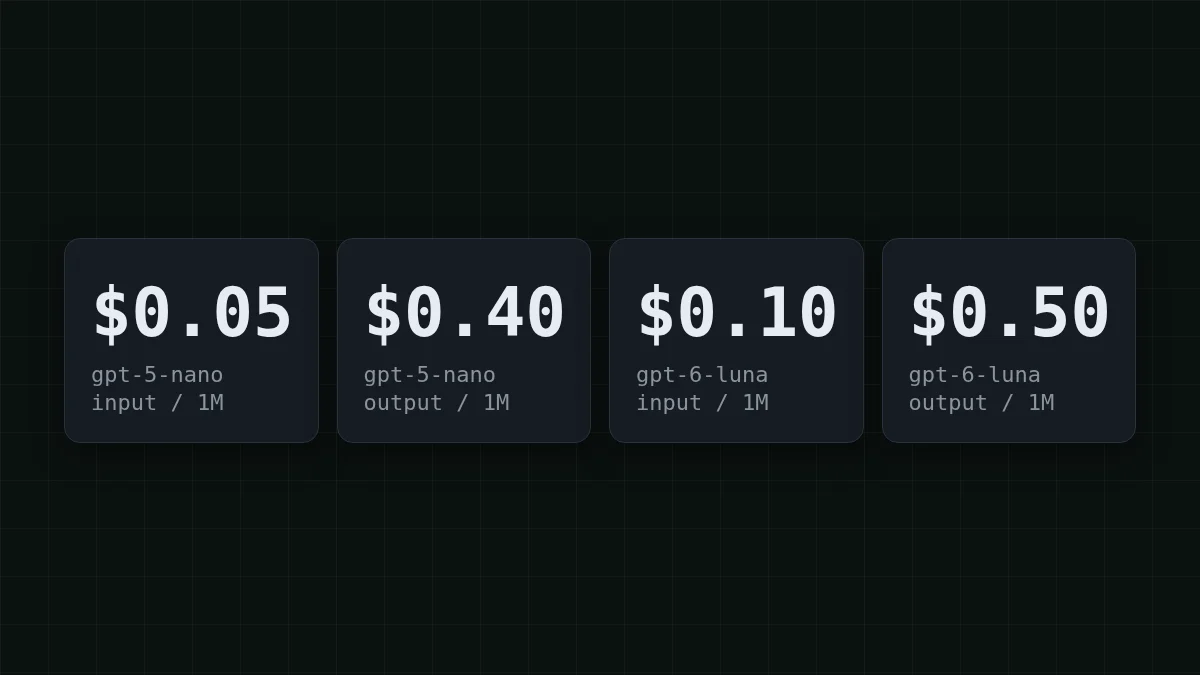
Najtańszym modelem tekstowym OpenAI na jego stronie z cennikiem jest gpt-5-nano: $0.05 za 1M tokenów wejściowych i $0.40 za 1M tokenów wyjściowych. W nowszej linii GPT-6 najtańszy jest gpt-6-luna za $0.10 wejście i $0.50 wyjście. Te liczby pochodzą z cennika OpenAI, sprawdzonego 28 października 2026. Strona nie podaje daty publikacji, więc data sprawdzenia jest tą, której można zaufać.
Ale niska cena za token to nie to samo co niska cena za zadanie. W przypadku małych zadań o dużym wolumenie modele open-weight na CheapTokens, takie jak GLM-5.3-Flash i DeepSeek-V4-Flash, wypadają taniej w sumie. Poniżej zobaczysz to na konkretnym zadaniu, a potem podstaw własne liczby.
Drabinka cen OpenAI, od dołu#
Wszystkie ceny są za 1M tokenów, standardowy poziom, krótki kontekst (do 272K tokenów wejściowych). Ostatnia kolumna to obliczenie dla jednego konkretnego zadania: 1000 żądań, każde z 500 tokenami wejściowymi i 200 wyjściowymi. Pomyśl o bocie wsparcia, który taguje zgłoszenia.
Przewiń tabelę w prawo →
| Model | Wejście | Wyjście | Wejście z cache | 1000 żądań (500 we / 200 wy) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
Dwie rzeczy się wyróżniają. Po pierwsze, gpt-5-nano ma najniższą cenę wejścia i dorównuje gpt-4.1-nano w cenie wyjścia, więc jeśli zostajesz przy OpenAI i zadanie jest proste, to jest punkt wyjścia. Po drugie, gpt-4o-mini, który wiele projektów wybrało jako tani model, kosztuje teraz więcej niż gpt-5-nano zarówno na wejściu, jak i na wyjściu. Jeśli to twój model, masz tańszą opcję bez opuszczania OpenAI.
Powyżej tabeli znajdują się gpt-4.1-mini ($0.40 / $1.60) i gpt-5.4-mini ($0.75 / $4.50). Większe poziomy dla kontrastu: gpt-6.1-terra za $1 / $5 (omówiliśmy go w GPT-6.1 Terra API price), gpt-6.1-sol za $2 / $10 i gpt-6-astra za $10 / $50. Jedno zastrzeżenie z tej samej strony: punkty końcowe przetwarzania regionalnego mają 10% dopłaty dla modeli wydanych 5 marca 2026 lub później. Strona podaje tylko ceny, więc sprawdź stronę każdego modelu pod kątem rozmiaru kontekstu i limitów, zanim przeniesiesz zadanie.
Gdzie idą pieniądze w 1000 małych żądań#
Weź bota tagującego zgłoszenia. Każde żądanie wysyła około 500 tokenów (instrukcja plus zgłoszenie) i otrzymuje około 200 z powrotem. Na gpt-5-nano 1000 takich żądań kosztuje:
- Wejście: 0.5M tokenów × $0.05 = $0.025
- Wyjście: 0.2M tokenów × $0.40 = $0.08
- Razem: $0.025 + $0.08 = $0.105
Spójrz na podział. Krótka odpowiedź to mniej niż jedna trzecia tokenów, ale to $0.08 z $0.105. Na tym polega haczyk z szukaniem taniego modelu: cena wyjścia decyduje o rachunku częściej niż cena wejścia. Jeśli chcesz dłuższą wersję tego pomysłu, input vs output tokens omawia to szczegółowo.
OpenAI podaje również stawkę za wejście z cache: $0.005 za 1M dla gpt-5-nano (jak to działa, opisano w what is prompt caching). Załóżmy, że całe twoje 500-tokenowe wejście to powtarzający się prompt i zostaje zapisane w cache. Wejście spada do 0.5M × $0.005 = $0.0025, a zadanie kosztuje $0.0025 + $0.08 = $0.0825. Rachunek ledwo się zmienia, ponieważ 200 tokenów wyjściowych nadal kosztuje $0.08.
Wypróbuj tę samą arytmetykę w większej skali:
Zgadnij liczbę
Tagger wysyła 200 000 żądań dziennie do gpt-5-nano, każde z 500 tokenami wejściowymi i 200 wyjściowymi. Ile to dolarów dziennie?
Twoje przypuszczenie
0100
Pokaż odpowiedź
Odpowiedź: 21
$21. Wejście: 100M tokenów × $0.05 = $5. Wyjście: 40M tokenów × $0.40 = $16. Razem $5 + $16 = $21.
To samo zadanie na modelach open-weight#
Teraz te same 1000 żądań z 500 wejściowymi i 200 wyjściowymi, wycenione na CheapTokens według dzisiejszych stawek:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 tokenów wejściowych i 200 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W liczbach: GLM-5.3-Flash bierze $0.018, DeepSeek-V4-Flash $0.0275 i MiniMax-M2.7 $0.055. Zestaw to z $0.105 dla gpt-5-nano. Tabela jest aktualna, więc podąża za bieżącym cennikiem. GLM-5.3-Flash ma kontekst 390K i odpowiada do 8192 tokenów, co w zupełności wystarczy na tag lub krótką odpowiedź. DeepSeek-V4-Flash ma kontekst 380K i odpowiada do 32 768 tokenów, co ma znaczenie, gdy wyjściem jest raport lub długi fragment kodu. Oba mają jedną cenę o każdej porze, bez cen szczytowych.
Jeszcze jeden scenariusz, chatbot, który nadal działa na gpt-4o-mini. Załóżmy, że każda rozmowa wysyła około 1200 tokenów (historia plus nowe pytanie), otrzymuje 250 z powrotem, a ty obsługujesz 3000 rozmów dziennie. Na gpt-4o-mini to 3.6M tokenów wejściowych × $0.15 = $0.54 i 0.75M tokenów wyjściowych × $0.60 = $0.45, czyli $0.99 dziennie. Na gpt-5-nano ten sam dzień to 3.6M × $0.05 = $0.18 plus 0.75M × $0.40 = $0.30, czyli $0.48. Oto ten sam ruch na CheapTokens; zmień liczby, aby dopasować do swojego bota:
Kalkulator kosztów
Dzień chatbota: 3000 rozmów
Tokeny wejściowe na żądanie: 1200 · Tokeny wyjściowe na żądanie: 250 · Żądania dziennie: 3000
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
Przełączenie wymaga trzech małych zmian#
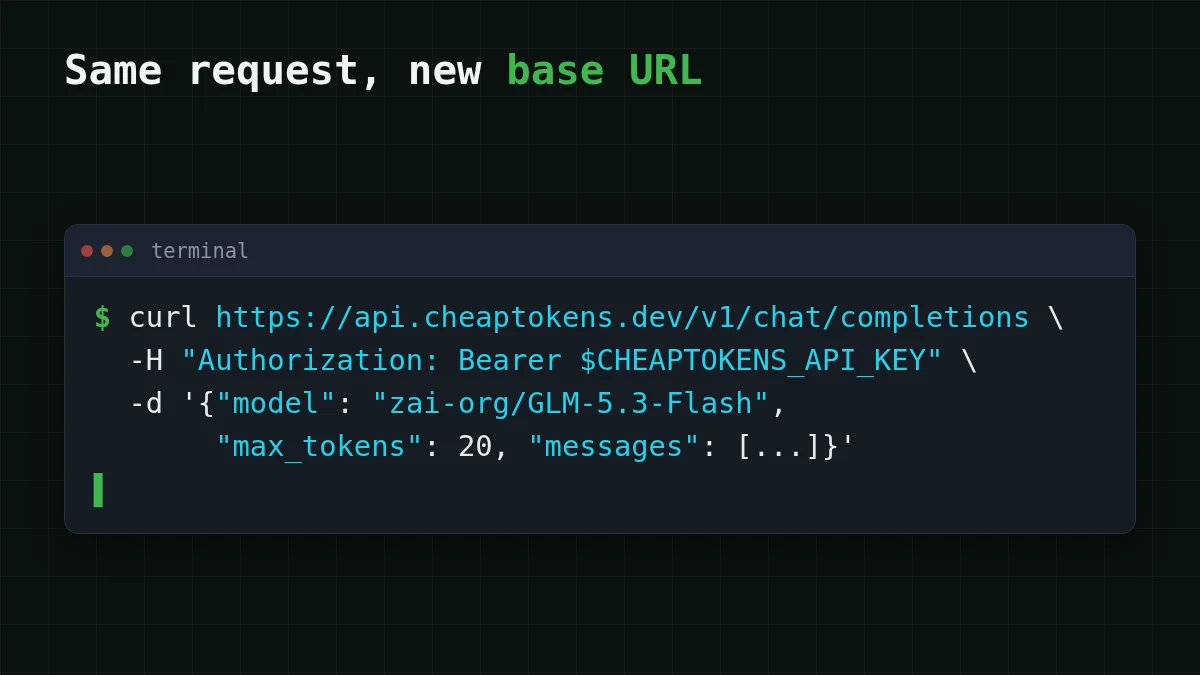
CheapTokens mówi w API OpenAI, więc twój kod nadal działa. Zmieniasz bazowy URL, klucz i identyfikator modelu. Weź identyfikator z dokumentacji, ponieważ dostawcy nazywają modele różnie. Dla GLM-5.3-Flash to zai-, a bazowy URL to https:/.
Jedno żądanie tagowania, dwa sposoby
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Uruchom to na 50 swoich prawdziwych zgłoszeniach i sam przeczytaj odpowiedzi. Pole usage w każdej odpowiedzi podaje dokładne liczby tokenów wejściowych i wyjściowych, a te dwie liczby to wszystko, czego potrzebuje powyższy kalkulator. Klucze, saldo i pierwsze wywołanie są w your first API request.
Który do jakiego zadania#
Wybierz swój przypadek
Co uruchamiasz?
Wybierz opcję, aby zobaczyć odpowiedź
Tagowanie lub klasyfikacja krótkich tekstów
Krótkie odpowiedzi, ogromny wolumen. W OpenAI najniższą cenę ma gpt-5-nano. W CheapTokens wypróbuj GLM-5.3-Flash: kontekst 390K, do 8192 tokenów wyjściowych, jedna cena o każdej porze.
Długie odpowiedzi: raporty, szkice, kod
Wypróbuj DeepSeek-V4-Flash. Pisze do 32 768 tokenów w jednej odpowiedzi i ma kontekst 380K.
Pętla agenta lub narzędzie do kodowania
Wypróbuj MiniMax-M2.7 lub DeepSeek-V4-Flash. Oba są na jednym saldzie z innymi modelami, więc możesz przełączać się między nimi bez nowego konta.
Musisz zostać przy OpenAI
Użyj gpt-5-nano dla najniższej ceny lub gpt-6-luna, jeśli chcesz najtańszy model z linii GPT-6. Jeśli używasz gpt-4o-mini, gpt-5-nano jest tańszy po obu stronach.
Niezależnie od wyboru, przetestuj go na własnych przykładach, zanim przeniesiesz całe obciążenie. Tabela cen mówi, ile kosztuje token; tylko twoje dane mówią, czy odpowiedzi są wystarczająco dobre. Aktualne ceny każdego modelu są na stronie cennika, a how much AI tokens cost zestawia budżety 1M i 10M tokenów obok siebie.


