Rozwiązywanie problemówPrzewodnik
Żądanie za długie: 400 vs 413, okno kontekstu i max_tokens
Odróżnij 413 (zbyt wiele bajtów) od błędu długości tokenów (zwykle 400), sprawdź wejście plus max_tokens względem okna kontekstu i zmniejsz żądanie.
Na tej stronie
Twoja rozmowa działała dobrze przez czterdzieści tur, a potem każde żądanie zaczęło zawodzić. Krótka odpowiedź: "request too long" ukrywa dwa różne limity. 413 oznacza, że żądanie jest za duże w bajtach i zostało odrzucone, zanim jakikolwiek model je zobaczył. Jeśli błąd narzeka na długość w tokenach (zwykle nieprawidłowe żądanie z klasy 400), twoje wejście plus odpowiedź, o którą prosisz, nie mieszczą się w oknie kontekstu; przeczytaj error.message, aby zobaczyć który. Rozwiązaniem jest zmierzyć, a potem przyciąć.
Ten przewodnik pokazuje, jak odróżnić oba przypadki, jak sprawdzić matematykę przed wysłaniem i cztery sposoby na zmniejszenie żądania. Jeśli termin jest nowy, czym jest okno kontekstu wyjaśnia to prostymi słowami.
Dwa limity, dwa błędy#
413 to poczta odmawiająca przyjęcia zbyt dużej paczki; błąd tokenów to model mówiący, że list nie zmieści się w jego oknie odczytu. Zawodzą w różnych miejscach i wymagają różnych poprawek.
Strona błędów API Anthropic (sprawdzona 29 października 2026) opisuje 413 request_ jako żądanie przekraczające maksymalną liczbę bajtów: 128 MB dla Messages API, 256 MB dla Batch API, 500 MB dla Files API. 400 invalid_ obejmuje problemy z formatem lub zawartością żądania. To są limity Anthropic. Ich strona nie wymienia komunikatu o liczbie tokenów, podobnie jak przewodnik po kodach błędów OpenAI, więc nie buduj logiki na dokładnym brzmieniu, które widziałeś w wątku na forum.
W praktyce rozmowy tylko tekstowe zwykle rosną w tokenach znacznie wcześniej niż w bajtach. Bajty stają się problemem, gdy dołączasz obrazy base64 lub całe dokumenty. Tokeny stają się problemem, gdy rośnie historia, i to jest typowy przypadek.
Dopasuj pary
Dopasuj każdy objaw do jego przyczyny
Dotknij element po lewej, a następnie jego parę
- 413 request_too_largeTreść ma zbyt wiele bajtów, na przykład duży załącznik base64
- Błąd długości tokenów zaraz po wklejeniu ogromnego loguSam prompt ma więcej tokenów niż okno kontekstu
- 400 po prompcie około 375K tokenów z max_tokens=32768 na modelu 380KRazem mogą przekroczyć okno
- Ta sama historia, inny modelSprawdź okno każdego modelu: historia, która mieści się w jednym, może nie mieścić się w innym
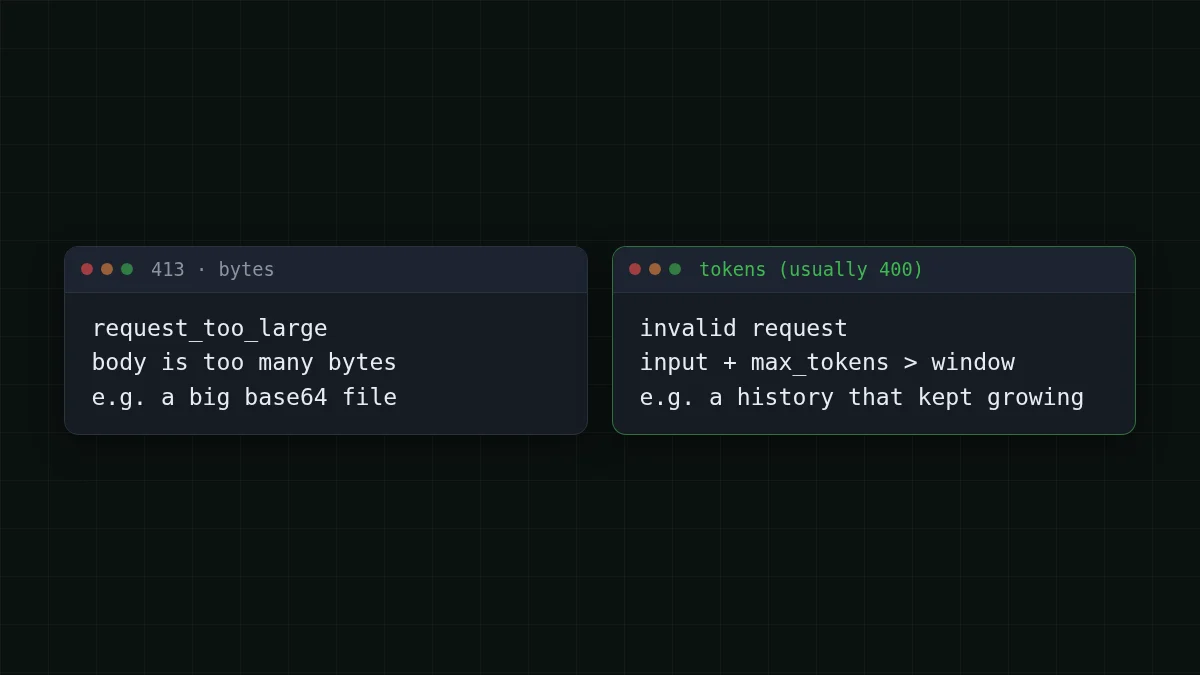
Treść błędu to JSON z najwyższego poziomu type: error, obiektem error z własnym type i message oraz identyfikatorem żądania. Przeczytaj error.message i zachowaj identyfikator żądania; w oficjalnych SDK przechwytuj typowany wyjątek zamiast dopasowywać ciągi znaków.
Sprawdź matematykę przed wysłaniem#
Nawyk, który oszczędza najwięcej czasu: nie czekaj na błąd. Przed każdym wywołaniem zsumuj trzy rzeczy i porównaj je z oknem.
- Tokeny w twoich wiadomościach (prompt systemowy, historia, nowe pytanie).
max_tokens, o który prosisz.- Okno kontekstu modelu.
Trzymaj wejście plus żądaną odpowiedź w oknie. Okna w CheapTokens to 390K dla GLM-5.3-Flash, 380K dla DeepSeek-V4-Flash i 180K dla MiniMax-M2.7; odpowiedzi sięgają do 8 192 tokenów w GLM i MiniMax oraz do 32 768 w DeepSeek-V4-Flash. Sprawdź strony cen i modeli, aby zobaczyć aktualną listę.
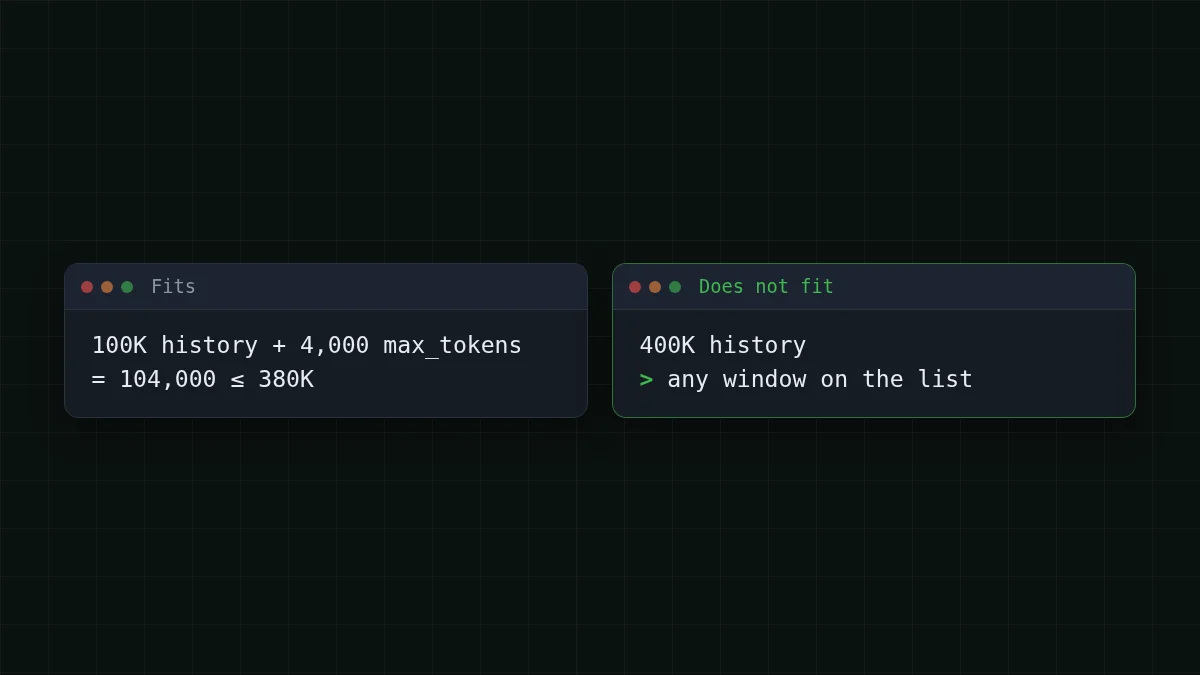
Powiedzmy, że twój agent wysyła historię 100K tokenów i prosi o 4 000 tokenów odpowiedzi. To 100 000 + 4 000 = 104 000 tokenów, komfortowo w każdym z trzech. Teraz ten sam agent po kolejnych pięćdziesięciu krokach: 400K. Żadne okno z listy tego nie przyjmie, niezależnie od tego, jaki max_tokens ustawisz. To jest moment, w którym pojawia się błąd, i wygląda nagle tylko dlatego, że historia rosła trochę z każdą turą.
Przybliżony licznik wystarczy jako zabezpieczenie. Tekst angielski ma średnio około 4 znaków na token; kod i tekst nieangielski zużywają więcej tokenów na znak, więc zostaw margines:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Ostatnia linia to twoja kalibracja: usage. to, co API faktycznie policzyło. Porównaj to z rough_ kilka razy i dostosuj dzielnik oraz margines do własnego tekstu.
Cztery sposoby na zmniejszenie żądania#
Wybierz najtańszą poprawkę, która działa, w tej kolejności.
1. Obniż max_tokens. Proś tylko o odpowiedź, której potrzebujesz: wejście plus max_tokens to, co musisz utrzymać w oknie, a każdy model ma własny limit odpowiedzi (8 192 lub 32 768 tokenów powyżej). Nie ustawiaj max_tokens wyżej, niż wymaga odpowiedź, i nie powyżej limitu modelu na odpowiedzi. Jeśli odpowiedź zatrzyma się na ustawionym limicie, kończy się finish_, co ma własne rozwiązanie.
2. Przytnij historię. Odrzuć najstarsze tury, zachowaj prompt systemowy i kilka ostatnich wymian. Funkcja trim powyżej robi dokładnie to. W przypadku agenta odetnij też masę: wyniki narzędzi o 5 000 linii rzadko muszą pozostać w całości po tym, jak agent ich użył.
3. Podsumuj zamiast odrzucać. Gdy stare tury mają znaczenie, poproś model raz o skompresowanie ich do krótkiej notatki, a następnie zastąp stare wiadomości tą notatką. Płacisz za jedno dodatkowe wywołanie i zachowujesz wątek.
4. Przełącz się na większe okno. Przejście z MiniMax-M2.7 (180K) na GLM-5.3-Flash (390K) lub DeepSeek-V4-Flash (380K) to zmiana identyfikatora modelu w jednej linii. Jeśli potrzebujesz też długich odpowiedzi, DeepSeek-V4-Flash pozwala na do 32 768 tokenów wyjściowych, a wszystkie trzy dzielą jedno saldo, więc przełączenie nic nie kosztuje w konfiguracji.
Lista kontrolna
Zanim ponownie wyślesz nieudane żądanie
Ile kosztuje długa historia#
Przycinanie to nie tylko kwestia błędów. Każdy krok agenta ponownie wysyła całą historię, więc rozdęta historia to także kosztowna część rachunku. Weź zadanie 30 kroków, gdzie każdy krok wysyła około 100K tokenów i otrzymuje około 1 500 z powrotem:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 30 żądań | OpenRouter, 30 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100 000 tokenów wejściowych i 1500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Tabela wycenia to samo zadanie na każdym modelu według aktualnych stawek. Przytnij historię do jednej czwartej, a strona wejściowa spadnie o około trzy czwarte. Aby zobaczyć, gdzie twój własny agent zużywa tokeny, śledź użycie na żądanie w Pythonie; co do mechaniki, dlaczego agenci zużywają tak wiele tokenów przechodzi przez przykład 20 kroków.
DeepSeek-V4-Flash kosztuje obecnie $0.015 za 1M tokenów wejściowych i $0.10 za 1M tokenów wyjściowych, jedna cena o każdej porze. Wypróbuj własne liczby:
Kalkulator kosztów
Zadanie agenta 30 kroków z historią 100K
Tokeny wejściowe na żądanie: 100 000 · Tokeny wyjściowe na żądanie: 1500 · Żądania dziennie: 30
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Jeśli nadal zawodzi#
Długie żądania przez wolne łącze mają osobną awarię: Anthropic zaleca strumieniowanie lub Batch API dla długich żądań z dużym max_tokens, ponieważ sieci mogą zrywać bezczynne połączenia, a jego SDK oczekują, że żądania niestrumieniowe zakończą się w ciągu 10 minut. Jeśli błąd to przekroczenie limitu czasu lub zerwane połączenie, a nie 400, zobacz błędy połączenia i ustaw stream=True.
Jeśli komunikat to 401 lub 404, problemem jest klucz, bazowy URL lub identyfikator modelu: błąd API 401 lub 404. Aby poznać dokładny bazowy URL, identyfikatory modeli i przykłady, otwórz dokumentację CheapTokens.


