Pemecahan masalahPanduan
Permintaan terlalu panjang: 400 vs 413, jendela konteks dan max_tokens
Bedakan 413 (terlalu banyak byte) dari kesalahan panjang token (biasanya 400), periksa input plus max_tokens terhadap jendela konteks, dan perkecil permintaan.
Di halaman ini
Obrolan Anda berjalan lancar selama empat puluh giliran, lalu setiap permintaan mulai gagal. Jawaban singkatnya: "request too long" menyembunyikan dua batas yang berbeda. 413 berarti permintaan terlalu besar dalam byte dan ditolak sebelum model mana pun melihatnya. Jika kesalahan mengeluh tentang panjang dalam token (biasanya permintaan tidak valid kelas 400), input Anda ditambah jawaban yang Anda minta tidak muat di jendela konteks; baca error.message untuk melihat yang mana. Perbaikannya adalah mengukur, lalu memangkas.
Panduan ini menunjukkan cara membedakan keduanya, cara memeriksa perhitungan sebelum mengirim, dan empat cara memperkecil permintaan. Jika istilahnya baru, apa itu jendela konteks membahasnya dengan kata-kata sederhana.
Dua batas, dua kesalahan#
413 adalah kantor pos yang menolak paket yang terlalu besar; kesalahan token adalah model yang mengatakan surat tidak akan muat di jendela bacaannya. Keduanya gagal di tempat berbeda dan memerlukan perbaikan berbeda.
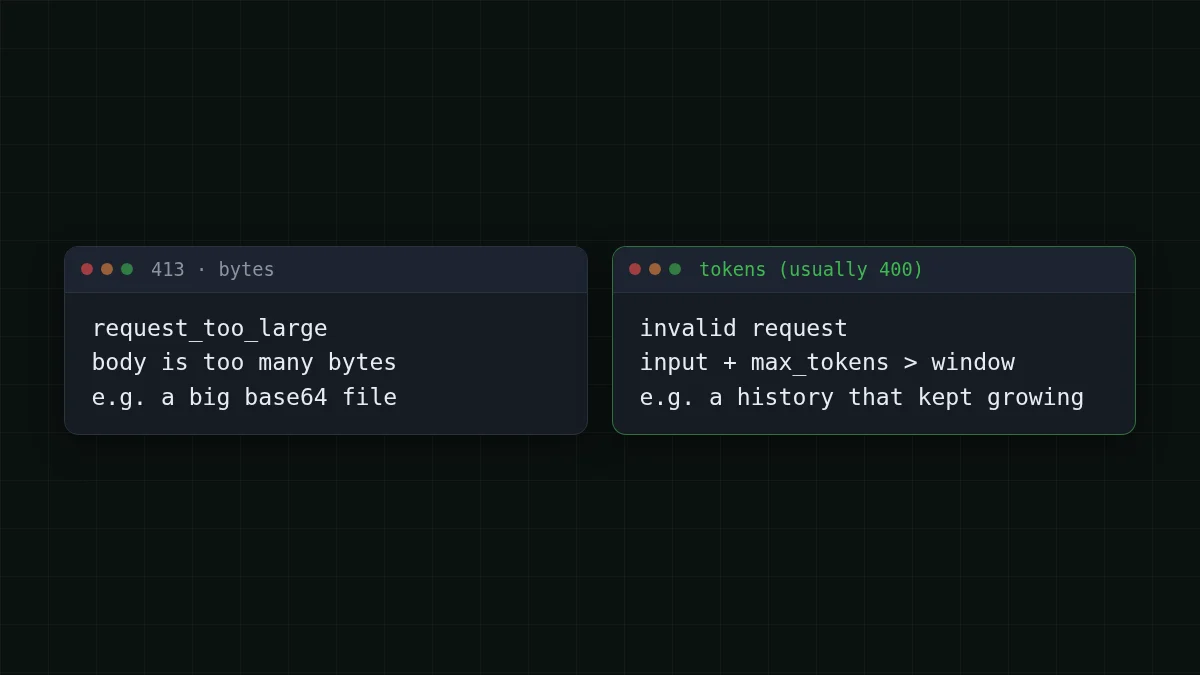
Halaman kesalahan API Anthropic (diperiksa 29 Oktober 2026) menjelaskan 413 request_ sebagai permintaan yang melebihi jumlah byte maksimum: 128 MB untuk Messages API, 256 MB untuk Batch API, 500 MB untuk Files API. 400 invalid_ mencakup masalah dengan format atau konten permintaan. Itu adalah batas Anthropic. Halaman mereka tidak mencantumkan pesan jumlah token, dan panduan kode kesalahan OpenAI juga tidak, jadi jangan membangun logika berdasarkan kata-kata persis yang Anda lihat di utas forum.
Dalam praktiknya, obrolan teks-saja biasanya tumbuh dalam token jauh sebelum byte. Byte menjadi masalah ketika Anda melampirkan gambar base64 atau seluruh dokumen. Token menjadi masalah ketika riwayat tumbuh, dan itu adalah kasus umum.
Cocokkan pasangan
Cocokkan setiap gejala dengan penyebabnya
Ketuk item di kiri, lalu pasangannya
- 413 request_too_largeBody terlalu banyak byte, misalnya lampiran base64 yang besar
- Kesalahan panjang token tepat setelah menempelkan log besarPrompt saja sudah lebih banyak token daripada jendela konteks
- 400 setelah prompt sekitar 375K token dengan max_tokens=32768 pada model 380KBersama-sama mereka bisa melebihi jendela
- Riwayat sama, model berbedaPeriksa jendela masing-masing model: riwayat yang muat di satu model mungkin tidak muat di model lain
Badan kesalahan adalah JSON dengan type: error tingkat atas, objek error dengan type dan message sendiri, dan id permintaan. Baca error.message dan simpan id permintaan; dengan SDK resmi, tangkap pengecualian bertipe alih-alih mencocokkan string.
Periksa perhitungan sebelum mengirim#
Kebiasaan yang paling menghemat waktu: jangan menunggu kesalahan. Sebelum setiap panggilan, jumlahkan tiga hal dan bandingkan dengan jendela.
- Token dalam pesan Anda (system prompt, riwayat, pertanyaan baru).
max_tokensyang Anda minta.- Jendela konteks model.
Jaga input plus jawaban yang diminta tetap di dalam jendela. Jendela di CheapTokens adalah 390K untuk GLM-5.3-Flash, 380K untuk DeepSeek-V4-Flash dan 180K untuk MiniMax-M2.7; jawaban hingga 8.192 token pada GLM dan MiniMax dan hingga 32.768 pada DeepSeek-V4-Flash. Periksa halaman harga dan model untuk daftar terkini.
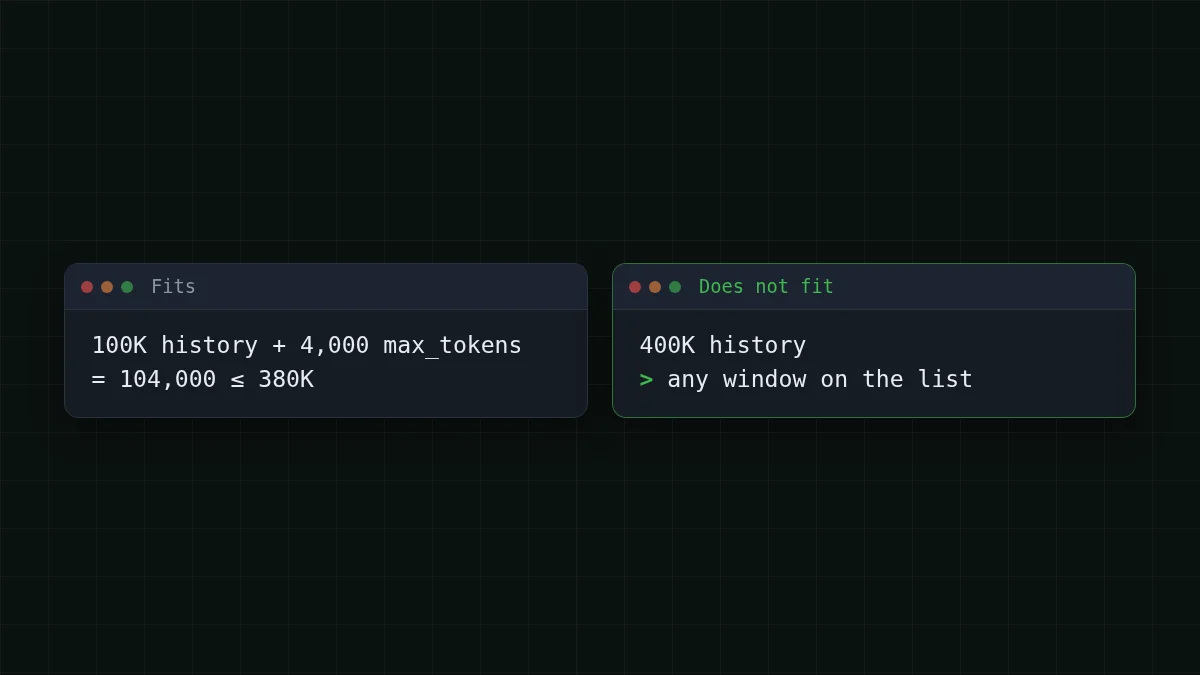
Katakan agen Anda mengirim riwayat 100K token dan meminta 4.000 token kembali. Itu 100.000 + 4.000 = 104.000 token, nyaman di salah satu dari ketiganya. Sekarang agen yang sama setelah lima puluh langkah lagi: 400K. Tidak ada jendela dalam daftar yang menerimanya, berapa pun max_tokens yang Anda setel. Itulah momen kesalahan muncul, dan tampak mendadak hanya karena riwayat tumbuh sedikit setiap giliran.
Penghitung kasar cukup untuk penjaga. Teks bahasa Inggris rata-rata sekitar 4 karakter per token; kode dan teks non-Inggris menggunakan lebih banyak token per karakter, jadi beri margin:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CONTEXT = 380_000      # DeepSeek-V4-Flash window
MAX_OUT = 4_000        # the answer you ask for
MARGIN = 0.85          # rough counter, keep 15% spare

def rough_tokens(messages):
    return sum(len(m['content']) // 4 + 4 for m in messages)

def trim(messages):
    budget = int(CONTEXT * MARGIN) - MAX_OUT
    system, rest = messages[:1], messages[1:]
    while rest and rough_tokens(system + rest) > budget:
        rest.pop(0)          # drop the oldest turn first
    return system + rest

history = [{'role': 'system', 'content': '...'}, {'role': 'user', 'content': '...'}]  # system first

reply = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=trim(history),
    max_tokens=MAX_OUT,
)
print(reply.usage.prompt_tokens, reply.choices[0].finish_reason)
Baris terakhir adalah kalibrasi Anda: usage. adalah yang sebenarnya dihitung API. Bandingkan dengan rough_ beberapa kali dan sesuaikan pembagi dan margin dengan teks Anda sendiri.
Empat cara memperkecil permintaan#
Pilih perbaikan termurah yang berhasil, dalam urutan ini.
1. Turunkan max_tokens. Minta hanya jawaban yang Anda butuhkan: input plus max_tokens adalah yang harus Anda jaga di dalam jendela, dan setiap model memiliki batas sendiri pada jawaban (8.192 atau 32.768 token di atas). Jangan setel max_tokens lebih tinggi dari yang dibutuhkan jawaban, dan tidak di atas batas model pada jawaban. Jika jawaban berhenti pada batas yang Anda setel, itu berakhir dengan finish_, yang memiliki perbaikan sendiri.
2. Pangkas riwayat. Buang giliran tertua, pertahankan system prompt dan beberapa pertukaran terakhir. Fungsi trim di atas melakukan hal ini. Untuk agen, juga potong bagian besar: output alat 5.000 baris jarang perlu disimpan penuh setelah agen menggunakannya.
3. Ringkas alih-alih membuang. Ketika giliran lama penting, minta model sekali untuk memadatkannya menjadi catatan singkat, lalu ganti pesan lama dengan catatan itu. Anda membayar satu panggilan ekstra dan mempertahankan utas.
4. Beralih ke jendela lebih besar. Beralih dari MiniMax-M2.7 (180K) ke GLM-5.3-Flash (390K) atau DeepSeek-V4-Flash (380K) adalah perubahan satu baris pada id model. Jika Anda juga memerlukan jawaban panjang, DeepSeek-V4-Flash memungkinkan hingga 32.768 token output, dan ketiganya berbagi satu saldo, jadi beralih tidak memakan biaya penyiapan.
Daftar periksa
Sebelum mengirim ulang permintaan yang gagal
Berapa biaya riwayat panjang#
Memangkas bukan hanya soal kesalahan. Setiap langkah agen mengirim ulang seluruh riwayat, jadi riwayat yang membengkak juga bagian mahal dari tagihan. Ambil tugas 30 langkah di mana setiap langkah mengirim sekitar 100K token dan mendapat sekitar 1.500 kembali:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 30 permintaan | OpenRouter, 30 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0021 | $0.0618 | $0.127 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0017 | $0.0495 | $0.15 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0052 | $0.157 | $0.954 |
100.000 token input dan 1.500 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Tabel tersebut memberi harga tugas yang sama pada setiap model dengan tarif langsung. Potong riwayat menjadi seperempat dan sisi input turun sekitar tiga perempat. Untuk melihat di mana agen Anda sendiri menghabiskan token, lacak penggunaan per permintaan di Python; untuk mekanismenya, mengapa agen menggunakan begitu banyak token membahas contoh 20 langkah.
DeepSeek-V4-Flash saat ini berbiaya $0.015 per 1 juta token input dan $0.10 per 1 juta token output, satu harga kapan pun. Coba angka Anda sendiri:
Kalkulator biaya
Tugas agen 30 langkah dengan riwayat 100K
Token input per permintaan: 100.000 · Token output per permintaan: 1.500 · Permintaan per hari: 30
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0618 | $1.85 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0495 | $1.49 |
| MiniMax-M2.7$0.05$0.15 | $0.157 | $4.70 |
Jika masih gagal#
Permintaan panjang melalui tautan lambat memiliki kegagalan terpisah: Anthropic menyarankan streaming atau Batch API untuk permintaan panjang dengan max_tokens besar, karena jaringan dapat memutus koneksi idle, dan SDK-nya mengharapkan permintaan non-streaming selesai dalam 10 menit. Jika kesalahan adalah timeout atau koneksi terputus alih-alih 400, lihat kesalahan koneksi dan setel stream=True.
Jika pesannya adalah 401 atau 404, masalahnya adalah kunci, base URL atau id model: kesalahan API 401 atau 404. Untuk base URL persis, id model dan contoh, buka dokumentasi CheapTokens.


