Modelle & VergleicheVergleich
Günstigstes OpenAI-API-Modell 2026: gpt-5-nano vs gpt-6-luna
OpenAIs günstigste API-Modelle mit offiziellen Preisen, geprüft am 28. Okt. 2026, und was dieselben 1.000 Requests auf Open-Weight-Modellen kosten.
Auf dieser Seite
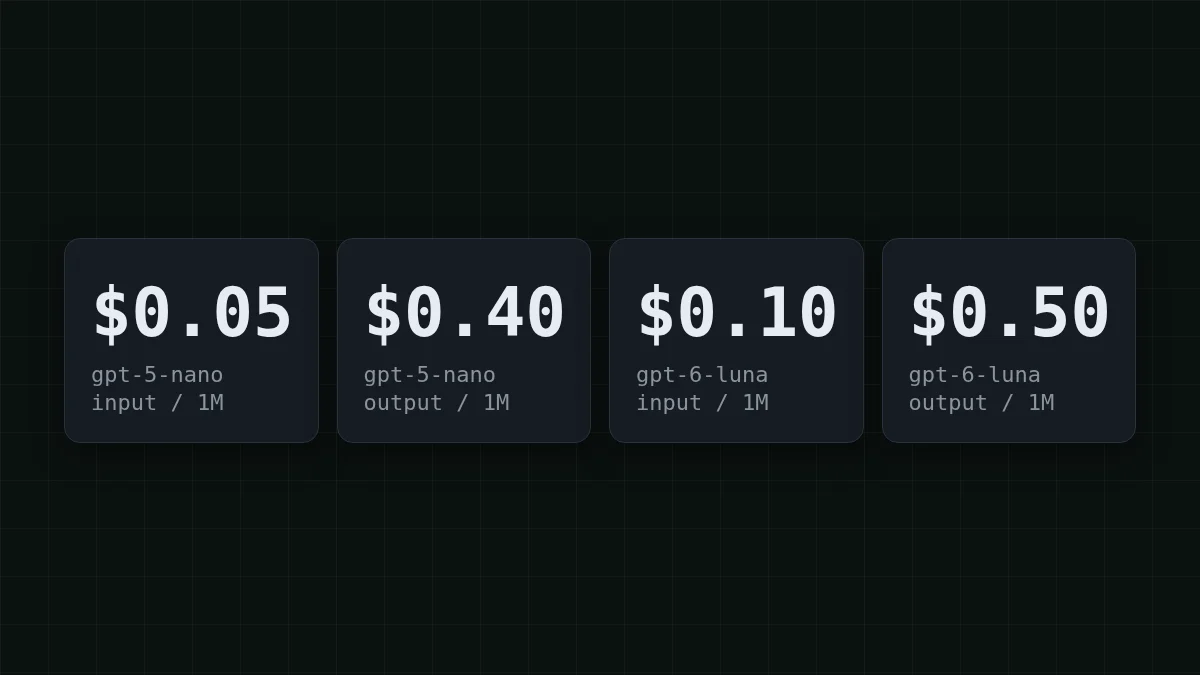
Das günstigste OpenAI-Textmodell auf der Preisseite ist gpt-5-nano: $0.05 pro 1M Input-Tokens und $0.40 pro 1M Output-Tokens. Innerhalb der neueren GPT-6-Reihe ist gpt-6-luna mit $0.10 Input und $0.50 Output das günstigste. Diese Zahlen stammen von OpenAIs Preisseite, geprüft am 28. Oktober 2026. Die Seite trägt kein Veröffentlichungsdatum, daher ist das Prüfdatum maßgeblich.
Ein niedriger Preis pro Token ist aber nicht dasselbe wie ein niedriger Preis pro Aufgabe. Bei kleinen, hochvolumigen Jobs kommen Open-Weight-Modelle auf CheapTokens wie GLM-5.3-Flash und DeepSeek-V4-Flash in der Summe günstiger weg. Unten siehst du das an einer konkreten Aufgabe, danach setzt du deine eigenen Zahlen ein.
Die OpenAI-Preisleiter von unten#
Alle Preise pro 1M Tokens, Standard-Tier, kurzer Kontext (bis zu 272K Input-Tokens). Die letzte Spalte ist eine Berechnung für eine konkrete Aufgabe: 1.000 Requests mit je 500 Input- und 200 Output-Tokens. Denk an einen Support-Bot, der Tickets taggt.
Tabelle nach rechts scrollen →
| Modell | Input | Output | Gecachter Input | 1.000 Requests (500 in / 200 out) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
Zwei Dinge fallen auf. Erstens hat gpt-5-nano den niedrigsten Input-Preis und liegt beim Output gleichauf mit gpt-4.1-nano; wenn du bei OpenAI bleibst und die Aufgabe einfach ist, ist es der Ausgangspunkt. Zweitens kostet gpt-4o-mini, das viele Projekte als günstiges Modell gewählt haben, inzwischen mehr als gpt-5-nano, sowohl beim Input als auch beim Output. Wenn das dein Modell ist, hast du eine günstigere Option, ohne OpenAI zu verlassen.
Über der Tabelle stehen gpt-4.1-mini ($0.40 / $1.60) und gpt-5.4-mini ($0.75 / $4.50). Größere Tiers zum Vergleich: gpt-6.1-terra mit $1 / $5 (behandelt in GPT-6.1 Terra API price), gpt-6.1-sol mit $2 / $10 und gpt-6-astra mit $10 / $50. Ein Hinweis von derselben Seite: Endpunkte für regionale Verarbeitung kosten 10% Aufschlag für Modelle, die am oder nach dem 5. März 2026 veröffentlicht wurden. Die Seite listet nur Preise, prüfe also vor dem Umzug einer Aufgabe die jeweilige Modellseite auf Kontextgröße und Limits.
Wohin das Geld bei 1.000 kleinen Requests fließt#
Nimm den Ticket-Tagging-Bot. Jeder Request sendet etwa 500 Tokens (die Anweisung plus das Ticket) und bekommt etwa 200 zurück. Auf gpt-5-nano kosten 1.000 davon:
- Input: 0.5M Tokens × $0.05 = $0.025
- Output: 0.2M Tokens × $0.40 = $0.08
- Gesamt: $0.025 + $0.08 = $0.105
Schau auf die Aufteilung. Die kurze Antwort macht weniger als ein Drittel der Tokens aus, kostet aber $0.08 der $0.105. Das ist der Haken beim Schnäppchenjagen bei Modellen: Der Output-Preis entscheidet häufiger über die Rechnung als der Input-Preis. Wenn du die längere Version dieser Idee willst, geht input vs output tokens darauf ein.
OpenAI nennt außerdem einen Preis für gecachten Input: $0.005 pro 1M für gpt-5-nano (wie das funktioniert, steht in what is prompt caching). Angenommen, dein gesamter 500-Token-Input ist ein wiederholter Prompt und wird gecacht. Der Input sinkt auf 0.5M × $0.005 = $0.0025, und die Aufgabe kostet $0.0025 + $0.08 = $0.0825. Die Rechnung bewegt sich kaum, weil die 200 Output-Tokens weiterhin $0.08 kosten.
Probiere dieselbe Rechnung in größerem Maßstab:
Zahl erraten
Ein Tagger sendet 200.000 Requests pro Tag an gpt-5-nano, jeder mit 500 Tokens Input und 200 Output. Wie viele Dollar sind das pro Tag?
Deine Schätzung
0100
Antwort anzeigen
Antwort: 21
$21. Input: 100M Tokens × $0.05 = $5. Output: 40M Tokens × $0.40 = $16. Gesamt $5 + $16 = $21.
Dieselbe Aufgabe auf Open-Weight-Modellen#
Jetzt dieselben 1.000 Requests mit 500 Input und 200 Output, bepreist auf CheapTokens zu heutigen Sätzen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 Input- und 200 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
In Zahlen: GLM-5.3-Flash kostet $0.018, DeepSeek-V4-Flash $0.0275 und MiniMax-M2.7 $0.055. Stell das neben die $0.105 für gpt-5-nano. Die Tabelle ist live und folgt der aktuellen Preisliste. GLM-5.3-Flash hat einen 390K-Kontext und antwortet mit bis zu 8.192 Tokens, was für ein Tag oder eine kurze Antwort reichlich ist. DeepSeek-V4-Flash hat einen 380K-Kontext und antwortet mit bis zu 32.768 Tokens, was zählt, wenn die Ausgabe ein Bericht oder ein langes Stück Code ist. Beide halten einen Preis zu jeder Stunde, ohne Peak-Pricing.
Noch ein Szenario: ein Chatbot, der noch auf gpt-4o-mini läuft. Angenommen, jeder Chat sendet etwa 1.200 Tokens (Verlauf plus die neue Frage), bekommt 250 zurück, und du bedienst 3.000 Chats pro Tag. Auf gpt-4o-mini sind das 3.6M Input-Tokens × $0.15 = $0.54 und 0.75M Output-Tokens × $0.60 = $0.45, also $0.99 pro Tag. Auf gpt-5-nano kostet derselbe Tag 3.6M × $0.05 = $0.18 plus 0.75M × $0.40 = $0.30, also $0.48. Hier derselbe Traffic auf CheapTokens; ändere die Zahlen passend zu deinem Bot:
Kostenrechner
Ein Chatbot-Tag: 3.000 Chats
Eingabe-Tokens pro Anfrage: 1.200 · Ausgabe-Tokens pro Anfrage: 250 · Anfragen pro Tag: 3.000
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
Der Wechsel besteht aus drei kleinen Änderungen#
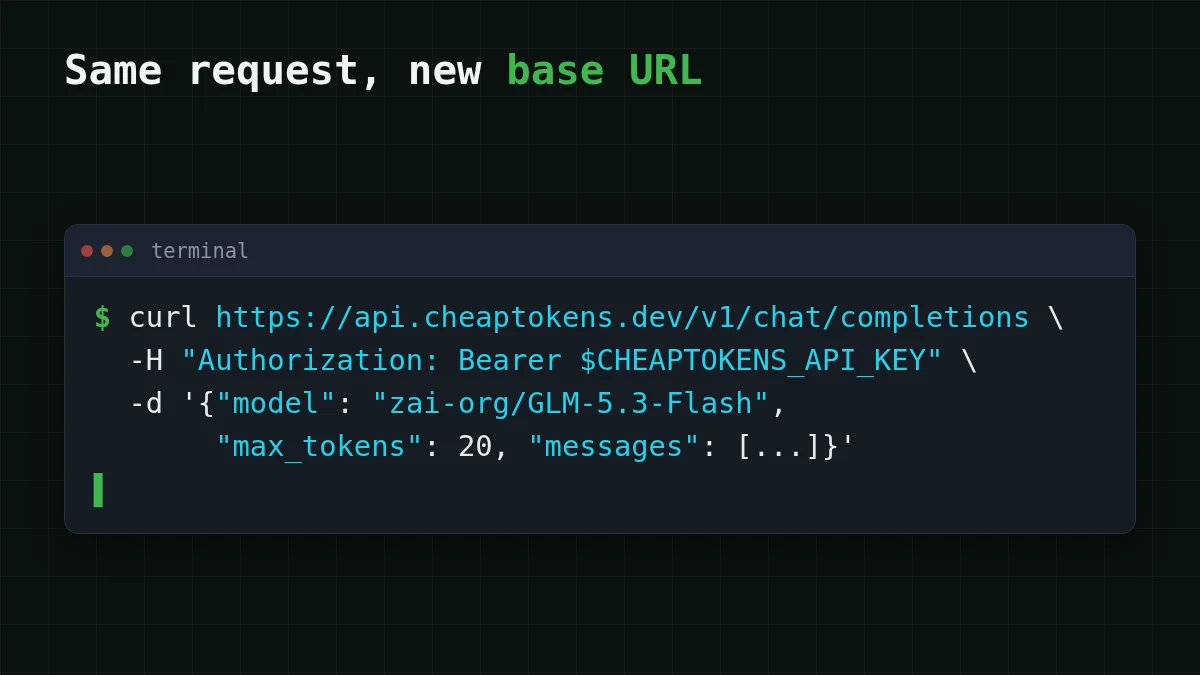
CheapTokens spricht die OpenAI-API, dein bestehender Code funktioniert also weiter. Du änderst die Base-URL, den Key und die Modell-ID. Nimm die ID aus der docs, denn Anbieter benennen Modelle unterschiedlich. Für GLM-5.3-Flash ist es zai-, und die Base-URL ist https:/.
Ein Tagging-Request, zwei Wege
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Lass es auf 50 deiner echten Tickets laufen und lies die Antworten selbst. Das Feld usage in jeder Antwort liefert die exakten Input- und Output-Token-Zahlen, und diese beiden Zahlen braucht der Rechner oben nur. Keys, Guthaben und der erste Aufruf stehen in your first API request.
Welches für welche Aufgabe#
Wähle deinen Fall
Was betreibst du?
Wähle eine Option, um die Antwort zu sehen
Kurze Texte taggen oder klassifizieren
Kurze Antworten, riesiges Volumen. Auf OpenAI ist gpt-5-nano am günstigsten. Auf CheapTokens probier GLM-5.3-Flash: 390K-Kontext, bis zu 8.192 Output-Tokens, ein Preis zu jeder Stunde.
Lange Antworten: Berichte, Entwürfe, Code
Probier DeepSeek-V4-Flash. Es schreibt bis zu 32.768 Tokens in einer Antwort und hat einen 380K-Kontext.
Eine Agent-Schleife oder ein Coding-Tool
Probier MiniMax-M2.7 oder DeepSeek-V4-Flash. Beide liegen mit den anderen Modellen auf einem Guthaben, du kannst also zwischen ihnen wechseln, ohne ein neues Konto.
Du musst bei OpenAI bleiben
Nimm gpt-5-nano für den niedrigsten Preis oder gpt-6-luna, wenn du das günstigste Modell der GPT-6-Reihe willst. Wenn du auf gpt-4o-mini bist, ist gpt-5-nano auf beiden Seiten günstiger.
Was du auch wählst, teste es an deinen eigenen Beispielen, bevor du die ganze Last umziehst. Die Preistabelle sagt dir, was ein Token kostet; nur deine Daten sagen dir, ob die Antworten gut genug sind. Aktuelle Preise für jedes Modell stehen auf der pricing page, und how much AI tokens cost stellt 1M- und 10M-Token-Budgets nebeneinander.


