โมเดลและการเปรียบเทียบการเปรียบเทียบ
โมเดล OpenAI API ที่ถูกที่สุดในปี 2026: gpt-5-nano vs gpt-6-luna
โมเดล OpenAI API ที่ถูกที่สุดพร้อมราคาทางการที่ตรวจสอบเมื่อ 28 ต.ค. 2026 และ 1,000 คำขอเดียวกันมีค่าใช้จ่ายเท่าไรบนโมเดล open-weight
ในหน้านี้
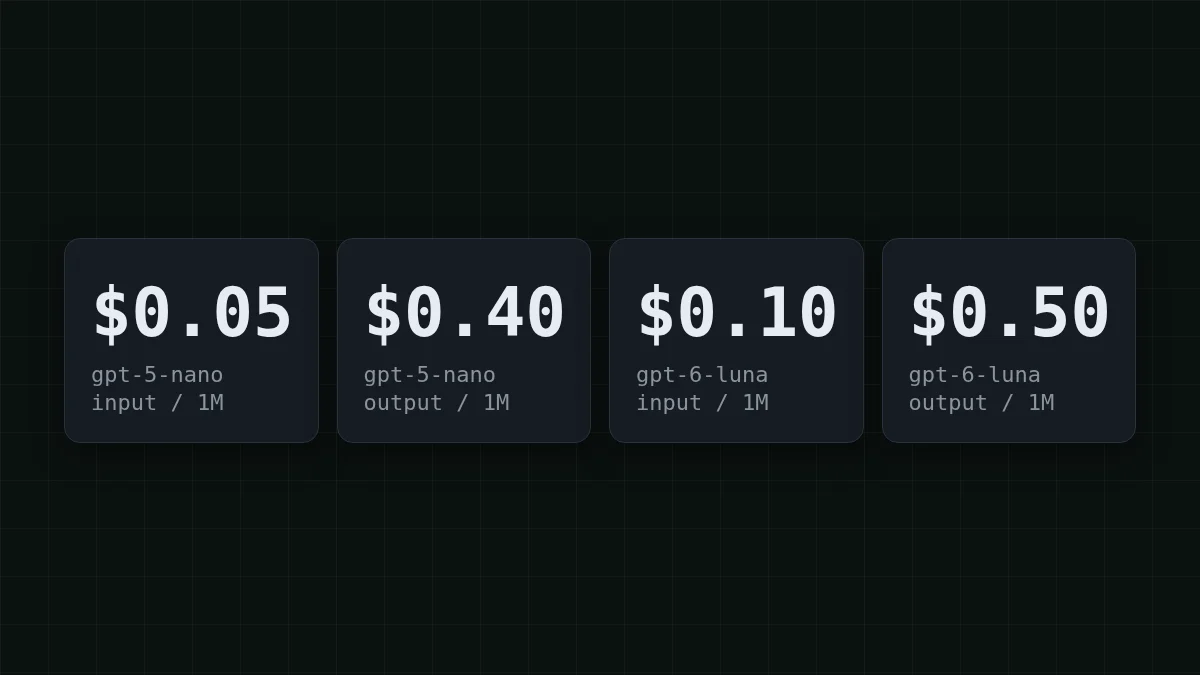
โมเดลข้อความ OpenAI ที่ถูกที่สุดบนหน้าค่าราคาคือ gpt-5-nano: $0.05 ต่อ 1M input tokens และ $0.40 ต่อ 1M output tokens ในสาย GPT-6 ที่ใหม่กว่า ตัวที่ถูกที่สุดคือ gpt-6-luna ที่ $0.10 ขาเข้าและ $0.50 ขาออก ตัวเลขเหล่านี้มาจากหน้าค่าราคาของ OpenAI ซึ่งตรวจสอบเมื่อ 28 ตุลาคม 2026 หน้าเว็บไม่มีวันที่เผยแพร่ ดังนั้นวันที่ตรวจสอบคือสิ่งที่ควรเชื่อถือ
แต่ราคาต่อ token ที่ต่ำไม่เหมือนกับราคาต่อ task ที่ต่ำ สำหรับงานเล็กๆ ที่มีปริมาณมาก โมเดล open-weight บน CheapTokens เช่น GLM-5.3-Flash และ DeepSeek-V4-Flash ออกมาต่ำกว่าในภาพรวม ด้านล่างคุณจะเห็นกับงานจริงหนึ่งงาน แล้วใส่ตัวเลขของคุณเอง
บันไดราคาของ OpenAI จากล่างขึ้นบน#
ราคาทั้งหมดต่อ 1M tokens, ระดับมาตรฐาน, context สั้น (สูงสุด 272K input tokens) คอลัมน์สุดท้ายคือการคำนวณสำหรับงานจริงหนึ่งงาน: 1,000 คำขอ แต่ละคำขอมี 500 input และ 200 output tokens ลองนึกถึงบอทซัพพอร์ตที่ติดแท็กตั๋ว
เลื่อนตารางไปทางขวา →
| โมเดล | Input | Output | Cached input | 1,000 คำขอ (500 เข้า / 200 ออก) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
มีสองสิ่งที่เด่นชัด อย่างแรก gpt-5-nano มีราคา input ต่ำที่สุดและเสมอกับ gpt-4.1-nano ที่ output ดังนั้นถ้าคุณอยู่กับ OpenAI และงานเรียบง่าย มันคือจุดเริ่มต้น อย่างที่สอง gpt-4o-mini ซึ่งหลายโปรเจกต์เลือกเป็นโมเดลราคาถูก ตอนนี้แพงกว่า gpt-5-nano ทั้ง input และ output ถ้านั่นคือโมเดลของคุณ คุณมีตัวเลือกที่ถูกกว่าโดยไม่ต้องออกจาก OpenAI
เหนือตารางขึ้นไปคือ gpt-4.1-mini ($0.40 / $1.60) และ gpt-5.4-mini ($0.75 / $4.50) ระดับที่ใหญ่ขึ้นเพื่อเปรียบเทียบ: gpt-6.1-terra ที่ $1 / $5 (เราเขียนถึงใน ราคา GPT-6.1 Terra API), gpt-6.1-sol ที่ $2 / $10 และ gpt-6-astra ที่ $10 / $50 ข้อควรระวังหนึ่งจากหน้าเดียวกัน: endpoint ประมวลผลระดับภูมิภาคมีราคาบวกเพิ่ม 10% สำหรับโมเดลที่เปิดตัวในหรือหลัง 5 มีนาคม 2026 หน้าเว็บแสดงเฉพาะราคา ดังนั้นตรวจสอบหน้าของแต่ละโมเดลสำหรับขนาด context และขีดจำกัดก่อนย้ายงาน
เงินไปไหนใน 1,000 คำขอเล็กๆ#
ลองบอทติดแท็กตั๋ว แต่ละคำขอส่งประมาณ 500 tokens (คำสั่งบวกตั๋ว) และได้กลับมาประมาณ 200 บน gpt-5-nano 1,000 คำขอมีค่าใช้จ่าย:
- Input: 0.5M tokens × $0.05 = $0.025
- Output: 0.2M tokens × $0.40 = $0.08
- รวม: $0.025 + $0.08 = $0.105
ดูการแบ่งสัดส่วน คำตอบสั้นๆ ใช้ไม่ถึงหนึ่งในสามของ tokens แต่เป็น $0.08 จาก $0.105 นั่นคือจุดสำคัญของการเลือกซื้อโมเดลราคาถูก: ราคา output ตัดสินบิลบ่อยกว่าราคา input ถ้าคุณต้องการคำอธิบายที่ยาวกว่า input vs output tokens อธิบายไว้แล้ว
OpenAI ยังระบุอัตรา cached-input: $0.005 ต่อ 1M สำหรับ gpt-5-nano (วิธีการทำงานอยู่ในwhat is prompt caching) สมมติว่า input 500 tokens ทั้งหมดของคุณเป็น prompt ที่ซ้ำและถูก cache Input ลดลงเหลือ 0.5M × $0.005 = $0.0025 และงานมีค่าใช้จ่าย $0.0025 + $0.08 = $0.0825 บิลแทบไม่ขยับ เพราะ 200 output tokens ยังคงมีค่าใช้จ่าย $0.08
ลองคำนวณแบบเดียวกันในระดับที่ใหญ่ขึ้น:
ทายตัวเลข
ตัวติดแท็กส่ง 200,000 คำขอต่อวันไปยัง gpt-5-nano แต่ละคำขอมี 500 tokens เข้าและ 200 ออก นั่นคือกี่ดอลลาร์ต่อวัน?
คำตอบของคุณ
0100
แสดงคำตอบ
คำตอบ: 21
$21. Input: 100M tokens × $0.05 = $5. Output: 40M tokens × $0.40 = $16. รวม $5 + $16 = $21.
งานเดียวกันบนโมเดล open-weight#
ตอนนี้ 1,000 คำขอเดียวกันที่มี 500 เข้าและ 200 ออก คิดราคาบน CheapTokens ตามอัตราปัจจุบัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 โทเค็นอินพุตและ 200 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ในตัวเลข: GLM-5.3-Flash ใช้ $0.018, DeepSeek-V4-Flash $0.0275 และ MiniMax-M2.7 $0.055 วางเทียบกับ $0.105 สำหรับ gpt-5-nano ตารางเป็นแบบสด ดังนั้นจึงตามรายการราคาปัจจุบัน GLM-5.3-Flash มี context 390K และตอบได้สูงสุด 8,192 tokens ซึ่งเพียงพอสำหรับแท็กหรือคำตอบสั้น DeepSeek-V4-Flash มี context 380K และตอบได้สูงสุด 32,768 tokens ซึ่งสำคัญเมื่อ output เป็นรายงานหรือโค้ดยาว ทั้งสองมีราคาเดียวทุกชั่วโมง ไม่มีราคาช่วงพีค
อีกสถานการณ์หนึ่ง แชทบอทที่ยังใช้ gpt-4o-mini สมมติว่าแต่ละแชทส่งประมาณ 1,200 tokens (ประวัติบวกคำถามใหม่) ได้กลับมา 250 และคุณให้บริการ 3,000 แชทต่อวัน บน gpt-4o-mini นั่นคือ 3.6M input tokens × $0.15 = $0.54 และ 0.75M output tokens × $0.60 = $0.45 รวม $0.99 ต่อวัน บน gpt-5-nano วันเดียวกันคือ 3.6M × $0.05 = $0.18 บวก 0.75M × $0.40 = $0.30 รวม $0.48 นี่คือทราฟฟิกเดียวกันบน CheapTokens; เปลี่ยนตัวเลขให้ตรงกับบอทของคุณ:
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวันของแชทบอท: 3,000 แชท
โทเค็นอินพุตต่อคำขอ: 1,200 · โทเค็นเอาต์พุตต่อคำขอ: 250 · คำขอต่อวัน: 3,000
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
การสลับใช้เวลาแค่สามการเปลี่ยนแปลงเล็กๆ#
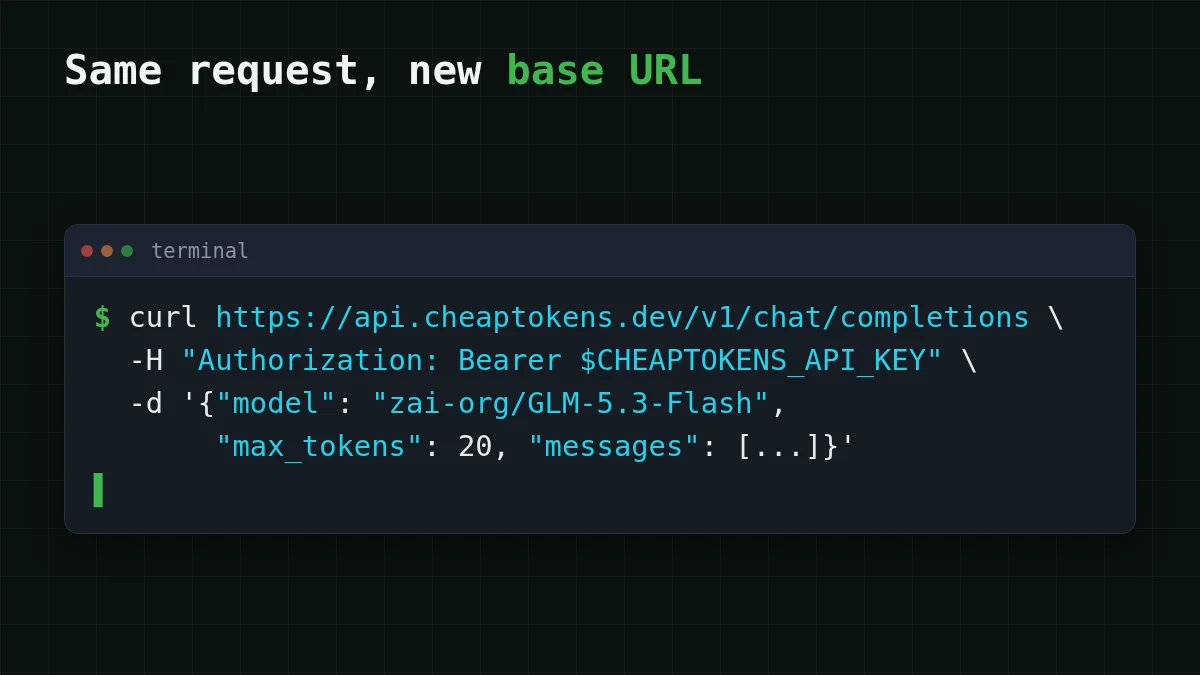
CheapTokens พูดภาษา OpenAI API ดังนั้นโค้ดที่คุณมียังทำงานได้ คุณเปลี่ยน base URL, key และ model id เอา id จากเอกสาร เพราะผู้ให้บริการตั้งชื่อโมเดลต่างกัน สำหรับ GLM-5.3-Flash คือ zai- และ base URL คือ https:/
คำขอติดแท็กหนึ่งครั้ง สองวิธี
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
รันกับตั๋วจริง 50 ใบของคุณและอ่านคำตอบด้วยตัวเอง ฟิลด์ usage ในแต่ละ response ให้จำนวน input และ output tokens ที่แน่นอน และตัวเลขสองตัวนั้นคือทั้งหมดที่เครื่องคำนวณข้างต้นต้องการ key, ยอดคงเหลือ และการเรียกครั้งแรกอยู่ในคำขอ API ครั้งแรกของคุณ
ตัวไหนสำหรับงานไหน#
เลือกกรณีของคุณ
คุณกำลังรันอะไรอยู่?
เลือกตัวเลือกเพื่อดูคำตอบ
ติดแท็กหรือจำแนกข้อความสั้น
คำตอบสั้น ปริมาณมหาศาล บน OpenAI gpt-5-nano มีราคาต่ำที่สุด บน CheapTokens ลอง GLM-5.3-Flash: context 390K, output สูงสุด 8,192 tokens, ราคาเดียวทุกชั่วโมง
คำตอบยาว: รายงาน ร่าง โค้ด
ลอง DeepSeek-V4-Flash เขียนได้สูงสุด 32,768 tokens ในคำตอบเดียว และมี context 380K
ลูป agent หรือเครื่องมือเขียนโค้ด
ลอง MiniMax-M2.7 หรือ DeepSeek-V4-Flash ทั้งสองอยู่บนยอดคงเหลือเดียวกับโมเดลอื่น ดังนั้นคุณสลับระหว่างกันได้โดยไม่ต้องมีบัญชีใหม่
คุณต้องอยู่กับ OpenAI
ใช้ gpt-5-nano สำหรับราคาต่ำสุด หรือ gpt-6-luna ถ้าคุณต้องการโมเดลที่ถูกที่สุดในสาย GPT-6 ถ้าคุณใช้ gpt-4o-mini อยู่ gpt-5-nano ถูกกว่าทั้งสองด้าน
ไม่ว่าคุณจะเลือกตัวไหน ทดสอบกับตัวอย่างของคุณเองก่อนย้ายงานทั้งหมด ตารางราคาบอกคุณว่า token หนึ่งมีค่าใช้จ่ายเท่าไร มีเพียงข้อมูลของคุณที่บอกว่าคำตอบดีพอหรือไม่ ราคาปัจจุบันของทุกโมเดลอยู่ในหน้าค่าราคา และhow much AI tokens cost วางงบ 1M และ 10M tokens เทียบกัน


