การลดต้นทุนคู่มือ
ค่าใช้จ่ายการส่งต่อระหว่างหลายเอเจนต์: เชน 3 เอเจนต์ใช้โทเคนเท่าไร
ดูว่าทำไมเอเจนต์ทุกตัวในเชนจึงอ่านการส่งต่อก่อนหน้าทั้งหมดซ้ำ ค่าใช้จ่ายเป็นโทเคนเท่าไร และการเปลี่ยนแปลงสามอย่างที่ลดอินพุต
ในหน้านี้
เอเจนต์ทั้งสามของคุณทำงานเสร็จแล้ว และค่าใช้จ่ายก็มากกว่าที่งานดูเหมือนจะเป็น เหตุผลง่ายมาก: ด้วยการส่งต่อข้อความ เอเจนต์ทุกตัวต้องจ่ายเพื่ออ่านทุกอย่างที่เอเจนต์ก่อนหน้าเขียน แผนขนาด 1,500 โทเคนถูกจ่ายครั้งหนึ่งตอนที่ planner เขียน จากนั้นก็จ่ายอีกครั้งโดย coder แล้วก็อีกครั้งโดย reviewer ลดขนาดการส่งต่อ ให้แต่ละเอเจนต์ได้รับเฉพาะสิ่งที่จำเป็น แล้วอินพุตของเอเจนต์ถัดไปทุกตัวก็จะเล็กลง
ด้านล่าง: ตัวอย่าง 3 เอเจนต์พร้อมการคำนวณโทเคน ประมาณการค่าใช้จ่ายสำหรับ 100 งานต่อวันตามราคาจริง และการเปลี่ยนแปลงสามอย่างที่คุณทำได้วันนี้ API แบบ chat-completions ไม่มีสถานะ ดังนั้นทุกคำขอจึงพาบริบทเต็มมาด้วยทุกครั้ง (ทำไมแชทยาวจึงมีค่าใช้จ่ายสูงขึ้น และ อาร์เรย์ messages ทำงานอย่างไร อธิบายพื้นฐานไว้)
โทเคนสะสมอยู่ตรงไหน#
สมมติว่าคุณมี planner, coder และ reviewer งานบวกคำสั่งคือ 1,000 โทเคน planner เขียนแผน 1,500 โทเคน coder เขียนโค้ดและบันทึก 3,000 โทเคน reviewer เขียนคำตัดสิน 800 โทเคน ตัวเลขเหล่านี้เป็นตัวเลขกลม ๆ สำหรับตัวอย่าง ไม่ใช่การวัดจริง เปลี่ยนเป็นตัวเลขของคุณเองจากฟิลด์ usage (วิธีอ่าน)
ทายตัวเลข
reviewer อ่านอินพุตกี่โทเคน?
คำตอบของคุณ
08,000
แสดงคำตอบ
คำตอบ: 5,500
5,500: งาน (1,000), แผน (1,500) และโค้ด (3,000) มาถึงในคำขอของมันทั้งหมด
อินพุตของแต่ละเอเจนต์คืองานบวกทุกการส่งต่อที่มันได้รับ:
เลื่อนตารางไปทางขวา →
| เอเจนต์ | อ่าน (อินพุต) | เขียน (เอาต์พุต) |
|---|---|---|
| Planner | 1,000 (งาน) | 1,500 |
| Coder | 1,000 + 1,500 = 2,500 | 3,000 |
| Reviewer | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| ทั้งเชน | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
เชนอ่าน 9,000 โทเคนเพื่อสร้าง 5,300 เพิ่มเอเจนต์ตัวที่สี่และมันจะอ่านงานบวกการส่งต่อทั้งสาม ดังนั้นอินพุตจึงโตขึ้นทุก hop ไม่ใช่แค่เพิ่มขึ้นหนึ่งการส่งต่อ
100 งานต่อวันมีค่าใช้จ่ายเท่าไร#
โทเคนการส่งต่อถูกคิดเงินครั้งหนึ่งเป็นเอาต์พุตตอนที่เอเจนต์เขียนมัน แล้วจึงเป็นอินพุตสำหรับเอเจนต์ถัดไปแต่ละตัวที่อ่านมัน โทเคนเอาต์พุตมีราคาสูงกว่าโทเคนอินพุต ดังนั้นในตัวอย่างนี้คำตอบจึงเป็นส่วนแบ่งที่ใหญ่กว่าของบิล แม้ว่าเชนจะอ่านมากกว่าที่เขียนก็ตาม (โทเคนอินพุตเทียบเอาต์พุต)
หนึ่งงานคือ 9,000 โทเคนเข้าและ 5,300 ออก บน MiniMax-M2.7 นั่นคือ $0.0012 ต่องาน สำหรับ 100 งานต่อวัน นี่คือราคาจริงของโมเดลต่าง ๆ ของเรา เทียบกับ OpenRouter:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 100 คำขอ | OpenRouter, 100 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9,000 โทเค็นอินพุตและ 5,300 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน โมเดล CheapTokens ข้างต้นถูกกว่า OpenRouter สำหรับเชนนี้
ต้องการคำนวณสำหรับเชนของคุณเอง? ใส่คำขอเฉลี่ยของเอเจนต์หนึ่งตัวลงในเครื่องคำนวณ: ประมาณ 3,000 โทเคนเข้าและ 1,800 ออก ทำซ้ำ 300 ครั้ง คือ 100 งานของสามเอเจนต์
เครื่องคำนวณค่าใช้จ่าย
100 งานต่อวัน เอเจนต์ละสามตัว
โทเค็นอินพุตต่อคำขอ: 3,000 · โทเค็นเอาต์พุตต่อคำขอ: 1,800 · คำขอต่อวัน: 300
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
สามวิธีลดบิล#
1. ทำให้การส่งต่อเป็นบันทึกสั้น ๆ แบบมีโครงสร้าง#
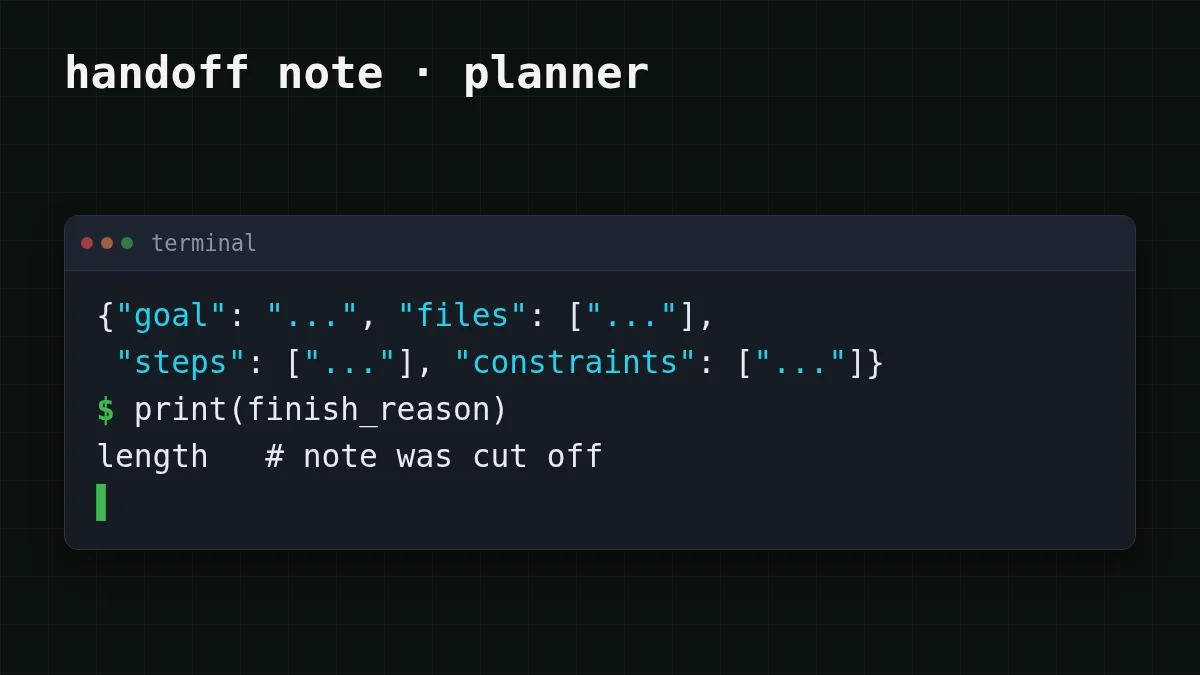
planner ไม่จำเป็นต้องเขียนเรียงความให้ coder ขอเป็นฟิลด์: เป้าหมาย ไฟล์ ขั้นตอน ข้อจำกัด สมมติว่าบันทึกสั้น ๆ แปดขั้นตอนบรรทัดละขั้นใช้ประมาณ 400 โทเคนแทนที่จะเป็น 1,500 (เป็นสมมติฐาน: ใส่ตัวเลขของคุณเองจาก usage) และเอเจนต์ถัดไปทุกตัวอ่านบันทึกที่เล็กลงนั้น จำกัดคำตอบด้วย max_tokens ตั้งไว้สูงกว่าบันทึกที่คาดไว้เล็กน้อย เพื่อให้โมเดลที่พูดมากไม่สามารถแอบใส่เรียงความกลับมาได้
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
ถ้า finish_reason เป็น length แสดงว่าบันทึกถูกตัดด้วยขีดจำกัด: เพิ่ม max_tokens ขึ้นเล็กน้อยหรือย่อสคีมาให้สั้นลง (ข้อผิดพลาดนั้นหน้าตาอย่างไร) model id และ base URL อยู่ใน เอกสาร CheapTokens
2. ส่งให้แต่ละเอเจนต์เฉพาะสิ่งที่จำเป็น#
ถ้า reviewer ตรวจโค้ดเทียบกับงาน มันไม่จำเป็นต้องใช้แผน: งานและโค้ดก็เพียงพอ ถ้ามันตรวจโค้ดเทียบกับแผนด้วย ก็เก็บแผนไว้ การตัดแผนออกจากบริบทของมันเป็นการเปลี่ยนแปลงบรรทัดเดียวใน orchestrator ของคุณ:
เปรียบเทียบ
สิ่งที่ reviewer อ่าน
ก่อน: ทุกอย่าง
งาน 1,000 + แผน 1,500 + โค้ด 3,000 = 5,500 โทเคนเข้า
หลัง: งานและโค้ด
งาน 1,000 + โค้ด 3,000 = 4,000 โทเคนเข้า
ด้วยการเปลี่ยนแปลงทั้งสอง (และบันทึก 400 โทเคน ซึ่งเป็นสมมติฐานของเรา) เชนตัวอย่างจะกลายเป็น planner 1,000 เข้าและ 400 ออก, coder 1,000 + 400 = 1,400 เข้าและ 3,000 ออก, reviewer 1,000 + 3,000 = 4,000 เข้าและ 800 ออก นั่นคือ 1,000 + 1,400 + 4,000 = 6,400 โทเคนเข้าและ 400 + 3,000 + 800 = 4,200 ออก เทียบกับ 9,000 และ 5,300 ก่อนหน้า 100 งานต่อวันเท่าเดิม:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 100 คำขอ | OpenRouter, 100 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6,400 โทเค็นอินพุตและ 4,200 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
สำหรับหนึ่งงานบน MiniMax-M2.7 เชนที่ลดขนาดแล้วคือ $0.00095 ลดลงจาก $0.0012
3. ให้บทบาทสั้น ๆ ใช้โมเดลราคาถูก#
planner เขียนคำตอบสั้น ดังนั้นเริ่มตรงนั้น: ลอง GLM-5.3-Flash (บริบท 390K เอาต์พุตสูงสุด 8,192 โทเคนต่อคำตอบ) และเปรียบเทียบผลลัพธ์บนงานของคุณเอง 10–20 งาน coder เขียนคำตอบยาวที่สุด: DeepSeek-V4-Flash รองรับเอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ เนื่องจากทุกโมเดลอยู่บนยอดเงินเดียวด้วยราคาเดียวในทุกชั่วโมง การผสมกันในเชนเดียวจึงต้องการเพียงสตริง model ที่ต่างกันต่อเอเจนต์ ราคาปัจจุบันของทั้งสองอยู่ในตารางราคา และบนหน้า DeepSeek
ทำไมไม่ส่ง KV cache ไปเลยล่ะ?#
บทความ SwaT (arXiv:2610.15095) ที่ส่งเมื่อวันที่ 10 ตุลาคม 2026 โดย Alabdulkareem, Tenison, Zhang, Zhu, Katz และ Gutfreund เสนอสิ่งนั้นพอดี: เอเจนต์ส่งสถานะ KV-cache ให้กันแทนข้อความ ผู้รับจึงข้ามการอ่านข้อความซ้ำ ตามหน้า abstract (อ่านเมื่อวันที่ 31 ตุลาคม 2026) ผู้เขียนรายงานความแม่นยำเฉลี่ยสูงขึ้น 40% (ด้วยการบีบอัด KV-cache) เทียบกับการสื่อสารแบบข้อความเป็นข้อความ และเวลา wall-clock เฉลี่ยเร็วขึ้น 4 เท่า ครอบคลุม 17 benchmark, 12 LLM และ 6 ตระกูลโมเดล ตัวเลข 40% คือความแม่นยำ ไม่ใช่การประหยัดโทเคนหรือราคา
วิธีการวิจัยแบบนี้ต้องเข้าถึงแคชภายในของโมเดล คำขอแบบ chat-completions รับข้อความเข้าและให้ข้อความออก ดังนั้นกับ API คันโยกของคุณคือข้อความ: การเปลี่ยนแปลงสามอย่างข้างต้น
ก่อนที่คุณจะขยายไปหลายร้อยรอบ#
เช็กลิสต์
รายการตรวจสอบการส่งต่อ
สำหรับภาพรวมที่ใหญ่ขึ้นของงบประมาณเอเจนต์ ดูวิธีประมาณค่าใช้จ่ายของ AI agent และทำไมเอเจนต์จึงใช้โทเคนมาก


