Optimasi biayaPanduan
Biaya serah-terima multi-agen: berapa token yang digunakan rantai 3 agen
Lihat mengapa setiap agen dalam rantai membaca ulang semua serah-terima sebelumnya, berapa biayanya dalam token, dan tiga perubahan yang memperkecil input.
Di halaman ini
- Di mana token menumpuk
- Berapa biaya 100 tugas sehari
- Tiga cara memperkecil tagihan
- 1. Jadikan serah-terima catatan terstruktur yang singkat
- 2. Berikan setiap agen hanya yang dibutuhkannya
- 3. Beri model murah untuk peran singkat
- Mengapa tidak langsung meneruskan KV cache?
- Sebelum Anda menskalakan ke ratusan eksekusi
Tiga agen Anda menyelesaikan pekerjaan, dan tagihannya lebih besar dari yang terlihat. Alasannya sederhana: dengan serah-terima teks, setiap agen membayar untuk membaca semua yang ditulis agen sebelumnya. Rencana 1.500 token dibayar sekali saat perencana menulisnya, lalu lagi oleh pengode, lalu lagi oleh peninjau. Pangkas serah-terima, berikan setiap agen hanya yang dibutuhkannya, dan input setiap agen berikutnya menjadi lebih kecil.
Di bawah: contoh 3 agen yang dikerjakan dengan perhitungan tokennya, perkiraan biaya untuk 100 tugas sehari pada harga live, dan tiga perubahan yang bisa Anda lakukan hari ini. API chat-completions bersifat stateless, jadi setiap permintaan membawa konteks lengkapnya lagi (mengapa obrolan panjang lebih mahal dan cara kerja array messages mencakup dasar-dasarnya).
Di mana token menumpuk#
Katakan Anda menjalankan perencana, pengode, dan peninjau. Tugas plus instruksi adalah 1.000 token. Perencana menulis rencana 1.500 token, pengode menulis 3.000 token kode dan catatan, peninjau menulis putusan 800 token. Ini angka bulat untuk contoh, bukan pengukuran; ganti dengan milik Anda dari field usage (cara membacanya).
Tebak angkanya
Berapa banyak token yang dibaca peninjau sebagai input?
Tebakan Anda
08.000
Tampilkan jawaban
Jawaban: 5.500
5.500: tugas (1.000), rencana (1.500) dan kode (3.000) semuanya tiba dalam permintaannya.
Input setiap agen adalah tugas plus setiap serah-terima yang diterimanya:
Gulir tabel ke kanan →
| Agen | Membaca (input) | Menulis (output) |
|---|---|---|
| Perencana | 1.000 (tugas) | 1.500 |
| Pengode | 1.000 + 1.500 = 2.500 | 3.000 |
| Peninjau | 1.000 + 1.500 + 3.000 = 5.500 | 800 |
| Seluruh rantai | 1.000 + 2.500 + 5.500 = 9.000 | 1.500 + 3.000 + 800 = 5.300 |
Rantai membaca 9.000 token untuk menghasilkan 5.300. Tambahkan agen keempat dan ia akan membaca tugas plus ketiga serah-terima, jadi input tumbuh dengan setiap lompatan, bukan hanya dengan satu serah-terima.
Berapa biaya 100 tugas sehari#
Token serah-terima ditagih sekali sebagai output, saat agen menulisnya, lalu sebagai input untuk setiap agen berikutnya yang membacanya. Token output dihargai lebih tinggi daripada token input, jadi dalam contoh ini jawaban adalah porsi tagihan yang lebih besar meskipun rantai membaca lebih banyak daripada menulis (token input vs output).
Satu tugas adalah 9.000 token masuk dan 5.300 keluar. Pada MiniMax-M2.7 itu $0.0012 per tugas. Untuk 100 tugas sehari, ini adalah harga live di seluruh model kami, di samping OpenRouter:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 100 permintaan | OpenRouter, 100 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9.000 token input dan 5.300 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Secara total, dengan input dan output dihitung bersama, model CheapTokens di atas lebih murah daripada OpenRouter untuk rantai ini.
Ingin perhitungan untuk rantai Anda sendiri? Masukkan rata-rata permintaan satu agen ke kalkulator: sekitar 3.000 token masuk dan 1.800 keluar, diulang 300 kali, adalah 100 tugas dari tiga agen.
Kalkulator biaya
100 tugas sehari, masing-masing tiga agen
Token input per permintaan: 3.000 · Token output per permintaan: 1.800 · Permintaan per hari: 300
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Tiga cara memperkecil tagihan#
1. Jadikan serah-terima catatan terstruktur yang singkat#
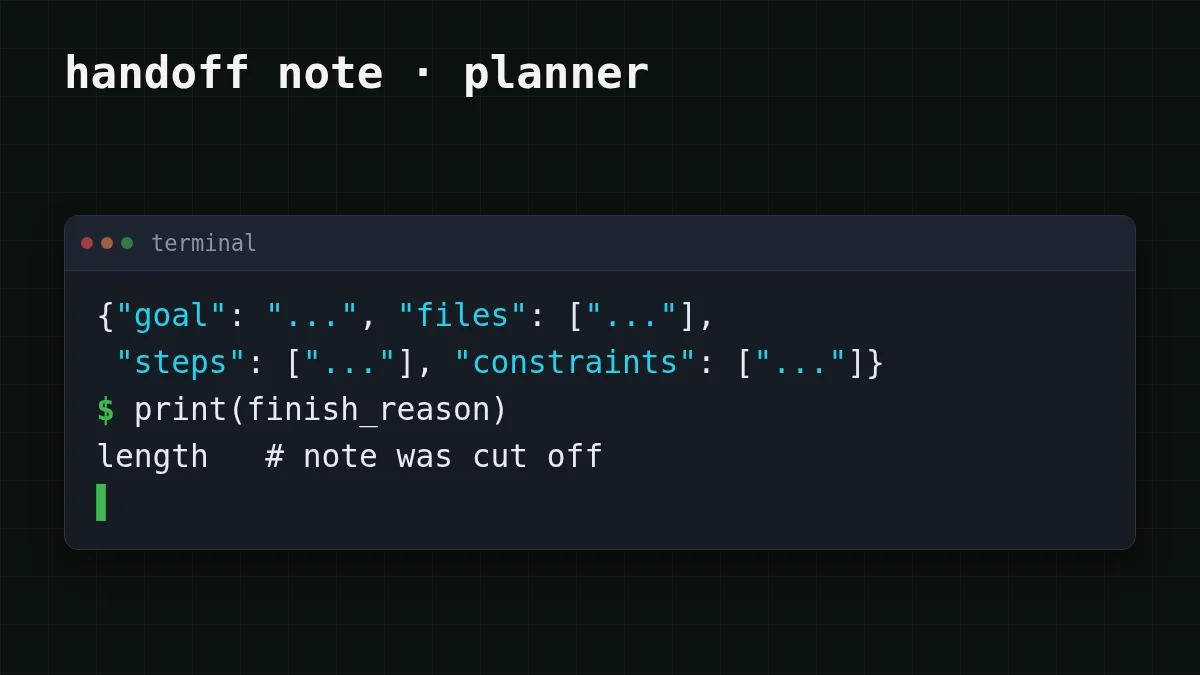
Perencana tidak perlu menulis esai untuk pengode. Minta field: tujuan, file, langkah, batasan. Katakan catatan singkat berisi delapan langkah satu baris memakan sekitar 400 token alih-alih 1.500 (sebuah asumsi: masukkan angka Anda sendiri dari usage), dan setiap agen berikutnya membaca catatan yang lebih kecil itu. Batasi jawaban dengan max_tokens, atur sedikit di atas catatan yang diharapkan, agar model yang cerewet tidak bisa menyelipkan esai itu kembali.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Jika finish_reason adalah length, catatan terpotong oleh batas: naikkan max_tokens sedikit atau perpendek skema (seperti apa error itu). Id model dan base URL ada di dokumentasi CheapTokens.
2. Berikan setiap agen hanya yang dibutuhkannya#
Jika peninjau memeriksa kode terhadap tugas, ia tidak perlu rencana: tugas dan kode sudah cukup. Jika ia juga memeriksa kode terhadap rencana, pertahankan rencana. Menghapus rencana dari konteksnya adalah perubahan satu baris di orkestrator Anda:
Bandingkan
Apa yang dibaca peninjau
Sebelum: semuanya
Tugas 1.000 + rencana 1.500 + kode 3.000 = 5.500 token masuk.
Sesudah: tugas dan kode
Tugas 1.000 + kode 3.000 = 4.000 token masuk.
Dengan kedua perubahan (dan catatan 400 token, yang merupakan asumsi kami), rantai contoh menjadi perencana 1.000 masuk dan 400 keluar, pengode 1.000 + 400 = 1.400 masuk dan 3.000 keluar, peninjau 1.000 + 3.000 = 4.000 masuk dan 800 keluar. Itu 1.000 + 1.400 + 4.000 = 6.400 token masuk dan 400 + 3.000 + 800 = 4.200 keluar, dibandingkan 9.000 dan 5.300 sebelumnya. Sama 100 tugas sehari:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 100 permintaan | OpenRouter, 100 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6.400 token input dan 4.200 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Untuk satu tugas pada MiniMax-M2.7 rantai yang dipangkas adalah $0.00095, turun dari $0.0012.
3. Beri model murah untuk peran singkat#
Perencana menulis jawaban singkat, jadi mulailah dari sana: coba GLM-5.3-Flash (konteks 390K, hingga 8.192 token output per jawaban) dan bandingkan hasilnya pada 10–20 tugas Anda sendiri. Pengode menulis jawaban terpanjang: DeepSeek-V4-Flash memungkinkan hingga 32.768 token output per jawaban. Karena setiap model berada pada satu saldo dengan satu harga pada jam berapa pun, mencampurnya dalam satu rantai hanya memerlukan string model yang berbeda per agen. Harga terkini untuk keduanya ada di tabel harga dan di halaman DeepSeek.
Mengapa tidak langsung meneruskan KV cache?#
Makalah SwaT (arXiv:2610.15095), yang dikirim pada 10 Oktober 2026 oleh Alabdulkareem, Tenison, Zhang, Zhu, Katz dan Gutfreund, mengusulkan tepat itu: agen saling menyerahkan state KV-cache alih-alih teks, sehingga penerima melewati pembacaan teks lagi. Menurut halaman abstrak (dibaca pada 31 Oktober 2026), penulis melaporkan akurasi rata-rata 40% lebih tinggi (dengan pemadatan KV-cache) daripada komunikasi teks-ke-teks dan waktu dinding rata-rata 4x lebih cepat di 17 benchmark, 12 LLM dan 6 keluarga model. Angka 40% itu adalah akurasi, bukan penghematan token atau harga.
Metode penelitian seperti ini membutuhkan akses ke cache internal model. Permintaan chat-completions menerima teks masuk dan memberikan teks keluar, jadi dengan API tuas Anda adalah teks: tiga perubahan di atas.
Sebelum Anda menskalakan ke ratusan eksekusi#
Daftar periksa
Daftar periksa serah-terima
Untuk gambaran lebih besar tentang anggaran agen, lihat cara memperkirakan biaya agen AI dan mengapa agen menggunakan begitu banyak token.


