Berita AIPembaruan
Mistral Large 4 open weights: harga API dan biaya per tugas agen
Mistral Large 4 kini open-weight, dengan harga API dari Mistral. Lihat berapa biaya satu tugas agen coding dan kapan model yang lebih murah cocok.
Di halaman ini
Mistral Large 4 kini open-weight: Mistral menerbitkan bobotnya pada 29 Oktober 2026 dan menetapkan harga API sebesar $0.70 per 1 juta token input dan $2.10 per 1 juta token output ($0.07 untuk input yang di-cache). Jika Anda menjalankan agen coding, pertanyaan yang berguna bukanlah harga per token, melainkan berapa total biaya satu tugas panjang.
Apa yang diumumkan Mistral#
Menurut halaman rilis Mistral (diperiksa 30 Oktober 2026), Mistral Large 4 adalah model dengan sekitar 1T parameter, hibrida instruct dan reasoning yang dibangun sebagai mixture of experts. Model ini multimodal secara native pada input, mencakup 160+ bahasa dan memiliki tiga mode reasoning, Low, Medium dan High, dengan High sebagai default. Repositori Hugging Face adalah Mistral-; id API-nya adalah mistral-.
Bobotnya dirilis di bawah lisensi Mistral Ecosystem Open-Weight, versi modifikasi dari MIT. Penggunaan komersial dan fine-tuning diizinkan. Menjual model sebagai layanan hosted memerlukan lisensi komersial terpisah dari Mistral. Anda dapat menjalankannya dengan vLLM atau SGLang, melalui NVIDIA NIM atau TensorRT-LLM, atau menggunakan API Mistral sendiri, Microsoft Foundry dan Mistral Vibe Code.
Pada benchmark, Mistral melaporkan angkanya sendiri: 41% pada Terminal-Bench 4.0 (versi preview mencetak 28%), 19.7% pada FrontierCode 2.0, 84.5% pada BrowseComp, dan 48% pada Artificial Analysis Coding Agent Index, yang menurut Mistral setara dengan GLM-5.3 dengan 47% lebih sedikit token per tugas. Ini adalah hasil dari vendor, bukan hasil independen, jadi anggap ini sebagai alasan untuk menguji pada repo Anda sendiri, bukan sebagai putusan akhir.
Berapa biaya satu tugas agen dengan harga Mistral#
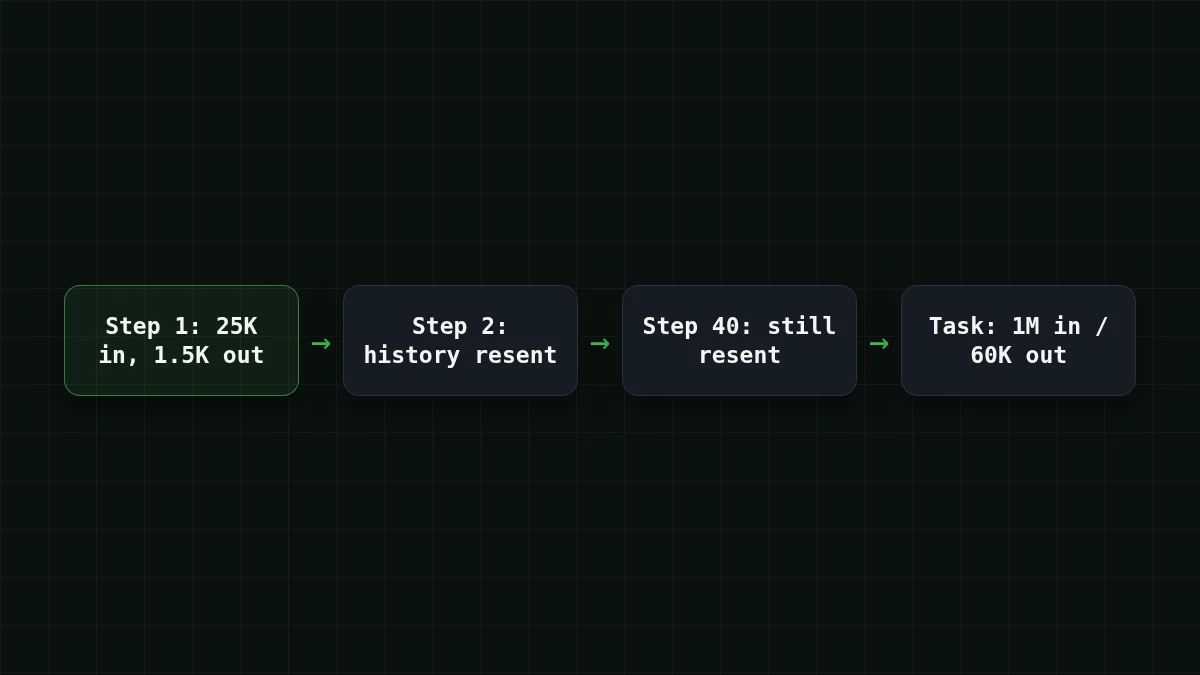
Mulailah dari bagaimana agen benar-benar menghabiskan token. Setiap langkah mengirim ulang percakapan sejauh itu, sehingga input menumpuk sementara setiap jawaban tetap singkat. Katakanlah sebuah agen coding terminal mengambil 40 langkah pada satu tugas, dengan sekitar 25.000 token input dan 1.500 token output per langkah. Itu adalah asumsi untuk ilustrasi; gantilah dengan angka Anda sendiri.
Tebak angkanya
40 langkah dengan sekitar 25.000 token input masing-masing: berapa ribu token input yang dikirim tugas ini secara total?
Tebakan Anda
02.000
Tampilkan jawaban
Jawaban: 1.000
25.000 × 40 = 1.000.000 token input, jadi 1.000 ribu. Agen mengirim ulang konteksnya pada setiap langkah, itulah sebabnya volume input mendominasi tagihan agen.
Dengan harga yang diterbitkan Mistral (30 Oktober 2026), tugas tersebut adalah 1.000.000 × $0.70 / 1M = $0.70 untuk input dan 60.000 × $2.10 / 1M = $0.126 untuk output, jadi $0.70 + $0.126 = $0.826 per tugas. Sisi input adalah sebagian besar tagihan.
Caching mengubah gambaran. Jika 20.000 dari 25.000 token input di setiap langkah dilayani dari cache dengan $0.07 per 1M, satu langkah berbiaya 20.000 × $0.07 / 1M = $0.0014 untuk input yang di-cache, 5.000 × $0.70 / 1M = $0.0035 untuk input baru dan 1.500 × $2.10 / 1M = $0.00315 untuk output. Itu berarti $0.00805 per langkah, dan $0.00805 × 40 = $0.322 per tugas. Tingkat cache hit 80% adalah asumsi lain, jadi periksa apa yang dilaporkan alat Anda.
Berikut beban kerja yang sama pada kalkulator yang dapat Anda ubah:
Kalkulator biaya
Satu tugas agen coding: 40 langkah
Token input per permintaan: 25.000 · Token output per permintaan: 1.500 · Permintaan per hari: 40
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
Dan tugas yang sama dengan harga di seluruh model CheapTokens, secara langsung, di samping OpenRouter:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 40 permintaan | OpenRouter, 40 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25.000 token input dan 1.500 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Untuk loop agen ini, DeepSeek-V4-Flash di CheapTokens menjadi $0.021 untuk keseluruhan tugas, secara total dengan input dan output dihitung bersama, dan lebih murah daripada harga referensi OpenRouter secara total. Model ini memiliki jendela konteks 380K dan hingga 32.768 token output per jawaban, dengan satu harga pada jam berapa pun sepanjang hari.
Open weights atau API#
Bobot adalah bagian menarik dari rilis ini. Jika data Anda tidak dapat keluar dari jaringan Anda, atau Anda ingin melakukan fine-tuning, kini Anda dapat melakukannya dengan model kelas ini. Biaya dari jalur tersebut adalah perangkat keras. Model dengan 1T parameter membutuhkan server multi-GPU bahkan jika hanya sebagian darinya yang aktif per token, dan halaman Mistral tidak menyebutkan jumlah parameter aktif (A52B pada nama repositori mengisyaratkan 52B, tetapi itu adalah inferensi dari nama). Halaman Mistral juga tidak menyebutkan ukuran konteks.
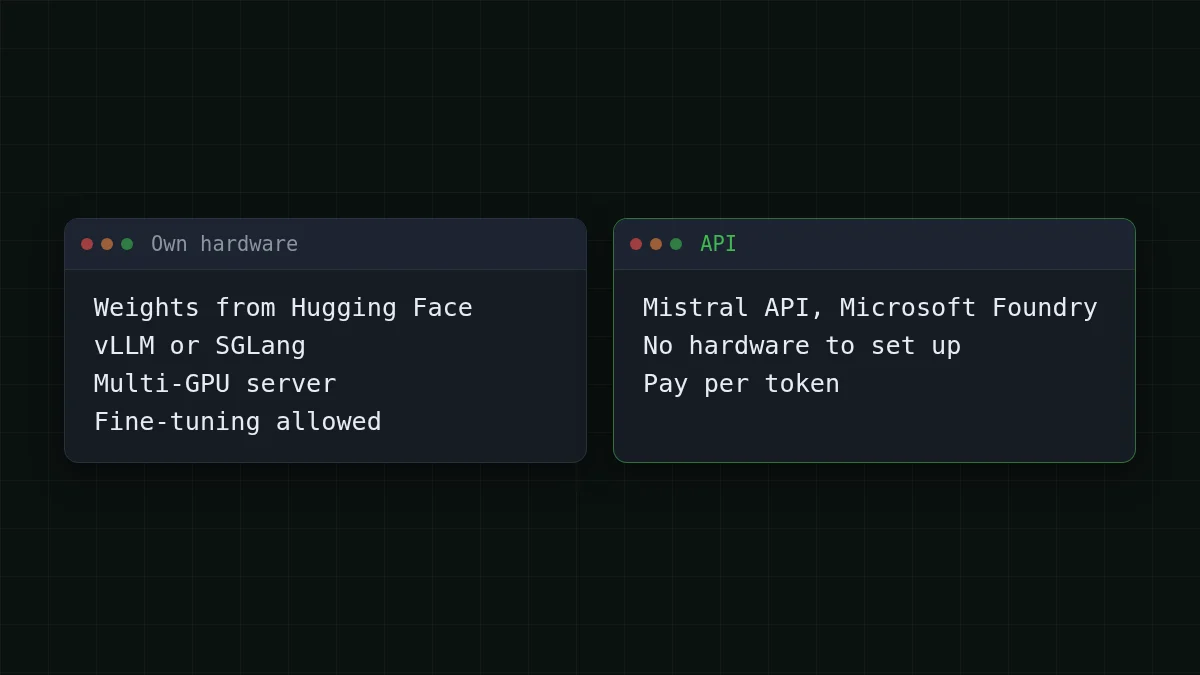
Bagi sebagian besar tim yang hanya ingin agen menyelesaikan tiket, jalur API menghindari penyiapan tersebut. Jika Anda ingin latar belakang tentang apa arti open weights dalam praktik, lihat apa itu open weights dan kuantisasi.
Tugas yang sama pada model agen yang dapat Anda panggil hari ini#
Jika tujuan Anda adalah agen terminal atau IDE yang menjalankan banyak langkah dengan murah, Anda dapat mencoba loop yang sama pada DeepSeek-V4-Flash atau GLM-5.3-Flash melalui CheapTokens. API-nya kompatibel dengan OpenAI Chat Completions dan Anthropic Messages, dengan satu saldo untuk semua model. Gunakan id model lengkap dari dokumentasi CheapTokens; nama model berbeda antar penyedia.
Satu permintaan, dua klien
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Bidang usage dalam respons menunjukkan token input dan output, sehingga Anda dapat mengukur langkah agen Anda sendiri dan memasukkannya ke kalkulator di atas. Panduan biaya Cline kami menunjukkan cara menganggarkan seluruh sesi, dan dokumentasi mencakup cara menghubungkan alat lain. Halaman model: DeepSeek murah, dan harga langsung.
Mana untuk pekerjaan mana#
Open weights pada perangkat keras Anda sendiri, dan fine-tuning, adalah jalur terpisah, dan itulah yang dibuka oleh rilis ini. Untuk loop panjang dengan langkah-langkah singkat, gunakan DeepSeek-V4-Flash di CheapTokens: konteks 380K, hingga 32.768 token output per jawaban, satu harga pada jam berapa pun sepanjang hari, dan lebih murah daripada OpenRouter secara total, dengan input dan output dihitung bersama. GLM-5.3-Flash memiliki konteks 390K. Benchmark Mistral membandingkan dengan GLM-5.3, dan tidak menyebutkan varian GLM-5.3 mana, jadi jangan membaca angkanya ke GLM-5.3-Flash. Jalankan sepuluh tugas Anda sendiri pada masing-masing dan bandingkan jumlah tokennya; pendekatan yang sama ada di bagaimana harga GPT-6.1 Terra dihitung per tugas.


