AI خبریںاپ ڈیٹ
Mistral Large 4 open weights: API قیمت اور فی agent ٹاسک لاگت
Mistral Large 4 اب open-weight ہے، Mistral کی API pricing کے ساتھ۔ دیکھیں کہ ایک coding-agent ٹاسک کتنا خرچ کرتا ہے اور کب سستا ماڈل موزوں ہے۔
اس صفحہ پر
Mistral Large 4 اب open-weight ہے: Mistral نے 29 اکتوبر 2026 کو weights شائع کیے اور API قیمت $0.70 فی 1M input tokens اور $2.10 فی 1M output tokens ($0.07 cached input کے لیے) مقرر کی۔ اگر آپ coding agents چلاتے ہیں تو مفید سوال فی token قیمت نہیں بلکہ یہ ہے کہ ایک طویل ٹاسک مجموعی طور پر کتنا خرچ کرتا ہے۔
Mistral نے کیا اعلان کیا#
Mistral کے release page کے مطابق (30 اکتوبر 2026 کو چیک کیا گیا)، Mistral Large 4 تقریباً 1T parameters کا ماڈل ہے، جو instruct اور reasoning کا hybrid ہے اور mixture of experts کے طور پر بنایا گیا ہے۔ یہ input پر natively multimodal ہے، 160+ زبانیں کور کرتا ہے اور اس میں تین reasoning modes ہیں، Low، Medium اور High، جن میں High default ہے۔ Hugging Face repository Mistral- ہے؛ API id mistral- ہے۔
Weights Mistral Ecosystem Open-Weight license کے تحت آتی ہیں، جو ایک modified MIT ہے۔ Commercial use اور fine-tuning کی اجازت ہے۔ ماڈل کو hosted service کے طور پر بیچنے کے لیے Mistral سے الگ commercial license درکار ہے۔ آپ اسے vLLM یا SGLang کے ساتھ، NVIDIA NIM یا TensorRT-LLM کے ذریعے چلا سکتے ہیں، یا Mistral کی اپنی API، Microsoft Foundry اور Mistral Vibe Code استعمال کر سکتے ہیں۔
Benchmarks پر Mistral اپنے اعداد و شمار بتاتا ہے: Terminal-Bench 4.0 پر 41% (preview نے 28% اسکور کیا)، FrontierCode 2.0 پر 19.7%، BrowseComp پر 84.5%، اور Artificial Analysis Coding Agent Index پر 48%، جس کے بارے میں Mistral کہتا ہے کہ یہ GLM-5.3 کے برابر ہے، فی ٹاسک 47% کم tokens کے ساتھ۔ یہ vendor کے نتائج ہیں، آزاد نتائج نہیں، اس لیے انہیں فیصلے کے بجائے اپنے repo پر ٹیسٹ کرنے کی وجہ سمجھیں۔
Mistral کی قیمت پر ایک agent ٹاسک کتنا خرچ کرتا ہے#
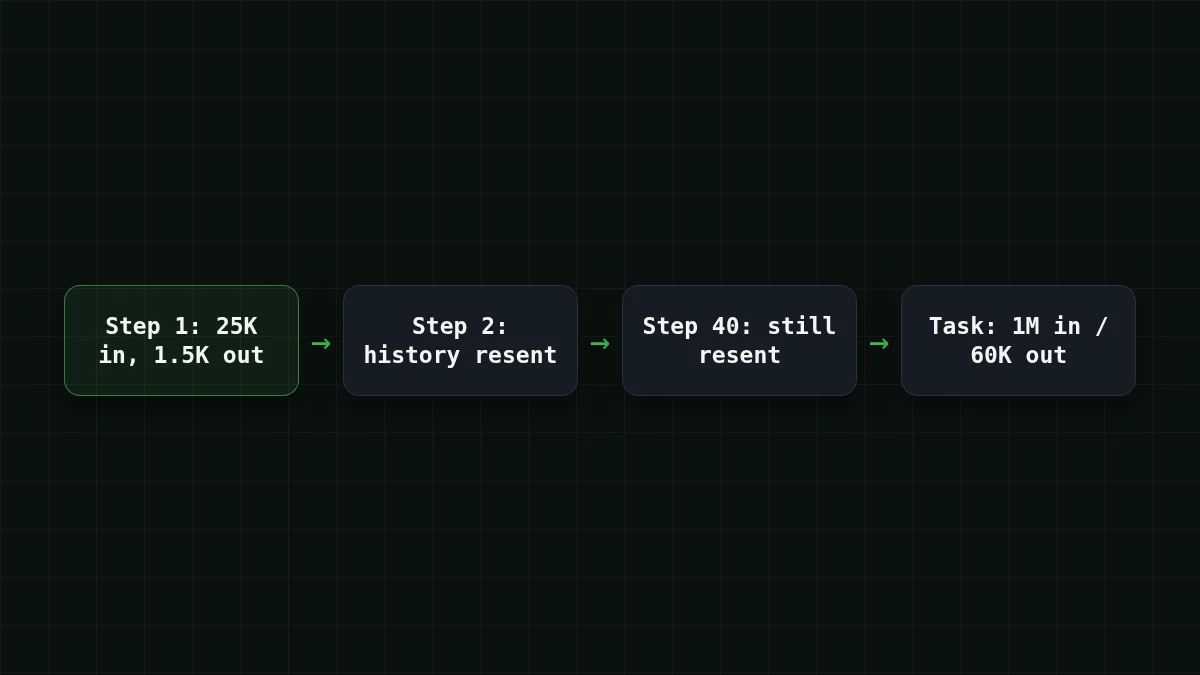
اس بات سے شروع کریں کہ agent واقعی tokens کیسے خرچ کرتا ہے۔ ہر step اب تک کی گفتگو دوبارہ بھیجتا ہے، اس لیے input جمع ہوتا جاتا ہے جبکہ ہر جواب مختصر رہتا ہے۔ فرض کریں کہ ایک terminal coding agent ایک ٹاسک پر 40 steps لیتا ہے، فی step تقریباً 25,000 input tokens اور 1,500 output tokens کے ساتھ۔ یہ مثال کے لیے ایک مفروضہ ہے؛ اپنے اعداد و شمار ڈالیں۔
نمبر کا اندازہ لگائیں
40 steps، ہر ایک پر تقریباً 25,000 input tokens: ٹاسک کل کتنے ہزار input tokens بھیجتا ہے؟
آپ کا اندازہ
02,000
جواب دکھائیں
جواب: 1,000
25,000 × 40 = 1,000,000 input tokens، یعنی 1,000 ہزار۔ agent ہر step پر اپنا context دوبارہ بھیجتا ہے، اسی لیے input volume agent بلز پر غالب رہتا ہے۔
Mistral کی شائع شدہ قیمت (30 اکتوبر 2026) پر وہ ٹاسک input کے لیے 1,000,000 × $0.70 / 1M = $0.70 اور output کے لیے 60,000 × $2.10 / 1M = $0.126 ہے، تو $0.70 + $0.126 = $0.826 فی ٹاسک۔ بل کا زیادہ تر حصہ input side ہے۔
Caching تصویر بدل دیتی ہے۔ اگر ہر step میں 25,000 input tokens میں سے 20,000 cache سے $0.07 فی 1M پر دیے جائیں، تو ایک step کی لاگت cached input کے لیے 20,000 × $0.07 / 1M = $0.0014، fresh input کے لیے 5,000 × $0.70 / 1M = $0.0035 اور output کے لیے 1,500 × $2.10 / 1M = $0.00315 ہے۔ یہ $0.00805 فی step ہے، اور $0.00805 × 40 = $0.322 فی ٹاسک۔ 80% cache hit rate ایک اور مفروضہ ہے، اس لیے دیکھیں کہ آپ کا tool کیا رپورٹ کرتا ہے۔
یہاں وہی workload ایک calculator پر ہے جسے آپ حرکت دے سکتے ہیں:
لاگت کیلکولیٹر
ایک coding-agent ٹاسک: 40 steps
فی درخواست ان پٹ ٹوکنز: 25,000 · فی درخواست آؤٹ پٹ ٹوکنز: 1,500 · فی دن درخواستیں: 40
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
اور وہی ٹاسک CheapTokens ماڈلز پر قیمت کے ساتھ، live، OpenRouter کے ساتھ:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 40 درخواستیں | OpenRouter، 40 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
فی درخواست 25,000 ان پٹ اور 1,500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
اس agent loop کے لیے، CheapTokens پر DeepSeek-V4-Flash پورے ٹاسک کے لیے $0.021 پر آتا ہے، input اور output کو ملا کر کل میں، اور یہ کل میں OpenRouter کی reference price سے سستا ہے۔ اس کی 380K context window اور فی جواب زیادہ سے زیادہ 32,768 output tokens ہیں، دن کے کسی بھی وقت ایک ہی قیمت پر۔
Open weights یا API#
اس release کا دلچسپ حصہ weights ہیں۔ اگر آپ کا ڈیٹا آپ کے نیٹ ورک سے باہر نہیں جا سکتا، یا آپ fine-tune کرنا چاہتے ہیں، تو اب آپ یہ اس کلاس کے ماڈل کے ساتھ کر سکتے ہیں۔ اس راستے کی لاگت hardware ہے۔ 1T-parameter ماڈل کے لیے multi-GPU سرور درکار ہے چاہے فی token اس کا صرف ایک حصہ active ہو، اور Mistral کا صفحہ active parameter count نہیں بتاتا (repository کے نام میں A52B 52B کی طرف اشارہ کرتا ہے، لیکن یہ نام سے ایک اندازہ ہے)۔ Mistral کا صفحہ context size بھی نہیں بتاتا۔
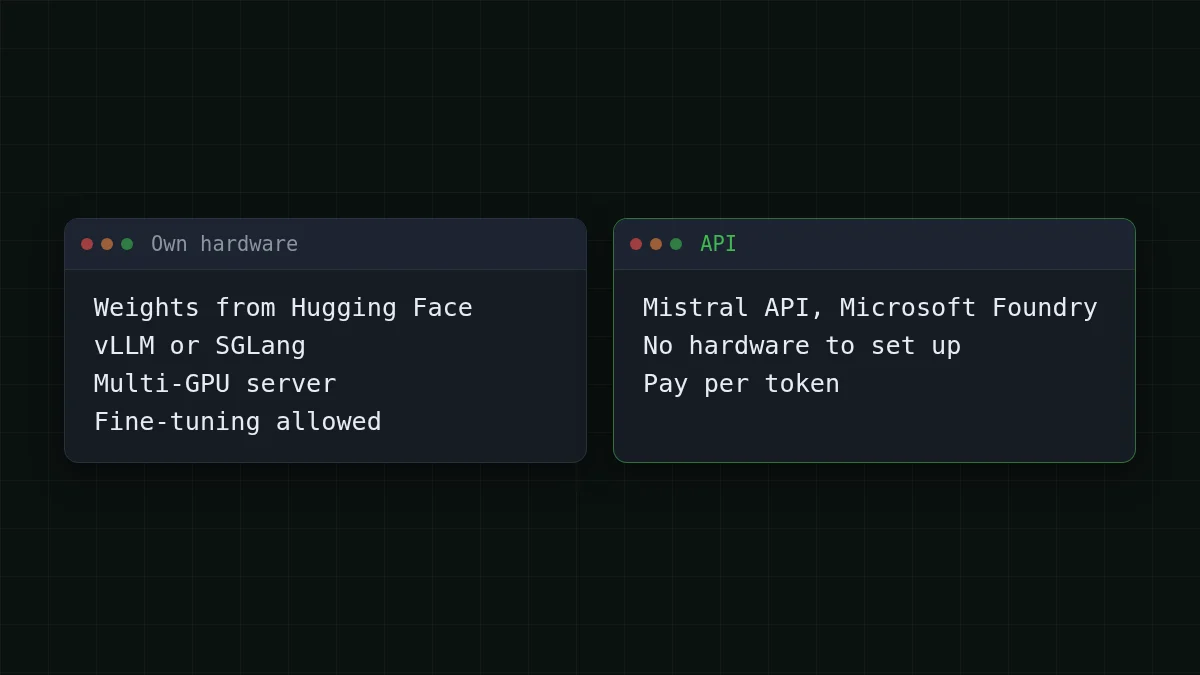
زیادہ تر ٹیموں کے لیے جو صرف چاہتی ہیں کہ ایک agent tickets مکمل کرے، API راستہ اس setup سے بچاتا ہے۔ اگر آپ جاننا چاہتے ہیں کہ open weights عملی طور پر کیا معنی رکھتے ہیں، تو open weights اور quantization کیا ہیں دیکھیں۔
وہی ٹاسک ایک agent ماڈل پر جو آپ آج کال کر سکتے ہیں#
اگر آپ کا مقصد ایک terminal یا IDE agent ہے جو بہت سے steps سستے طریقے سے چلائے، تو آپ CheapTokens کے ذریعے DeepSeek-V4-Flash یا GLM-5.3-Flash پر وہی loop آزما سکتے ہیں۔ API OpenAI Chat Completions اور Anthropic Messages کے ساتھ compatible ہے، تمام ماڈلز کے لیے ایک balance کے ساتھ۔ CheapTokens docs سے مکمل model id استعمال کریں؛ ماڈل کے نام providers کے درمیان مختلف ہوتے ہیں۔
ایک request، دو clients
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
response میں usage field input اور output tokens دکھاتا ہے، تاکہ آپ اپنے agent کا step ناپ کر اوپر والے calculator میں ڈال سکیں۔ ہماری Cline cost guide دکھاتی ہے کہ پورے session کا بجٹ کیسے بنایا جائے، اور docs دیگر tools جوڑنے کا احاطہ کرتی ہیں۔ Model pages: cheap DeepSeek، اور live pricing۔
کون سا کس کام کے لیے#
اپنے hardware پر open weights، اور fine-tuning، ایک الگ راستہ ہیں، اور یہی اس release نے کھولا ہے۔ مختصر steps کے طویل loop کے لیے، CheapTokens پر DeepSeek-V4-Flash استعمال کریں: 380K context، فی جواب زیادہ سے زیادہ 32,768 output tokens، دن کے کسی بھی وقت ایک قیمت، اور کل میں OpenRouter سے سستا، input اور output کو ملا کر۔ GLM-5.3-Flash کا 390K context ہے۔ Mistral کا benchmark GLM-5.3 کے خلاف موازنہ کرتا ہے، اور یہ نہیں بتاتا کہ کون سا GLM-5.3 variant، اس لیے اس کے اعداد و شمار GLM-5.3-Flash پر نہ پڑھیں۔ اپنے دس ٹاسک ہر ایک پر چلائیں اور token counts کا موازنہ کریں؛ یہی طریقہ GPT-6.1 Terra کی قیمت فی ٹاسک کیسے بنتی ہے میں ہے۔


