Nowości AIAktualizacja
Otwarte wagi Mistral Large 4: cena API i koszt na task agenta
Mistral Large 4 jest teraz open-weight, z cenami API od Mistrala. Zobacz, ile kosztuje jeden task agenta kodującego i kiedy pasuje tańszy model.
Na tej stronie
Mistral Large 4 jest teraz open-weight: Mistral opublikował wagi 29 października 2026 i ustalił cenę API na 0,70 USD za 1 mln tokenów wejściowych i 2,10 USD za 1 mln tokenów wyjściowych (0,07 USD za buforowane wejście). Jeśli uruchamiasz agentów kodujących, użytecznym pytaniem nie jest cena za token, ale ile sumuje się jeden długi task.
Co ogłosił Mistral#
Według strony wydania Mistrala (sprawdzonej 30 października 2026) Mistral Large 4 to model o około 1T parametrów, hybryda instruct i reasoning zbudowana jako mieszanka ekspertów. Jest natywnie multimodalny na wejściu, obsługuje ponad 160 języków i ma trzy tryby rozumowania: Low, Medium i High, przy czym High jest domyślny. Repozytorium Hugging Face to Mistral-; identyfikator API to mistral-.
Wagi są udostępniane na licencji Mistral Ecosystem Open-Weight, zmodyfikowanej MIT. Użycie komercyjne i fine-tuning są dozwolone. Sprzedaż modelu jako usługi hostowanej wymaga osobnej licencji komercyjnej od Mistrala. Możesz go uruchomić z vLLM lub SGLang, przez NVIDIA NIM lub TensorRT-LLM, albo użyć własnego API Mistrala, Microsoft Foundry i Mistral Vibe Code.
W benchmarkach Mistral podaje własne liczby: 41% na Terminal-Bench 4.0 (wersja preview uzyskała 28%), 19,7% na FrontierCode 2.0, 84,5% na BrowseComp i 48% na Artificial Analysis Coding Agent Index, co według Mistrala jest na poziomie GLM-5.3 przy 47% mniej tokenów na task. To wyniki dostawcy, nie niezależne, więc traktuj je jako powód do testów na własnym repo, a nie jako wyrok.
Ile kosztuje jeden task agenta w cenie Mistrala#
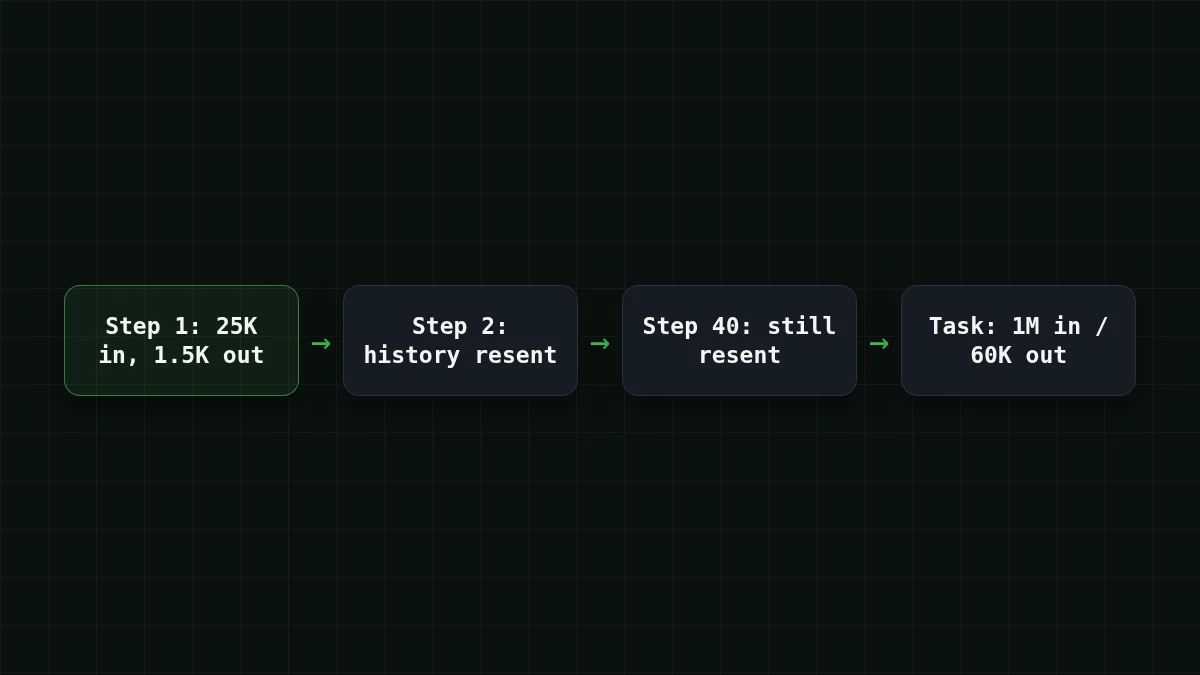
Zacznij od tego, jak agent naprawdę zużywa tokeny. Każdy krok ponownie wysyła dotychczasową rozmowę, więc wejście narasta, podczas gdy każda odpowiedź pozostaje krótka. Załóżmy, że terminalowy agent kodujący wykonuje 40 kroków na jednym tasku, z około 25 000 tokenów wejściowych i 1500 tokenów wyjściowych na krok. To założenie ilustracyjne; podstaw własne liczby.
Zgadnij liczbę
40 kroków po około 25 000 tokenów wejściowych każdy: ile tysięcy tokenów wejściowych wysyła task w sumie?
Twoje przypuszczenie
02000
Pokaż odpowiedź
Odpowiedź: 1000
25 000 × 40 = 1 000 000 tokenów wejściowych, czyli 1000 tysięcy. Agent ponownie wysyła swój kontekst na każdym kroku, dlatego wolumen wejścia dominuje w rachunkach za agenta.
W opublikowanej cenie Mistrala (30 października 2026) ten task to 1 000 000 × 0,70 USD / 1M = 0,70 USD za wejście i 60 000 × 2,10 USD / 1M = 0,126 USD za wyjście, więc 0,70 USD + 0,126 USD = 0,826 USD za task. Strona wejściowa to większość rachunku.
Buforowanie zmienia obraz. Jeśli 20 000 z 25 000 tokenów wejściowych w każdym kroku jest obsługiwanych z cache po 0,07 USD za 1M, krok kosztuje 20 000 × 0,07 USD / 1M = 0,0014 USD za buforowane wejście, 5000 × 0,70 USD / 1M = 0,0035 USD za świeże wejście i 1500 × 2,10 USD / 1M = 0,00315 USD za wyjście. To 0,00805 USD za krok, a 0,00805 USD × 40 = 0,322 USD za task. Wskaźnik trafień cache 80% to kolejne założenie, więc sprawdź, co raportuje twoje narzędzie.
Oto to samo obciążenie na kalkulatorze, który możesz przesuwać:
Kalkulator kosztów
Jeden task agenta kodującego: 40 kroków
Tokeny wejściowe na żądanie: 25 000 · Tokeny wyjściowe na żądanie: 1500 · Żądania dziennie: 40
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
A ten sam task wyceniony na modelach CheapTokens, na żywo, obok OpenRouter:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 40 żądań | OpenRouter, 40 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25 000 tokenów wejściowych i 1500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Dla tej pętli agenta DeepSeek-V4-Flash na CheapTokens wynosi $0.021 za cały task, łącznie z wejściem i wyjściem razem, i jest tańszy niż cena referencyjna OpenRouter w sumie. Ma okno kontekstu 380K i do 32 768 tokenów wyjściowych na odpowiedź, w jednej cenie o każdej porze dnia.
Otwarte wagi czy API#
Wagi to interesująca część tego wydania. Jeśli twoje dane nie mogą opuścić twojej sieci albo chcesz zrobić fine-tuning, możesz to teraz zrobić z modelem tej klasy. Kosztem tej drogi jest sprzęt. Model o 1T parametrów wymaga serwera z wieloma GPU, nawet jeśli na token aktywna jest tylko jego część, a strona Mistrala nie podaje liczby aktywnych parametrów (A52B w nazwie repozytorium sugeruje 52B, ale to wnioskowanie z nazwy). Strona Mistrala nie podaje też rozmiaru kontekstu.
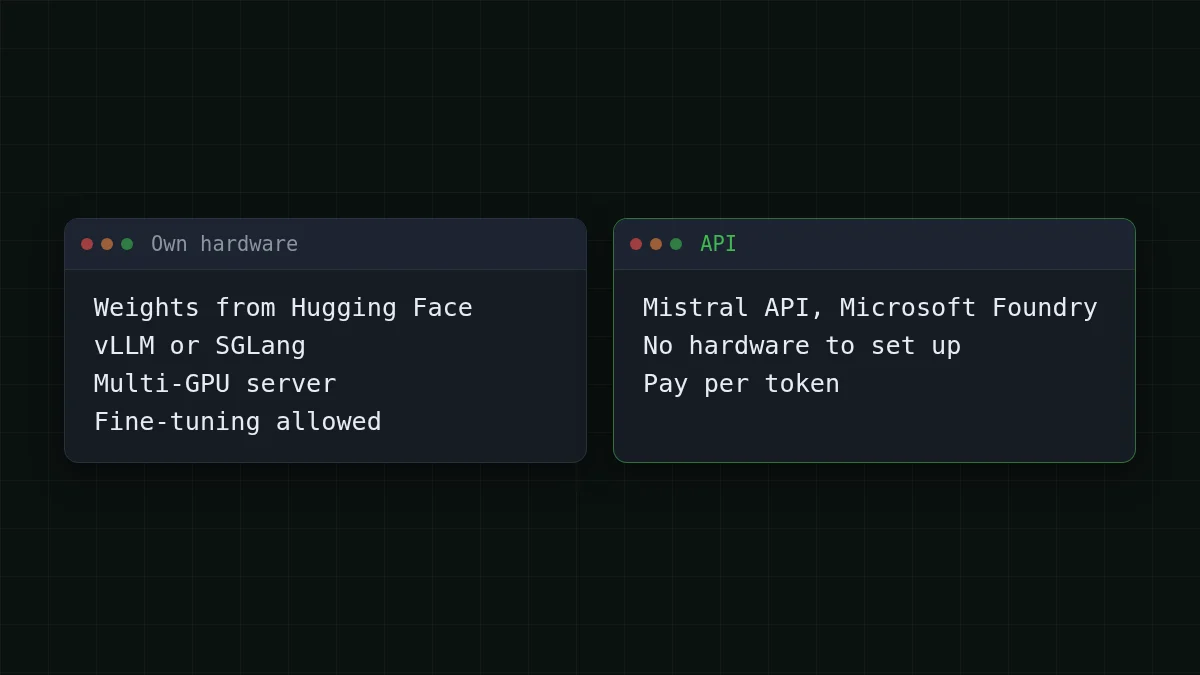
Dla większości zespołów, które po prostu chcą, aby agent kończył zgłoszenia, droga przez API pozwala uniknąć tej konfiguracji. Jeśli chcesz tła, co otwarte wagi oznaczają w praktyce, zobacz czym są otwarte wagi i kwantyzacja.
Ten sam task na modelu agenta, który możesz wywołać dziś#
Jeśli twoim celem jest agent terminalowy lub IDE, który tanio wykonuje wiele kroków, możesz wypróbować tę samą pętlę na DeepSeek-V4-Flash lub GLM-5.3-Flash przez CheapTokens. API jest zgodne z OpenAI Chat Completions i Anthropic Messages, z jednym saldem dla wszystkich modeli. Użyj pełnego identyfikatora modelu z dokumentacji CheapTokens; nazwy modeli różnią się między dostawcami.
Jedno żądanie, dwa klienty
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Pole usage w odpowiedzi pokazuje tokeny wejściowe i wyjściowe, więc możesz zmierzyć krok własnego agenta i podstawić go do kalkulatora powyżej. Nasz przewodnik po kosztach Cline pokazuje, jak zaplanować budżet całej sesji, a dokumentacja opisuje podłączanie innych narzędzi. Strony modeli: tani DeepSeek i aktualne ceny.
Który do jakiego zadania#
Otwarte wagi na własnym sprzęcie i fine-tuning to osobna ścieżka i właśnie to otwiera to wydanie. Do długiej pętli krótkich kroków użyj DeepSeek-V4-Flash na CheapTokens: kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź, jedna cena o każdej porze dnia i taniej niż OpenRouter w sumie, z wejściem i wyjściem liczonym razem. GLM-5.3-Flash ma kontekst 390K. Benchmark Mistrala porównuje z GLM-5.3 i nie mówi, który wariant GLM-5.3, więc nie przenoś jego liczb na GLM-5.3-Flash. Uruchom dziesięć własnych tasków na każdym i porównaj liczby tokenów; to samo podejście jest w jak cena GPT-6.1 Terra wychodzi na task.


