Новости AIОбновление
Mistral Large 4: открытые веса, цена API и стоимость задачи агента
Mistral Large 4 теперь с открытыми весами и ценой API от Mistral. Считаем задачу кодинг-агента и смотрим, когда подойдёт модель дешевле.
Содержание
Mistral Large 4 теперь с открытыми весами: Mistral опубликовала их 29 октября 2026 и назначила цену API — $0.70 за 1M входных токенов и $2.10 за 1M выходных ($0.07 за кэшированный вход). Если вы запускаете кодинг-агентов, важна не цена за токен, а во что складывается одна длинная задача.
Что объявила Mistral#
По странице выпуска Mistral (проверено 30 октября 2026), Mistral Large 4 — модель примерно на 1T параметров, гибрид instruct и reasoning на архитектуре mixture of experts. Она нативно мультимодальна на входе, знает 160+ языков и имеет три режима рассуждения — Low, Medium и High; по умолчанию включён High. Репозиторий на Hugging Face — Mistral-, id в API — mistral-.
Веса выходят под лицензией Mistral Ecosystem Open-Weight — это модифицированная MIT. Коммерческое использование и дообучение разрешены. Чтобы продавать модель как хостинг-сервис, нужна отдельная коммерческая лицензия Mistral. Запускать можно через vLLM или SGLang, NVIDIA NIM или TensorRT-LLM, а ещё через API Mistral, Microsoft Foundry и Mistral Vibe Code.
Бенчмарки Mistral приводит свои: 41% на Terminal-Bench 4.0 (у превью было 28%), 19.7% на FrontierCode 2.0, 84.5% на BrowseComp и 48% в Artificial Analysis Coding Agent Index — по словам Mistral, на уровне GLM-5.3 при 47% меньше токенов на задачу. Это результаты самого разработчика, не независимые, так что считайте их поводом проверить модель на своём репозитории, а не приговором.
Сколько стоит задача агента по цене Mistral#
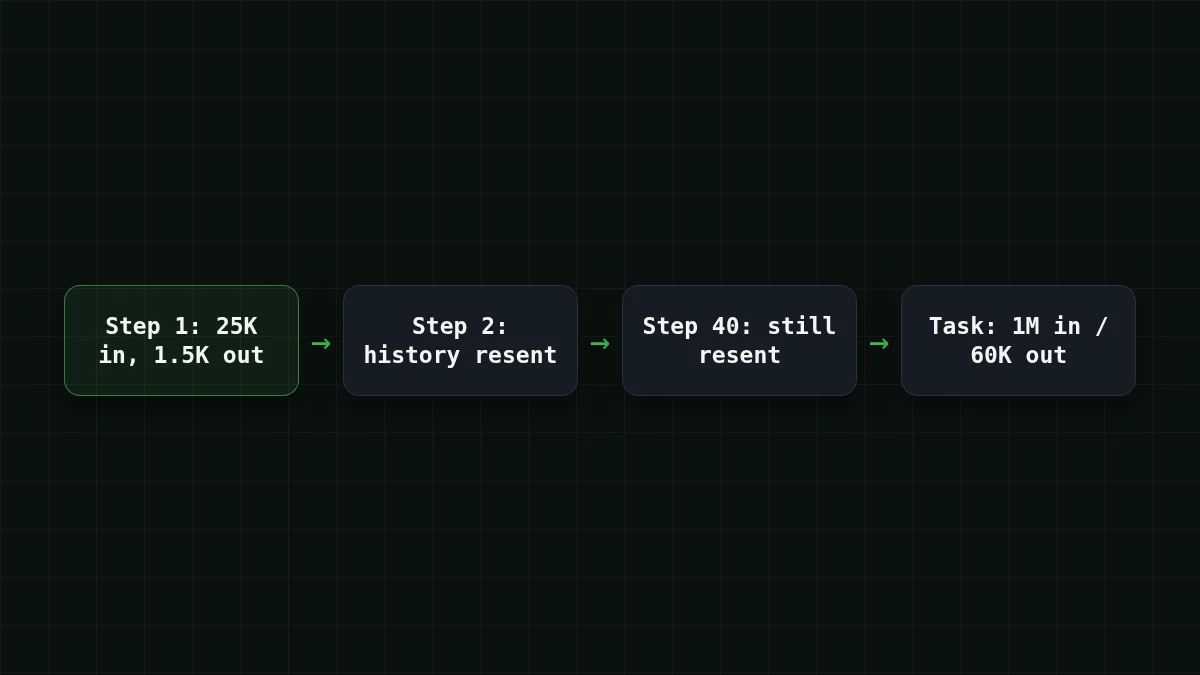
Начнём с того, как агент на самом деле тратит токены. Каждый шаг заново отправляет весь разговор, поэтому вход копится, а ответы остаются короткими. Допустим, терминальный кодинг-агент делает на задачу 40 шагов: примерно 25 000 входных и 1 500 выходных токенов на шаг. Это допущение для примера — подставьте свои цифры.
Угадайте число
40 шагов по 25 000 входных токенов: сколько тысяч входных токенов уйдёт за всю задачу?
Ваш вариант
02 000
Показать ответ
Ответ: 1 000
25 000 × 40 = 1 000 000 входных токенов, то есть 1 000 тысяч. Агент пересылает контекст на каждом шаге, поэтому в счетах агентов преобладает вход.
По опубликованной цене Mistral (30 октября 2026) задача выходит так: 1 000 000 × $0.70 / 1M = $0.70 за вход и 60 000 × $2.10 / 1M = $0.126 за выход, итого $0.70 + $0.126 = $0.826 за задачу. Большая часть счёта — вход.
Кэш меняет картину. Если 20 000 из 25 000 входных токенов на каждом шаге берутся из кэша по $0.07 за 1M, шаг стоит 20 000 × $0.07 / 1M = $0.0014 за кэшированный вход, 5 000 × $0.70 / 1M = $0.0035 за свежий вход и 1 500 × $2.10 / 1M = $0.00315 за выход. Это $0.00805 за шаг, а $0.00805 × 40 = $0.322 за задачу. Доля попаданий в кэш 80% — тоже допущение, сверьтесь с тем, что показывает ваш инструмент.
Та же нагрузка в калькуляторе, который можно двигать:
Калькулятор стоимости
Одна задача кодинг-агента: 40 шагов
Входные токены на запрос: 25 000 · Выходные токены на запрос: 1 500 · Запросов в день: 40
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
И та же задача по моделям CheapTokens, на живых ценах и рядом с OpenRouter:
| Модель | Вход $/1M | Выход $/1M | За запрос | 40 запросов | OpenRouter, 40 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25 000 входных и 1 500 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Для такого цикла DeepSeek-V4-Flash в CheapTokens обходится в $0.021 за всю задачу — это сумма с учётом входа и выхода, и в сумме она дешевле референсной цены OpenRouter. Контекст 380K, до 32 768 токенов в одном ответе, одна цена в любое время суток.
Открытые веса или API#
Веса — самое интересное в этом выпуске. Если данные нельзя выпускать из вашей сети или вы хотите дообучать, теперь это можно сделать на модели такого класса. Цена такого пути — железо. Модели на 1T параметров нужен сервер с несколькими GPU, даже если на токен активна только часть; число активных параметров на странице Mistral не названо (A52B в имени репозитория намекает на 52B, но это вывод из названия). Размер контекста страница тоже не указывает.
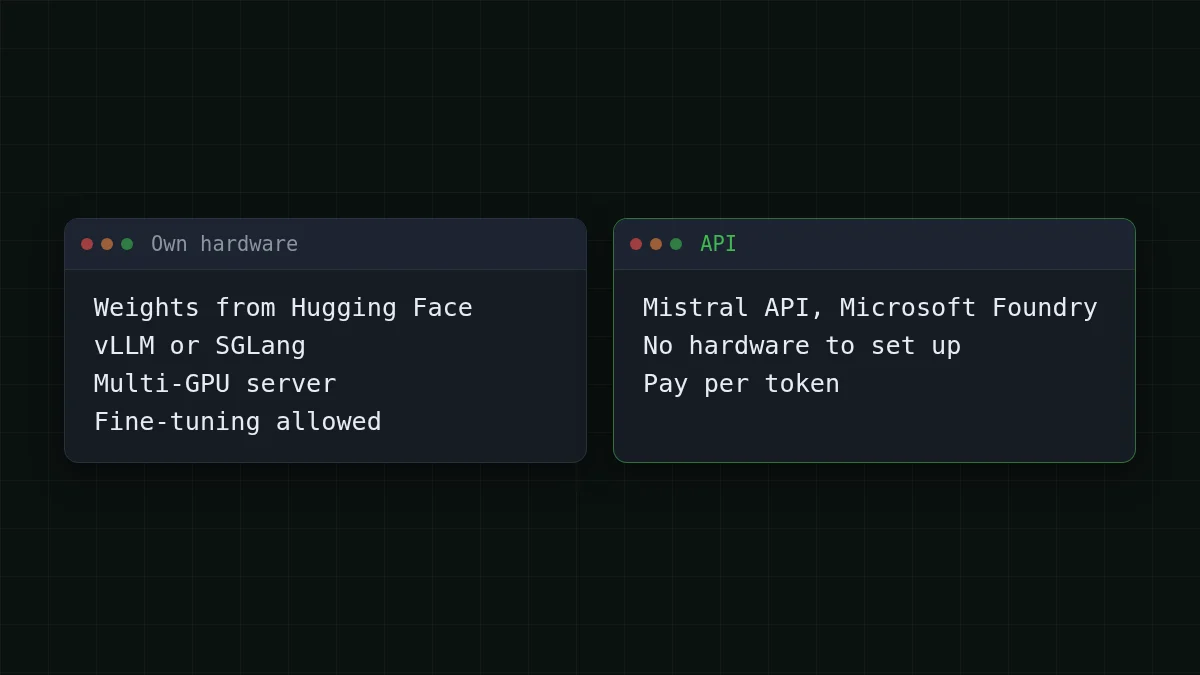
Большинству команд, которым нужно, чтобы агент закрывал тикеты, проще идти через API без такой настройки. Что такое открытые веса на практике — в статье про открытые веса и квантизацию.
Та же задача на агентной модели, которую можно вызвать сегодня#
Если вам нужен терминальный или IDE-агент, который дёшево делает много шагов, прогоните тот же цикл на DeepSeek-V4-Flash или GLM-5.3-Flash через CheapTokens. API совместим с OpenAI Chat Completions и Anthropic Messages, баланс один на все модели. Берите полный id модели из документации CheapTokens: у разных провайдеров имена отличаются.
Один запрос, два клиента
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Поле usage в ответе показывает входные и выходные токены — так вы измерите шаг своего агента и подставите в калькулятор выше. Разбор стоимости Cline показывает, как заложить бюджет на всю сессию, а документация — как подключить другие инструменты. Страницы моделей: дешёвый DeepSeek и живые цены.
Что для какой работы#
Открытые веса на своём железе и дообучение — отдельный путь, его и открывает этот выпуск. Для длинного цикла коротких шагов берите в CheapTokens DeepSeek-V4-Flash: контекст 380K, до 32 768 токенов в ответе, одна цена в любое время суток, а в сумме с учётом входа и выхода она дешевле OpenRouter. У GLM-5.3-Flash контекст 390K. Бенчмарк Mistral сравнивает с GLM-5.3, не уточняя, какой именно вариант, поэтому не переносите его цифры на GLM-5.3-Flash. Прогоните по десять своих задач на каждой и сравните число токенов; тот же подход — в статье про цену GPT-6.1 Terra на задачу.


