AI সংবাদআপডেট
Mistral Large 4 ওপেন ওয়েট: API দাম ও প্রতি এজেন্ট কাজের খরচ
Mistral Large 4 এখন ওপেন-ওয়েট, Mistral-এর API দামসহ। দেখুন একটি কোডিং-এজেন্ট কাজের খরচ কত এবং কখন সস্তা মডেল মানানসই।
এই পৃষ্ঠায়
Mistral Large 4 এখন ওপেন-ওয়েট: Mistral ২৯ অক্টোবর ২০২৬-এ ওয়েটগুলো প্রকাশ করেছে এবং API-এর দাম নির্ধারণ করেছে প্রতি ১M ইনপুট টোকেনে $0.70 এবং প্রতি ১M আউটপুট টোকেনে $2.10 (ক্যাশড ইনপুটের জন্য $0.07)। আপনি যদি কোডিং এজেন্ট চালান, তাহলে কাজের প্রশ্নটি প্রতি টোকেনের দাম নয়, বরং একটি দীর্ঘ কাজ মিলিয়ে কত দাঁড়ায় তা।
Mistral কী ঘোষণা করেছে#
Mistral-এর রিলিজ পেজ অনুযায়ী (৩০ অক্টোবর ২০২৬-এ যাচাই করা), Mistral Large 4 প্রায় ১T প্যারামিটারের একটি মডেল, যা instruct ও reasoning-এর একটি হাইব্রিড এবং mixture of experts হিসেবে তৈরি। এটি ইনপুটে নেটিভভাবে মাল্টিমোডাল, ১৬০+ ভাষা কভার করে এবং তিনটি reasoning মোড রয়েছে—Low, Medium ও High, যেখানে High ডিফল্ট। Hugging Face রিপোজিটরি Mistral-; API আইডি mistral-।
ওয়েটগুলো Mistral Ecosystem Open-Weight লাইসেন্সের অধীনে আসে, যা একটি পরিবর্তিত MIT। বাণিজ্যিক ব্যবহার ও ফাইন-টিউনিং অনুমোদিত। মডেলটিকে হোস্টেড সার্ভিস হিসেবে বিক্রি করতে Mistral থেকে আলাদা বাণিজ্যিক লাইসেন্স প্রয়োজন। আপনি এটি vLLM বা SGLang দিয়ে, NVIDIA NIM বা TensorRT-LLM-এর মাধ্যমে, অথবা Mistral-এর নিজস্ব API, Microsoft Foundry ও Mistral Vibe Code ব্যবহার করে চালাতে পারেন।
বেঞ্চমার্কে Mistral নিজের সংখ্যা জানিয়েছে: Terminal-Bench 4.0-এ ৪১% (প্রিভিউ স্কোর করেছিল ২৮%), FrontierCode 2.0-এ ১৯.৭%, BrowseComp-এ ৮৪.৫%, এবং Artificial Analysis Coding Agent Index-এ ৪৮%, যা Mistral-এর দাবি অনুযায়ী প্রতি কাজে ৪৭% কম টোকেনে GLM-5.3-এর ৪৭%-এর সমান। এগুলো ভেন্ডরের ফলাফল, স্বাধীন নয়, তাই এগুলোকে রায় নয় বরং নিজের রিপোতে পরীক্ষা করার কারণ হিসেবে ধরুন।
Mistral-এর দামে একটি এজেন্ট কাজের খরচ#
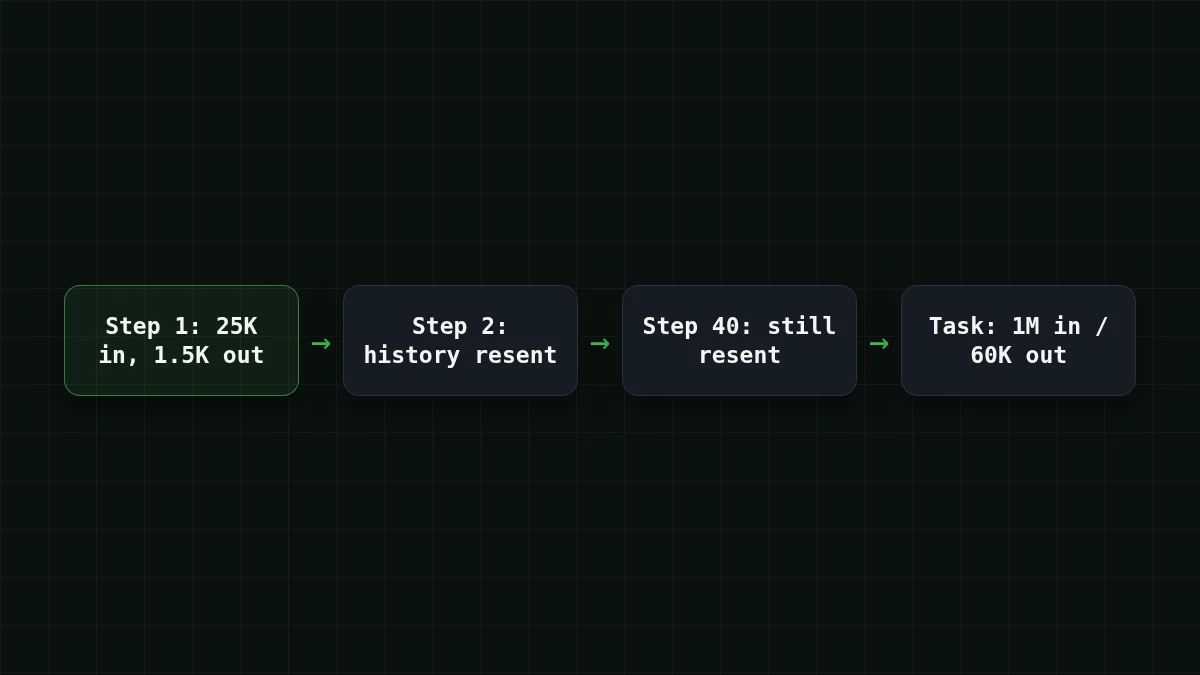
শুরু করুন এজেন্ট আসলে কীভাবে টোকেন খরচ করে তা দিয়ে। প্রতিটি ধাপ এখন পর্যন্ত কথোপকথন আবার পাঠায়, তাই ইনপুট জমতে থাকে আর প্রতিটি উত্তর ছোট থাকে। ধরুন একটি টার্মিনাল কোডিং এজেন্ট একটি কাজে ৪০ ধাপ নেয়, প্রতি ধাপে প্রায় ২৫,০০০ ইনপুট টোকেন ও ১,৫০০ আউটপুট টোকেন। এটি দৃষ্টান্তের জন্য একটি অনুমান; নিজের সংখ্যা বসিয়ে নিন।
সংখ্যা অনুমান করুন
৪০ ধাপ, প্রতিটিতে প্রায় ২৫,০০০ ইনপুট টোকেন: কাজটি মোট কত হাজার ইনপুট টোকেন পাঠায়?
আপনার অনুমান
০২,০০০
উত্তর দেখান
উত্তর: ১,০০০
২৫,০০০ × ৪০ = ১,০০০,০০০ ইনপুট টোকেন, অর্থাৎ ১,০০০ হাজার। এজেন্ট প্রতিটি ধাপে তার কনটেক্সট আবার পাঠায়, এজন্যই ইনপুটের পরিমাণ এজেন্টের বিলে প্রাধান্য পায়।
Mistral-এর প্রকাশিত দামে (৩০ অক্টোবর ২০২৬) সেই কাজটি ইনপুটের জন্য ১,০০০,০০০ × $0.70 / 1M = $0.70 এবং আউটপুটের জন্য ৬০,০০০ × $2.10 / 1M = $0.126, তাই প্রতি কাজে $0.70 + $0.126 = $0.826। বিলের বেশিরভাগই ইনপুট দিক।
ক্যাশিং ছবিটা বদলে দেয়। যদি প্রতিটি ধাপে ২৫,০০০ ইনপুট টোকেনের মধ্যে ২০,০০০ ক্যাশ থেকে প্রতি ১M-এ $0.07-এ সরবরাহ হয়, তাহলে একটি ধাপে ক্যাশড ইনপুটের জন্য ২০,০০০ × $0.07 / 1M = $0.0014, নতুন ইনপুটের জন্য ৫,০০০ × $0.70 / 1M = $0.0035 এবং আউটপুটের জন্য ১,৫০০ × $2.10 / 1M = $0.00315। এটি প্রতি ধাপে $0.00805, এবং $0.00805 × 40 = প্রতি কাজে $0.322। ৮০% ক্যাশ হিট রেট আরেকটি অনুমান, তাই আপনার টুল কী রিপোর্ট করে তা দেখে নিন।
একই কাজভার একটি ক্যালকুলেটরে যা আপনি সরাতে পারেন:
খরচ ক্যালকুলেটর
একটি কোডিং-এজেন্ট কাজ: ৪০ ধাপ
প্রতি অনুরোধে ইনপুট টোকেন: ২৫,০০০ · প্রতি অনুরোধে আউটপুট টোকেন: ১,৫০০ · প্রতিদিন অনুরোধ: ৪০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
এবং একই কাজ CheapTokens মডেলগুলোর দামে, লাইভ, OpenRouter-এর পাশে:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ৪০টি অনুরোধ | OpenRouter, ৪০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
প্রতি অনুরোধে ২৫,০০০ ইনপুট এবং ১,৫০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
এই এজেন্ট লুপের জন্য, CheapTokens-এ DeepSeek-V4-Flash পুরো কাজের জন্য $0.021-এ দাঁড়ায়, ইনপুট ও আউটপুট একসাথে ধরে মোট হিসেবে, এবং মোট হিসেবে এটি OpenRouter-এর রেফারেন্স দামের চেয়ে সস্তা। এতে ৩৮০K কনটেক্সট উইন্ডো এবং প্রতি উত্তরে সর্বোচ্চ ৩২,৭৬৮ আউটপুট টোকেন, দিনের যেকোনো সময়ে একই দাম।
ওপেন ওয়েট নাকি API#
এই রিলিজের আকর্ষণীয় অংশ হলো ওয়েটগুলো। যদি আপনার ডেটা আপনার নেটওয়ার্ক ছাড়তে না পারে, বা আপনি ফাইন-টিউন করতে চান, এখন এই শ্রেণির একটি মডেল দিয়ে তা করতে পারেন। সেই পথের খরচ হলো হার্ডওয়্যার। একটি ১T-প্যারামিটার মডেলের জন্য মাল্টি-GPU সার্ভার দরকার, এমনকি প্রতি টোকেনে এর একটি অংশই সক্রিয় থাকলেও, এবং Mistral-এর পেজে সক্রিয় প্যারামিটারের সংখ্যা উল্লেখ নেই (রিপোজিটরির নামে A52B ৫২B নির্দেশ করে, তবে এটি নাম থেকে একটি অনুমান)। Mistral-এর পেজে কনটেক্সট সাইজও উল্লেখ নেই।
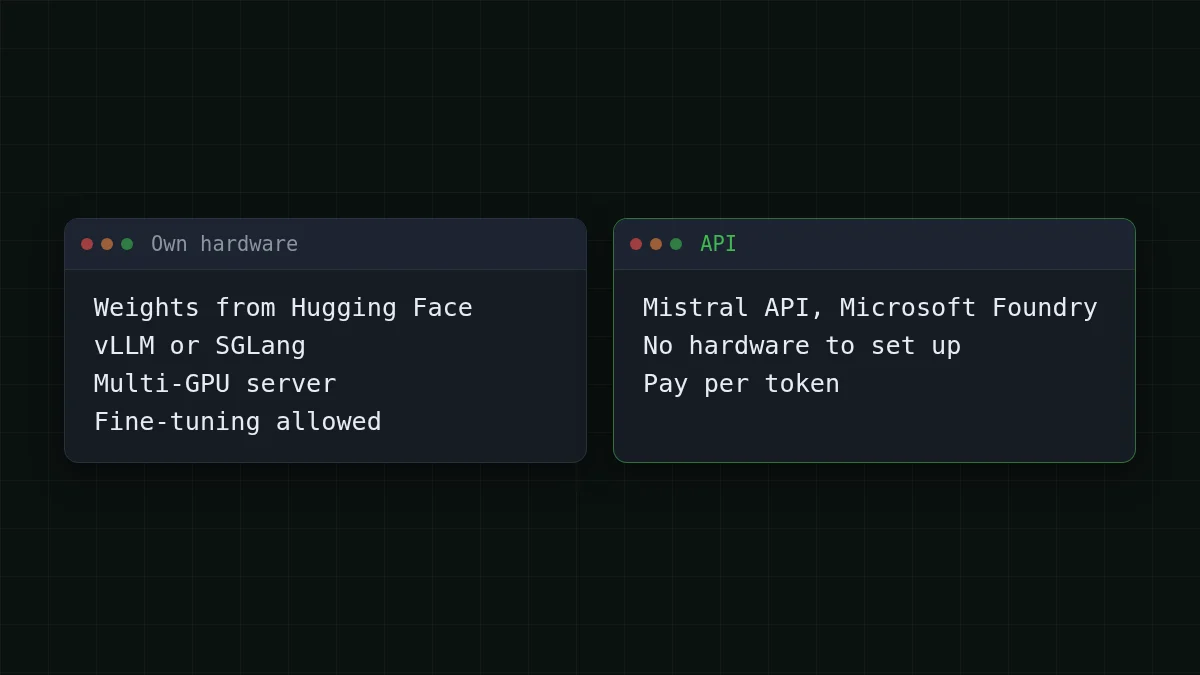
বেশিরভাগ দলের জন্য যারা শুধু চান একটি এজেন্ট টিকিট শেষ করুক, API পথটি সেই সেটআপ এড়ায়। ওপেন ওয়েট বাস্তবে কী বোঝায় তার পটভূমি চাইলে দেখুন ওপেন ওয়েট ও কোয়ান্টাইজেশন কী।
আজই কল করা যায় এমন একটি এজেন্ট মডেলে একই কাজ#
যদি আপনার লক্ষ্য হয় একটি টার্মিনাল বা IDE এজেন্ট যা সস্তায় অনেক ধাপ চালায়, আপনি CheapTokens-এর মাধ্যমে DeepSeek-V4-Flash বা GLM-5.3-Flash-এ একই লুপ চেষ্টা করতে পারেন। API হলো OpenAI Chat Completions ও Anthropic Messages সামঞ্জস্যপূর্ণ, সব মডেলের জন্য একটি ব্যালেন্স। CheapTokens ডকস থেকে সম্পূর্ণ মডেল আইডি ব্যবহার করুন; প্রদানকারীদের মধ্যে মডেলের নাম আলাদা।
একটি অনুরোধ, দুটি ক্লায়েন্ট
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
রেসপন্সে usage ফিল্ডটি ইনপুট ও আউটপুট টোকেন দেখায়, তাই আপনি নিজের এজেন্টের ধাপ মাপতে পারেন এবং উপরের ক্যালকুলেটরে বসাতে পারেন। আমাদের Cline খরচ গাইড দেখায় কীভাবে একটি সম্পূর্ণ সেশন বাজেট করবেন, এবং ডকস অন্য টুল সংযোগ করা কভার করে। মডেল পেজ: সস্তা DeepSeek, এবং লাইভ দাম।
কোন কাজে কোনটি#
নিজের হার্ডওয়্যারে ওপেন ওয়েট, এবং ফাইন-টিউনিং, একটি আলাদা পথ, এবং এই রিলিজ সেটাই খুলে দেয়। ছোট ধাপের দীর্ঘ লুপের জন্য CheapTokens-এ DeepSeek-V4-Flash ব্যবহার করুন: ৩৮০K কনটেক্সট, প্রতি উত্তরে সর্বোচ্চ ৩২,৭৬৮ আউটপুট টোকেন, দিনের যেকোনো সময়ে একই দাম, এবং ইনপুট ও আউটপুট একসাথে ধরে মোট হিসেবে OpenRouter-এর চেয়ে সস্তা। GLM-5.3-Flash-এ ৩৯০K কনটেক্সট। Mistral-এর বেঞ্চমার্ক GLM-5.3-এর সঙ্গে তুলনা করে, এবং এটি বলে না কোন GLM-5.3 ভ্যারিয়েন্ট, তাই এর সংখ্যাগুলো GLM-5.3-Flash-এর ওপর পড়বেন না। প্রতিটিতে আপনার নিজের দশটি কাজ চালান এবং টোকেন সংখ্যা তুলনা করুন; একই পদ্ধতি আছে GPT-6.1 Terra-র দাম প্রতি কাজে কীভাবে দাঁড়ায়-তে।


