Balitang AIUpdate
Mistral Large 4 open weights: presyo ng API at gastos kada agent task
Ang Mistral Large 4 ay open-weight na ngayon, na may API pricing mula sa Mistral. Tingnan kung magkano ang isang coding-agent task at kung kailan bagay ang mas murang modelo.
Sa pahinang ito
Mistral Large 4 ay open-weight na ngayon: inilathala ng Mistral ang mga timbang noong 29 Oktubre 2026 at itinakda ang presyo ng API sa $0.70 kada 1M input token at $2.10 kada 1M output token ($0.07 para sa naka-cache na input). Kung nagpapatakbo ka ng coding agents, ang kapaki-pakinabang na tanong ay hindi ang presyo kada token kundi kung magkano ang idinadagdag ng isang mahabang gawain.
Ano ang inanunsyo ng Mistral#
Ayon sa release page ng Mistral (sinuri noong 30 Oktubre 2026), ang Mistral Large 4 ay isang modelo na may humigit-kumulang 1T parameter, isang hybrid ng instruct at reasoning na ginawa bilang mixture of experts. Ito ay native na multimodal sa input, sumasaklaw sa 160+ wika at may tatlong reasoning mode, Low, Medium at High, na ang High ang default. Ang Hugging Face repository ay Mistral-; ang API id ay mistral-.
Ang mga timbang ay ipinapadala sa ilalim ng Mistral Ecosystem Open-Weight license, isang binagong MIT. Pinapayagan ang komersyal na paggamit at fine-tuning. Ang pagbebenta ng modelo bilang hosted service ay nangangailangan ng hiwalay na komersyal na lisensya mula sa Mistral. Maaari mo itong patakbuhin gamit ang vLLM o SGLang, sa pamamagitan ng NVIDIA NIM o TensorRT-LLM, o gamitin ang sariling API ng Mistral, Microsoft Foundry at Mistral Vibe Code.
Sa mga benchmark, iniuulat ng Mistral ang sarili nitong mga numero: 41% sa Terminal-Bench 4.0 (ang preview ay nakakuha ng 28%), 19.7% sa FrontierCode 2.0, 84.5% sa BrowseComp, at 48% sa Artificial Analysis Coding Agent Index, na sinasabi ng Mistral ay kasing-antas ng GLM-5.3 sa 47% na mas kaunting token kada gawain. Ito ay mga resulta ng vendor, hindi independiyente, kaya ituring ang mga ito bilang dahilan para subukan sa iyong sariling repo kaysa sa isang hatol.
Magkano ang isang agent task sa presyo ng Mistral#
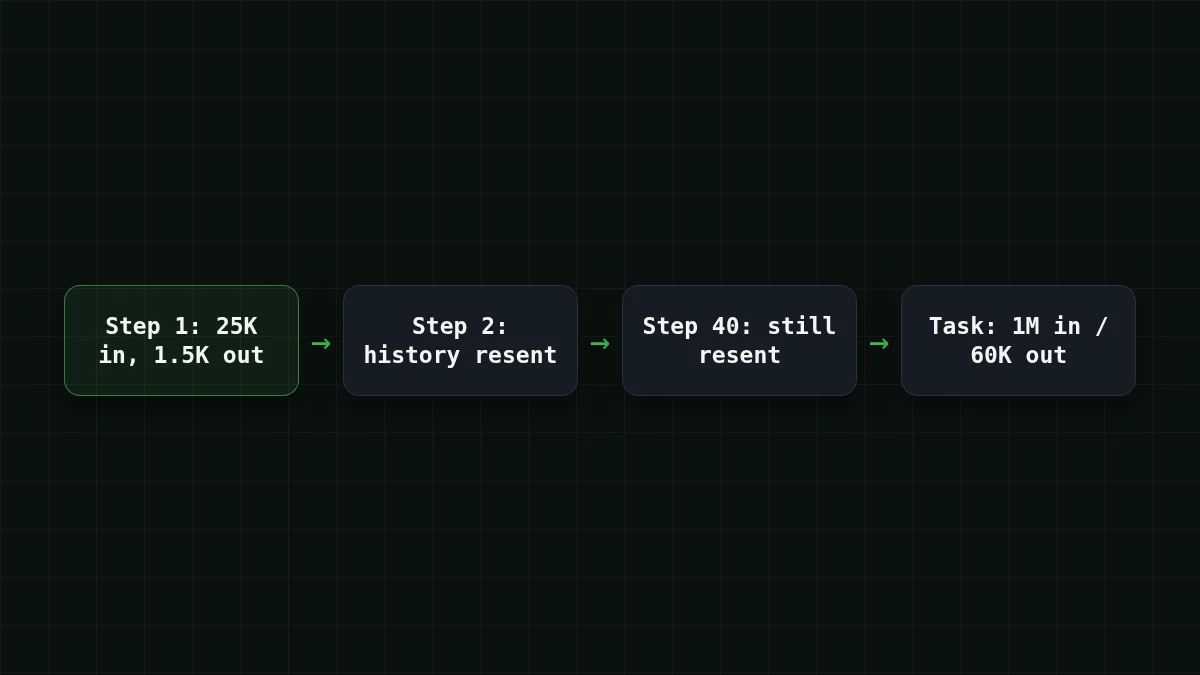
Magsimula sa kung paano talaga gumagastos ng token ang isang agent. Bawat hakbang ay muling ipinapadala ang pag-uusap sa ngayon, kaya nag-iipon ang input habang bawat sagot ay nananatiling maikli. Sabihin nating ang isang terminal coding agent ay tumatagal ng 40 hakbang sa isang gawain, na may humigit-kumulang 25,000 input token at 1,500 output token kada hakbang. Iyon ay isang palagay para sa paglalarawan; palitan ng sarili mong mga numero.
Hulaan ang numero
40 hakbang sa humigit-kumulang 25,000 input token bawat isa: ilang libong input token ang ipinapadala ng gawain sa kabuuan?
Ang iyong hula
02,000
Ipakita ang sagot
Sagot: 1,000
25,000 × 40 = 1,000,000 input token, kaya 1,000 libo. Muling ipinapadala ng agent ang konteksto nito sa bawat hakbang, kaya nangingibabaw ang dami ng input sa mga bill ng agent.
Sa inilathalang presyo ng Mistral (30 Oktubre 2026), ang gawaing iyon ay 1,000,000 × $0.70 / 1M = $0.70 para sa input at 60,000 × $2.10 / 1M = $0.126 para sa output, kaya $0.70 + $0.126 = $0.826 kada gawain. Ang input side ang karamihan ng bill.
Binabago ng caching ang larawan. Kung 20,000 sa 25,000 input token sa bawat hakbang ay hinahain mula sa cache sa $0.07 kada 1M, ang isang hakbang ay nagkakahalaga ng 20,000 × $0.07 / 1M = $0.0014 para sa naka-cache na input, 5,000 × $0.70 / 1M = $0.0035 para sa sariwang input at 1,500 × $2.10 / 1M = $0.00315 para sa output. Iyon ay $0.00805 kada hakbang, at $0.00805 × 40 = $0.322 kada gawain. Ang 80% cache hit rate ay isa pang palagay, kaya tingnan kung ano ang iniuulat ng iyong tool.
Narito ang parehong workload sa isang calculator na maaari mong ilipat:
Calculator ng gastos
Isang coding-agent task: 40 hakbang
Mga input token bawat kahilingan: 25,000 · Mga output token bawat kahilingan: 1,500 · Mga kahilingan bawat araw: 40
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0224 | $0.672 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.021 | $0.63 |
| MiniMax-M2.7$0.05$0.15 | $0.059 | $1.77 |
At ang parehong gawain na naka-presyo sa mga modelo ng CheapTokens, live, katabi ng OpenRouter:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 40 mga kahilingan | OpenRouter, 40 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00056 | $0.0224 | $0.0458 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00053 | $0.021 | $0.0569 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0015 | $0.059 | $0.372 |
25,000 input at 1,500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Para sa agent loop na ito, ang DeepSeek-V4-Flash sa CheapTokens ay umabot sa $0.021 para sa buong gawain, sa kabuuan kasama ang input at output na binibilang nang magkasama, at ito ay mas mura kaysa sa reference na presyo ng OpenRouter sa kabuuan. Mayroon itong 380K context window at hanggang 32,768 output token kada sagot, sa isang presyo sa anumang oras ng araw.
Open weights o ang API#
Ang mga timbang ang kawili-wiling bahagi ng release na ito. Kung ang iyong data ay hindi makalabas ng iyong network, o gusto mong mag-fine-tune, magagawa mo na iyon ngayon gamit ang isang modelo ng ganitong klase. Ang gastos ng rutang iyon ay hardware. Ang isang 1T-parameter na modelo ay nangangailangan ng multi-GPU server kahit na bahagi lamang nito ang aktibo kada token, at hindi tinukoy ng pahina ng Mistral ang bilang ng aktibong parameter (ang A52B sa pangalan ng repository ay nagmumungkahi ng 52B, ngunit iyon ay isang hinuha mula sa pangalan). Hindi rin tinukoy ng pahina ng Mistral ang laki ng konteksto.
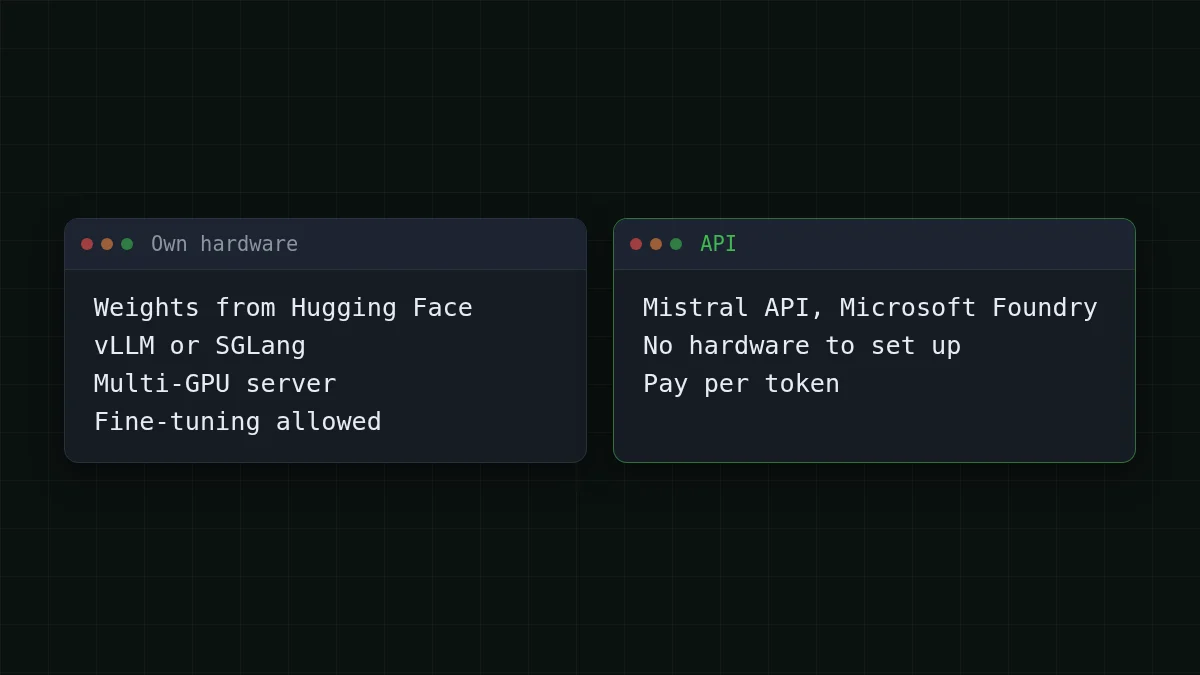
Para sa karamihan ng mga team na gusto lang na matapos ng isang agent ang mga ticket, iniiwasan ng API route ang setup na iyon. Kung gusto mo ng background sa kung ano ang ibig sabihin ng open weights sa practice, tingnan ang ano ang open weights at quantization.
Parehong gawain sa isang agent model na maaari mong tawagan ngayon#
Kung ang layunin mo ay isang terminal o IDE agent na tumatakbo ng maraming hakbang nang mura, maaari mong subukan ang parehong loop sa DeepSeek-V4-Flash o GLM-5.3-Flash sa pamamagitan ng CheapTokens. Ang API ay OpenAI Chat Completions at Anthropic Messages compatible, na may isang balanse para sa lahat ng modelo. Gamitin ang buong model id mula sa mga docs ng CheapTokens; nagkakaiba ang mga pangalan ng modelo sa pagitan ng mga provider.
Isang request, dalawang client
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}], "max_tokens": 1500}'
Python
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_CHEAPTOKENS_KEY")
resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Find the bug in this stack trace and propose a fix."}],
    max_tokens=1500,
)
print(resp.choices[0].message.content)
print(resp.usage)
Ang usage field sa response ay nagpapakita ng input at output token, kaya masusukat mo ang hakbang ng sarili mong agent at maipasok ito sa calculator sa itaas. Ang aming Cline cost guide ay nagpapakita kung paano mag-budget ng isang buong session, at ang docs ay sumasaklaw sa pagkonekta ng iba pang tool. Mga pahina ng modelo: murang DeepSeek, at live na pricing.
Alin para sa aling trabaho#
Ang open weights sa sarili mong hardware, at fine-tuning, ay isang hiwalay na landas, at iyon ang binuksan ng release na ito. Para sa isang mahabang loop ng maiikling hakbang, gamitin ang DeepSeek-V4-Flash sa CheapTokens: 380K context, hanggang 32,768 output token kada sagot, isang presyo sa anumang oras ng araw, at mas mura kaysa sa OpenRouter sa kabuuan, kasama ang input at output na binibilang nang magkasama. Ang GLM-5.3-Flash ay may 390K context. Inihahambing ng benchmark ng Mistral laban sa GLM-5.3, at hindi nito sinasabi kung aling variant ng GLM-5.3, kaya huwag basahin ang mga numero nito sa GLM-5.3-Flash. Patakbuhin ang sampu sa sarili mong mga gawain sa bawat isa at ihambing ang mga bilang ng token; ang parehong diskarte ay nasa paano lumalabas ang presyo ng GPT-6.1 Terra kada gawain.


