Custo de handoff multi-agente: o que uma cadeia de 3 agentes usa em tokens
Entenda por que cada agente em uma cadeia relê todos os handoffs anteriores, quanto isso custa em tokens, e três mudanças que reduzem a entrada.
Nesta página
- Onde os tokens se acumulam
- Quanto custam 100 tarefas por dia
- Três formas de reduzir a conta
- 1. Faça do handoff uma nota curta e estruturada
- 2. Passe a cada agente apenas o que ele precisa
- 3. Dê um modelo barato a papéis curtos
- Por que não passar apenas o KV cache?
- Antes de escalar para centenas de execuções
Seus três agentes terminaram o trabalho, e a conta é maior do que o trabalho parece. O motivo é simples: com handoffs em texto, cada agente paga para ler tudo o que os agentes anteriores escreveram. Um plano de 1.500 tokens é pago uma vez quando o planejador o escreve, depois de novo pelo programador, e de novo pelo revisor. Enxugue o handoff, entregue a cada agente apenas o que ele precisa, e a entrada de cada agente posterior fica menor.
Abaixo: um exemplo prático de 3 agentes com a matemática de tokens, uma estimativa de custo para 100 tarefas por dia com preços ao vivo, e três mudanças que você pode fazer hoje. As APIs de chat-completions são stateless, então cada requisição carrega seu contexto completo novamente (por que um chat longo custa mais e como o array de mensagens funciona cobrem o básico).
Onde os tokens se acumulam#
Digamos que você rode um planejador, um programador e um revisor. A tarefa mais as instruções somam 1.000 tokens. O planejador escreve um plano de 1.500 tokens, o programador escreve 3.000 tokens de código e anotações, o revisor escreve um veredito de 800 tokens. Esses são números redondos para o exemplo, não uma medição; troque pelos seus próprios a partir do campo usage (como lê-lo).
Adivinhar o número
Quantos tokens o revisor lê como entrada?
O seu palpite
08.000
Mostrar resposta
Resposta: 5.500
5.500: a tarefa (1.000), o plano (1.500) e o código (3.000) chegam todos na requisição dele.
A entrada de cada agente é a tarefa mais cada handoff que ele recebe:
Role a tabela para a direita →
| Agente | Lê (entrada) | Escreve (saída) |
|---|---|---|
| Planejador | 1.000 (tarefa) | 1.500 |
| Programador | 1.000 + 1.500 = 2.500 | 3.000 |
| Revisor | 1.000 + 1.500 + 3.000 = 5.500 | 800 |
| Cadeia inteira | 1.000 + 2.500 + 5.500 = 9.000 | 1.500 + 3.000 + 800 = 5.300 |
A cadeia lê 9.000 tokens para produzir 5.300. Adicione um quarto agente e ele leria a tarefa mais os três handoffs, então a entrada cresce a cada salto, não apenas em um handoff.
Quanto custam 100 tarefas por dia#
Um token de handoff é cobrado uma vez como saída, quando o agente o escreve, e depois como entrada para cada agente posterior que o lê. Tokens de saída custam mais caro que tokens de entrada, então neste exemplo as respostas são a maior parte da conta mesmo que a cadeia leia mais do que escreve (tokens de entrada vs saída).
Uma tarefa é 9.000 tokens de entrada e 5.300 de saída. No MiniMax-M2.7 isso é $0.0012 por tarefa. Para 100 tarefas por dia, estes são os preços ao vivo entre nossos modelos, ao lado do OpenRouter:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 100 solicitações | OpenRouter, 100 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9.000 tokens de entrada e 5.300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
No total, com entrada e saída contadas juntas, os modelos CheapTokens acima saem mais baratos que o OpenRouter para esta cadeia.
Quer o cálculo para a sua própria cadeia? Coloque a requisição média de um agente na calculadora: cerca de 3.000 tokens de entrada e 1.800 de saída, repetidos 300 vezes, são 100 tarefas de três agentes.
Calculadora de custos
100 tarefas por dia, três agentes cada
Tokens de entrada por solicitação: 3.000 · Tokens de saída por solicitação: 1.800 · Solicitações por dia: 300
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Três formas de reduzir a conta#
1. Faça do handoff uma nota curta e estruturada#
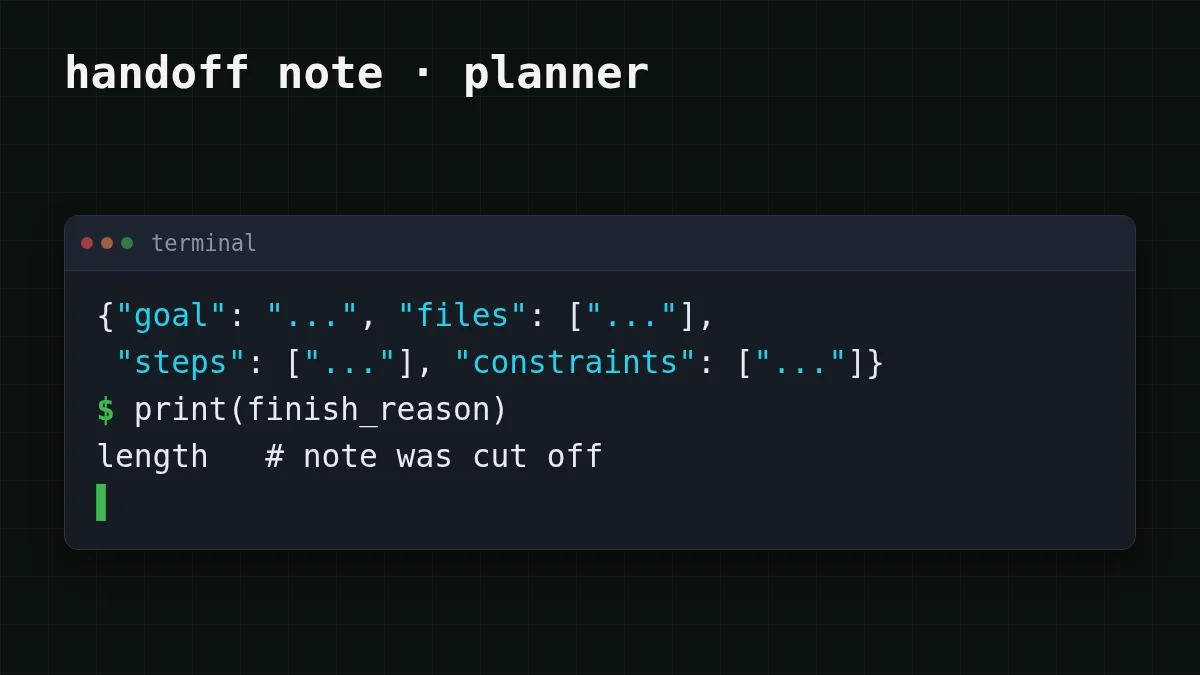
O planejador não precisa escrever um texto longo para o programador. Peça campos: objetivo, arquivos, passos, restrições. Digamos que uma nota curta de oito passos de uma linha leve cerca de 400 tokens em vez de 1.500 (uma suposição: coloque o seu próprio número a partir de usage), e cada agente posterior lê essa nota menor. Limite a resposta com max_tokens, definido um pouco acima da nota esperada, para que um modelo prolixo não consiga reintroduzir o texto longo.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Se finish_reason for length, a nota foi cortada pelo limite: aumente max_tokens um pouco ou encurte o schema (como esse erro aparece). O id do modelo e a base URL estão na documentação do CheapTokens.
2. Passe a cada agente apenas o que ele precisa#
Se o revisor verifica o código em relação à tarefa, ele não precisa do plano: a tarefa e o código bastam. Se ele também verifica o código em relação ao plano, mantenha o plano. Remover o plano do contexto dele é uma mudança de uma linha no seu orquestrador:
Comparar
O que o revisor lê
Antes: tudo
Tarefa 1.000 + plano 1.500 + código 3.000 = 5.500 tokens de entrada.
Depois: tarefa e código
Tarefa 1.000 + código 3.000 = 4.000 tokens de entrada.
Com as duas mudanças (e a nota de 400 tokens, que é nossa suposição), a cadeia do exemplo fica: planejador 1.000 de entrada e 400 de saída, programador 1.000 + 400 = 1.400 de entrada e 3.000 de saída, revisor 1.000 + 3.000 = 4.000 de entrada e 800 de saída. Isso dá 1.000 + 1.400 + 4.000 = 6.400 tokens de entrada e 400 + 3.000 + 800 = 4.200 de saída, contra 9.000 e 5.300 antes. As mesmas 100 tarefas por dia:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 100 solicitações | OpenRouter, 100 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6.400 tokens de entrada e 4.200 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Para uma tarefa no MiniMax-M2.7 a cadeia enxuta fica em $0.00095, abaixo de $0.0012.
3. Dê um modelo barato a papéis curtos#
O planejador escreve respostas curtas, então comece por aí: experimente o GLM-5.3-Flash (contexto de 390K, até 8.192 tokens de saída por resposta) e compare o resultado em 10–20 das suas próprias tarefas. O programador escreve as respostas mais longas: o DeepSeek-V4-Flash permite até 32.768 tokens de saída por resposta. Como todo modelo fica em um único saldo com um único preço a qualquer hora, misturá-los em uma cadeia exige apenas uma string model diferente por agente. Os preços atuais de ambos estão na tabela de preços e na página do DeepSeek.
Por que não passar apenas o KV cache?#
O artigo SwaT (arXiv:2610.15095), enviado em 10 de outubro de 2026 por Alabdulkareem, Tenison, Zhang, Zhu, Katz e Gutfreund, propõe exatamente isso: agentes passam uns aos outros o estado do KV-cache em vez de texto, para que o receptor pule a leitura do texto novamente. Segundo a página do resumo (lida em 31 de outubro de 2026), os autores relatam 40% mais acurácia média (com compactação do KV-cache) do que a comunicação texto-a-texto e tempo de parede médio 4x mais rápido em 17 benchmarks, 12 LLMs e 6 famílias de modelos. Os 40% são acurácia, não economia de tokens ou de preço.
Um método de pesquisa como esse precisa de acesso ao cache interno do modelo. Uma requisição de chat-completions recebe texto e devolve texto, então com uma API sua alavanca é o texto: as três mudanças acima.
Antes de escalar para centenas de execuções#
Lista de verificação
Checklist de handoff
Para o panorama maior dos orçamentos de agentes, veja como estimar o custo de um agente de IA e por que agentes usam tantos tokens.


