成本优化指南
多智能体交接成本:3 智能体链在 token 上的消耗
了解为什么链中的每个智能体都会重新读取此前所有交接内容、这在 token 上要花多少,以及三种缩小输入的改动。
本页内容
你的三个智能体完成了任务,但账单比任务本身看起来要贵得多。原因很简单:在文本交接模式下,每个智能体都要付费读取此前所有智能体写下的全部内容。一份 1,500 token 的计划,规划者写它时付一次费,编码者读它时再付一次,审查者读它时又付一次。精简交接内容,只把每个智能体需要的东西交给它,后续每个智能体的输入就会变小。
下面:一个完整的 3 智能体示例及其 token 计算、按实时价格估算每天 100 个任务的成本,以及你今天就能做的三项改动。Chat-completions API 是无状态的,所以每个请求都会再次携带完整上下文(为什么长对话更贵和消息数组如何工作涵盖了基础知识)。
token 在哪里堆积#
假设你运行一个规划者、一个编码者和一个审查者。任务加指令是 1,000 token。规划者写出一份 1,500 token 的计划,编码者写出 3,000 token 的代码和注释,审查者写出 800 token 的结论。这些是示例用的整数,不是实测值;请用你自己从 usage 字段得到的数字替换(如何读取它)。
猜数字
审查者作为输入读取多少 token?
你的猜测
08,000
显示答案
答案: 5,500
5,500:任务(1,000)、计划(1,500)和代码(3,000)都会出现在它的请求中。
每个智能体的输入是任务加上它收到的每一次交接:
向右滚动表格 →
| 智能体 | 读取(输入) | 写入(输出) |
|---|---|---|
| 规划者 | 1,000(任务) | 1,500 |
| 编码者 | 1,000 + 1,500 = 2,500 | 3,000 |
| 审查者 | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| 整条链 | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
整条链读取 9,000 token 来产出 5,300。再加第四个智能体,它就要读取任务加上全部三次交接,所以输入会随每一跳增长,而不只是多一次交接。
每天 100 个任务要花多少#
交接 token 在智能体写出它时作为输出计费一次,然后被每个后续读取它的智能体作为输入计费。输出 token 的定价高于输入 token,所以在这个示例中,尽管整条链读取的比写入的多,答案仍占账单的更大份额(输入与输出 token)。
一个任务是 9,000 token 输入、5,300 token 输出。在 MiniMax-M2.7 上,每个任务是 $0.0012。每天 100 个任务,以下是我们各模型的实时价格,旁边是 OpenRouter:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 100 次请求 | OpenRouter,100 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
每次请求 9,000 个输入 token 和 5,300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
总计,把输入和输出加在一起,对于这条链,上述 CheapTokens 模型比 OpenRouter 更便宜。
想为你自己的链计算?把一个智能体的平均请求放进计算器:大约 3,000 token 输入、1,800 token 输出,重复 300 次,就是三个智能体的 100 个任务。
成本计算器
每天 100 个任务,每个任务三个智能体
每次请求的输入 token 数: 3,000 · 每次请求的输出 token 数: 1,800 · 每日请求数: 300
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
三种缩小账单的方法#
1. 把交接做成简短的结构化笔记#
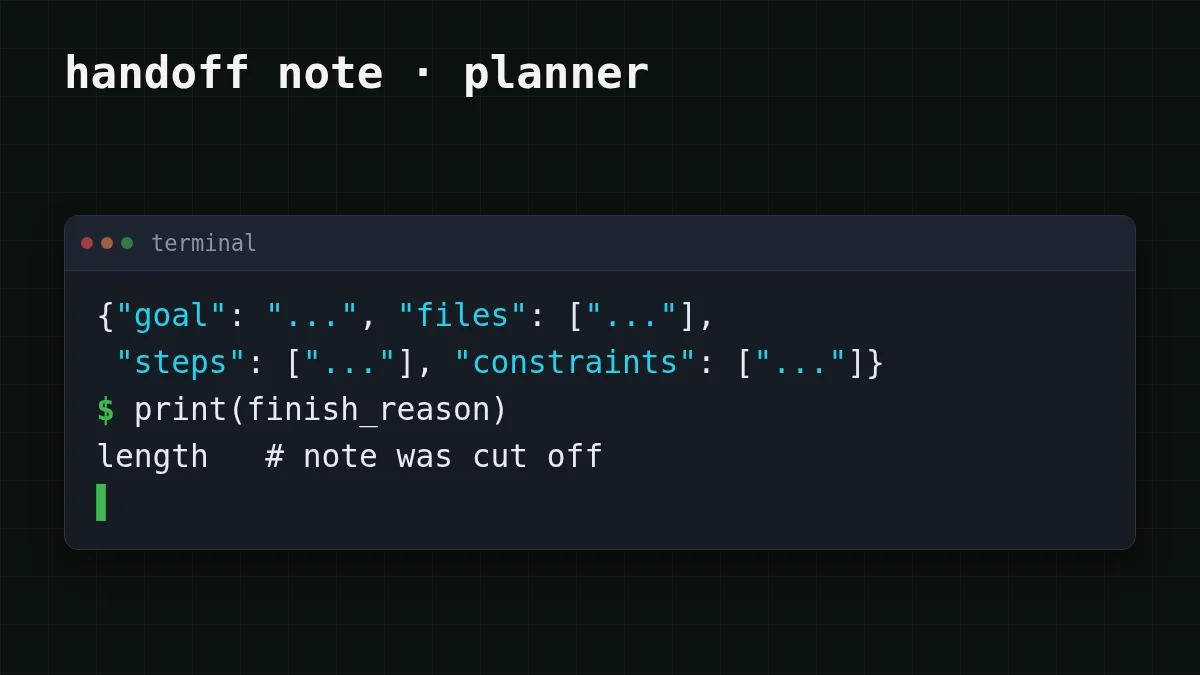
规划者不需要为编码者写一篇长文。要求它填写字段:目标、文件、步骤、约束。假设一份包含八个单行步骤的简短笔记大约 400 token,而不是 1,500(这是一个假设:请用你自己从 usage 得到的数字),后续每个智能体读取的都是这份更小的笔记。用 max_tokens 限制回答长度,设置得略高于预期笔记长度,这样啰嗦的模型就无法把长文偷偷塞回来。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
如果 finish_reason 是 length,说明笔记被上限截断了:稍微调高 max_tokens 或缩短 schema(该错误的样子)。模型 id 和 base URL 在 CheapTokens 文档中。
2. 只把每个智能体需要的东西交给它#
如果审查者对照任务检查代码,它不需要计划:任务和代码就够了。如果它还要对照计划检查代码,那就保留计划。把计划从它的上下文中去掉,在你的编排器里只需改一行:
比较
审查者读取的内容
之前:所有内容
任务 1,000 + 计划 1,500 + 代码 3,000 = 5,500 token 输入。
之后:任务和代码
任务 1,000 + 代码 3,000 = 4,000 token 输入。
两项改动都做(再加上 400 token 的笔记,这是我们的假设),示例链变成:规划者 1,000 输入、400 输出,编码者 1,000 + 400 = 1,400 输入、3,000 输出,审查者 1,000 + 3,000 = 4,000 输入、800 输出。也就是 1,000 + 1,400 + 4,000 = 6,400 token 输入,400 + 3,000 + 800 = 4,200 token 输出,而之前是 9,000 和 5,300。同样是每天 100 个任务:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 100 次请求 | OpenRouter,100 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
每次请求 6,400 个输入 token 和 4,200 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
在 MiniMax-M2.7 上,一个任务经过精简后的链是 $0.00095,低于之前的 $0.0012。
3. 给短角色配便宜模型#
规划者写的是短回答,所以从它开始:试试 GLM-5.3-Flash(390K 上下文,每次回答最多 8,192 输出 token),并在你自己的 10–20 个任务上比较结果。编码者写最长的回答:DeepSeek-V4-Flash 每次回答最多允许 32,768 输出 token。由于所有模型共用一个余额、任何时段都是同一价格,在一条链中混用它们,只需为每个智能体设置不同的 model 字符串。两者的当前价格见价格表和 DeepSeek 页面。
为什么不直接传 KV 缓存?#
论文 SwaT (arXiv:2610.15095) 由 Alabdulkareem、Tenison、Zhang、Zhu、Katz 和 Gutfreund 于 2026 年 10 月 10 日提交,提出的正是这个思路:智能体之间传递 KV 缓存状态而不是文本,这样接收方就无需再次读取文本。根据摘要页面(2026 年 10 月 31 日读取),作者报告在 17 个基准、12 个 LLM 和 6 个模型家族上,平均准确率比文本到文本通信高 40%(配合 KV 缓存压缩),平均实际耗时快 4 倍。这 40% 是准确率,不是 token 或价格的节省。
这样的研究方法需要访问模型的内部缓存。chat-completions 请求输入文本、输出文本,所以在 API 场景下,你的杠杆就是文本:也就是上面三项改动。
在扩展到数百次运行之前#
清单
交接检查清单
关于智能体预算的更大图景,见如何估算 AI 智能体的成本和为什么智能体使用这么多 token。


