模型与对比对比
GPT-6.1 Terra vs Sol vs Luna 用于编码:每任务成本
编码用 Terra、Sol 还是 Luna?一个任务在三个 OpenAI 档位上的定价,一种选择从哪里开始的方法,以及什么时候更便宜的模型就够了。
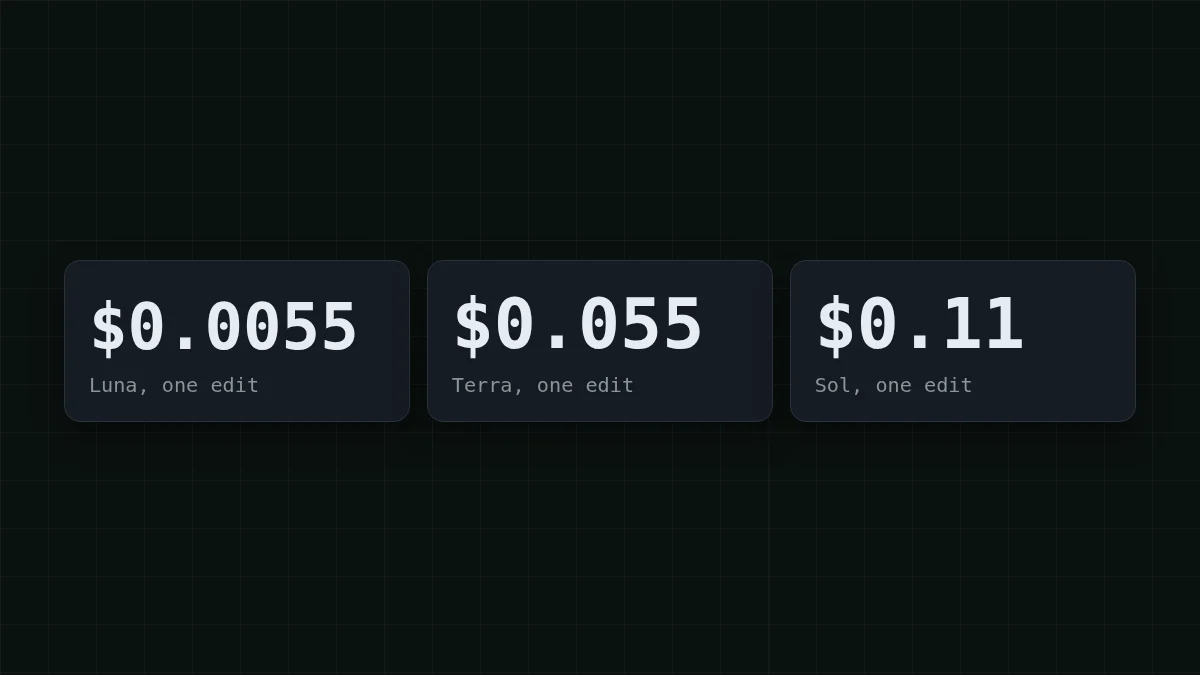
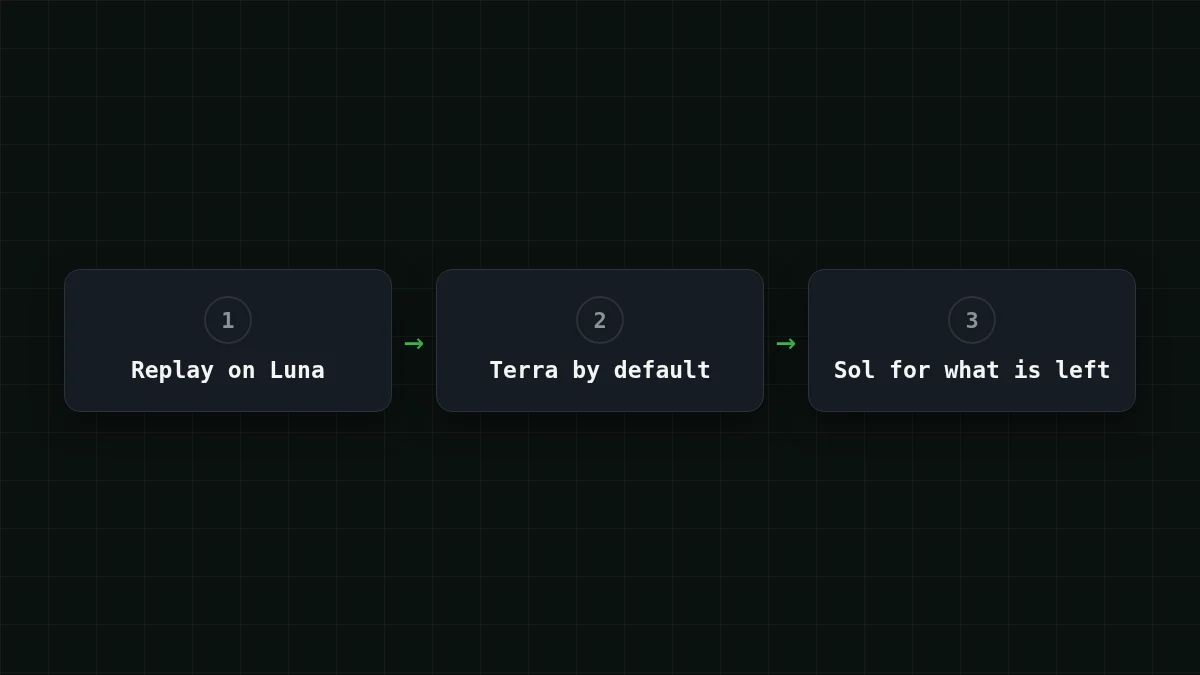
你的 agent 会话结束了,diff 看起来没问题,现在你想知道最贵的那一档是否必要。简短回答:从 Terra 开始,把批量简单步骤交给 Luna,只为 Terra 已经失败的任务付费使用 Sol。在一次相同的编辑中(输入 40,000 tokens,输出 3,000),OpenAI 标准价格下 Luna 为 $0.0055,Terra 为 $0.055,Sol 为 $0.11。
价格表怎么说#
OpenAI 的定价页面(2026 年 10 月 29 日查看,标准档,输入最多 272K tokens)列出了每 1M tokens 的以下价格:
向右滚动表格 →
| 档位 | 输入 | 缓存输入 | 输出 | 一次编辑:输入 40K,输出 3K |
|---|---|---|---|---|
GPT-6 Luna (gpt-6-luna) |
$0.10 | $0.01 | $0.50 | $0.0055 |
GPT-6.1 Terra (gpt-6.1-terra) |
$1.00 | $0.05 | $5.00 | $0.055 |
GPT-6.1 Sol (gpt-6.1-sol) |
$2.00 | $0.10 | $10.00 | $0.11 |
规律很整齐。Sol 在每一列上正好是 Terra 的两倍。Luna 的输入和输出是 Terra 的十分之一,缓存输入是五分之一。所以成本阶梯是固定的,真正的问题在于更便宜的一档有多经常能完成任务。
最后一列是简单的算术。Terra 上:40,000 × 1.00 / 1,000,000 = 0.04 的输入,3,000 × 5.00 / 1,000,000 = 0.015 的输出,所以 0.04 + 0.015 = 0.055。Sol 上同样的和是 0.08 + 0.03 = 0.11,Luna 上是 0.004 + 0.0015 = 0.0055。
一次编辑,然后五十次#
假设你每天做 50 次这样的编辑:重写一个函数,修复它破坏的测试,大约 40,000 tokens 的文件和指令输入,3,000 tokens 的补丁和解释输出。那么一天在 Terra 上花费 50 × 0.055 = 2.75 美元,Sol 上 50 × 0.11 = 5.50,Luna 上 50 × 0.0055 = 0.275。
没人会在意一次编辑的 $0.11。按这个节奏用 Sol 一个月就是另一回事了,这也是为什么应该按任务类型而不是按心情来决定档位。
下面是整个计算,几行代码,你可以粘贴并用你自己的 token 数重新运行(示例价格来自上表,请替换为当前价格):
PRICES = {  # $ per 1M tokens: (input, output), OpenAI, 29 Oct 2026
    'luna': (0.10, 0.50),
    'terra': (1.00, 5.00),
    'sol': (2.00, 10.00),
}

def cost(tier, tokens_in, tokens_out):
    p_in, p_out = PRICES[tier]
    return (tokens_in * p_in + tokens_out * p_out) / 1_000_000

print(cost('terra', 40_000, 3_000))  # 0.055
Agent 循环:输入就是账单#
一次编辑是一个请求。一个 agent 是连续二十个请求,每一步都会重新读取文件和到目前为止的历史。假设一个 20 步的循环,每一步发送约 30,000 tokens 并得到约 1,000 返回。那就是 600,000 tokens 输入和 20,000 输出。
Terra 上:600,000 × 1.00 / 1,000,000 = 0.60 的输入,20,000 × 5.00 / 1,000,000 = 0.10 的输出,所以 0.60 + 0.10 = 0.70 美元。Sol 翻倍到 1.40,Luna 降到 0.07。看看这个拆分:$0.70 中的 $0.60 是你发送的,而不是模型写出的。这与大多数人对账单的想象正好相反。
如果你的前缀确实重复,缓存会改变情况。假设每一步 30,000 tokens 中有 25,000 是相同的前缀并命中缓存:100,000 × 1.00 / 1,000,000 = 0.10 的新鲜输入,500,000 × 0.05 / 1,000,000 = 0.025 的缓存输入,加上 0.10 的输出,所以 Terra 落在 0.10 + 0.025 + 0.10 = 0.225。其工作原理见什么是提示缓存;历史为什么不断增长见为什么 AI agent 使用这么多 tokens。
下面的计算器在 CheapTokens 模型上运行同样的循环。修改步数和 tokens 以匹配你的 agent。
成本计算器
在 CheapTokens 模型上同样的 20 步循环
每次请求的输入 token 数: 30,000 · 每次请求的输出 token 数: 1,000 · 每日请求数: 20
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0128 | $0.384 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.011 | $0.33 |
| MiniMax-M2.7$0.05$0.15 | $0.033 | $0.99 |
哪个任务用哪个档位#
一位做 AI 实验的 Telegram 频道作者在 Codex 中比较了 Terra 与 Sol 和 Luna,并于 2026 年 10 月 28 日发布了一个视频。他的结论,用他自己的标题来说,就是 Terra 是一个中间档,而这并不是缺点(帖子)。这个框架是一个有用的指引:中间档是默认,另外两个需要理由。
理由通常是重试。在相同 token 数下,两次 Terra 尝试花费 2 × 0.055 = 0.11,等于一次 Sol 尝试。而十次 Luna 尝试花费 10 × 0.0055 = 0.055,等于一次 Terra 尝试。所以如果 Sol 是唯一能一次搞定某类任务的档位,它就在那些任务上为自己买单。如果 Luna 能在十次中超过一次搞定某类任务,它就是更便宜的获取方式,这还没算上审查失败所花的时间。
选择最接近你的情况:
选择你的情况
你从哪个档位开始?
选择一个选项以查看答案
数千个小步骤
提交信息、分类工单、简短代码解释。从 Luna 开始:每步成本是 Terra 的十分之一,所以只要失败率不是极端高,仍然更便宜。只为持续失败的步骤类型升级。
日常编辑和重构
从 Terra 开始并保持在那里。它是价格表的中间档,一次 40K 输入和 3K 输出的编辑花费 $0.055。只有在同类任务在 Terra 上失败两次后才考虑 Sol。
Terra 已经失败的任务
用相同的提示尝试一次 Sol。在相同 tokens 下,这花费与第二次 Terra 尝试相同,而且你能了解额外档位是否是任务所需要的。
长 agent 循环
账单主要由输入主导,所以首先削减每一步重发的内容,并保持前缀稳定以便缓存。之后再选择档位,而不是之前。
什么时候更便宜的开源权重模型就够了#
同样的编辑在三个 OpenAI 档位与三个 CheapTokens 模型上的对比,同样是 40,000 tokens 输入和 3,000 输出:
柱状图显示的是价格,不是结果。这些模型中是否有一个对你的编辑足够好,你要用与 Luna 相同的方式检查:重放真实任务并阅读 diff。如果通过,账单会进一步下降。对于 agent 循环,DeepSeek-V4-Flash 有 380K 上下文,回答中最多 32,768 tokens,且一天中任何时段价格相同。GLM-5.3-Flash 有 390K 上下文,MiniMax-M2.7 有 180K;所有价格都在定价页面上,连接步骤在文档中。
重放你自己的任务#
表格给你成本。质量你可以在一个下午弄清楚:从你最近的历史中取十个任务,每个先在 Luna 上运行,然后在 Terra 上运行,把 diff 并排比较。你唯一需要的数字在响应中的 usage 字段里,这使得精确计算一次运行的成本变得容易。在 CheapTokens 上看起来像这样:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Rename the variable x to retry_count in this function: ..."}]}'
在返回的 JSON 中,usage. 和 usage. 是该任务的输入和输出。把它们输入上面的 cost() 辅助函数,你就得到了任何有价格的模型的每任务成本。关于新档位的发布细节,见 GPT-6.1 Terra API 价格;关于输入/输出拆分,见输入 vs 输出 tokens。
快速检查
你在 Terra 和 Sol 上以相同的 token 数运行同一个任务。仅凭价格表能告诉你什么?
显示答案
答案: Sol 的成本正好是两倍,因为它那一行的每个价格都是 Terra 的两倍
输入、缓存输入和输出在 Sol 上各是 2 倍,所以无论混合比例如何,账单都是 2 倍。额外的钱是否买到更好的结果,只有你的重放能显示。


