تحسين التكلفةدليل
تكلفة تسليم الوكلاء المتعددين: ما تستخدمه سلسلة من 3 وكلاء بالرموز
اكتشف لماذا يعيد كل وكيل في السلسلة قراءة كل التسليمات السابقة، وما تكلفة ذلك بالرموز، وثلاثة تغييرات تقلص الإدخال.
في هذه الصفحة
وكلاؤك الثلاثة أنهوا المهمة، والفاتورة أكبر مما تبدو المهمة. السبب بسيط: مع تسليم النص، يدفع كل وكيل مقابل قراءة كل ما كتبه الوكلاء السابقون. خطة من 1,500 رمز تُدفع مرة واحدة عندما يكتبها المخطط، ثم مرة أخرى بواسطة المبرمج، ثم مرة أخرى بواسطة المراجع. قلّص التسليم، وسلّم كل وكيل فقط ما يحتاجه، وسيصغر إدخال كل وكيل لاحق.
أدناه: مثال عملي لثلاثة وكلاء مع حساب الرموز، وتقدير تكلفة لـ 100 مهمة يوميًا بأسعار حية، وثلاثة تغييرات يمكنك إجراؤها اليوم. واجهات API لإكمال المحادثة عديمة الحالة، لذا يحمل كل طلب سياقه الكامل مرة أخرى (لماذا تكلف محادثة طويلة أكثر وكيف يعمل مصفوفة الرسائل يغطيان الأساسيات).
أين تتراكم الرموز#
لنفترض أنك تشغّل مخططًا ومبرمجًا ومراجعًا. المهمة مع التعليمات 1,000 رمز. يكتب المخطط خطة من 1,500 رمز، ويكتب المبرمج 3,000 رمز من الكود والملاحظات، ويكتب المراجع حكمًا من 800 رمز. هذه أرقام تقريبية للمثال، وليست قياسًا؛ استبدلها بأرقامك من حقل usage (كيف تقرأه).
خمّن الرقم
كم عدد الرموز التي يقرأها المراجع كإدخال؟
تخمينك
08,000
إظهار الإجابة
الإجابة: 5,500
5,500: المهمة (1,000)، والخطة (1,500)، والكود (3,000) كلها تصل في طلبه.
إدخال كل وكيل هو المهمة زائد كل تسليم يستقبله:
قم بتمرير الجدول لليمين →
| الوكيل | يقرأ (إدخال) | يكتب (إخراج) |
|---|---|---|
| المخطط | 1,000 (مهمة) | 1,500 |
| المبرمج | 1,000 + 1,500 = 2,500 | 3,000 |
| المراجع | 1,000 + 1,500 + 3,000 = 5,500 | 800 |
| السلسلة كاملة | 1,000 + 2,500 + 5,500 = 9,000 | 1,500 + 3,000 + 800 = 5,300 |
تقرأ السلسلة 9,000 رمز لإنتاج 5,300. أضف وكيلًا رابعًا وسيقرأ المهمة زائد التسليمات الثلاثة كلها، لذا ينمو الإدخال مع كل خطوة، وليس بمقدار تسليم واحد فقط.
تكلفة 100 مهمة يوميًا#
يُفوتر رمز التسليم مرة واحدة كإخراج، عندما يكتبه الوكيل، ثم كإدخال لكل وكيل لاحق يقرأه. رموز الإخراج مسعّرة أعلى من رموز الإدخال، لذا في هذا المثال تشكل الإجابات الحصة الأكبر من الفاتورة رغم أن السلسلة تقرأ أكثر مما تكتب (رموز الإدخال مقابل الإخراج).
المهمة الواحدة 9,000 رمز إدخال و5,300 إخراج. على MiniMax-M2.7 هذا $0.0012 لكل مهمة. لـ 100 مهمة يوميًا، هذه هي الأسعار الحية عبر نماذجنا، بجانب OpenRouter:
| النموذج | الإدخال $/1M | الإخراج $/1M | لكل طلب | 100 طلبات | OpenRouter، 100 طلبات |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9,000 رمز إدخال و5,300 رمز إخراج لكل طلب. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
إجمالًا، مع احتساب الإدخال والإخراج معًا، تخرج نماذج CheapTokens أعلاه أرخص من OpenRouter لهذه السلسلة.
تريد الحساب لسلسلتك الخاصة؟ ضع متوسط طلب وكيل واحد في الحاسبة: حوالي 3,000 رمز إدخال و1,800 إخراج، مكررًا 300 مرة، هو 100 مهمة لثلاثة وكلاء.
حاسبة التكلفة
100 مهمة يوميًا، ثلاثة وكلاء لكل منها
رموز الإدخال لكل طلب: 3,000 · رموز الإخراج لكل طلب: 1,800 · الطلبات يوميًا: 300
| النموذج | يوميًا | شهريًا |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
ثلاث طرق لتقليص الفاتورة#
1. اجعل التسليم ملاحظة قصيرة منظمة#
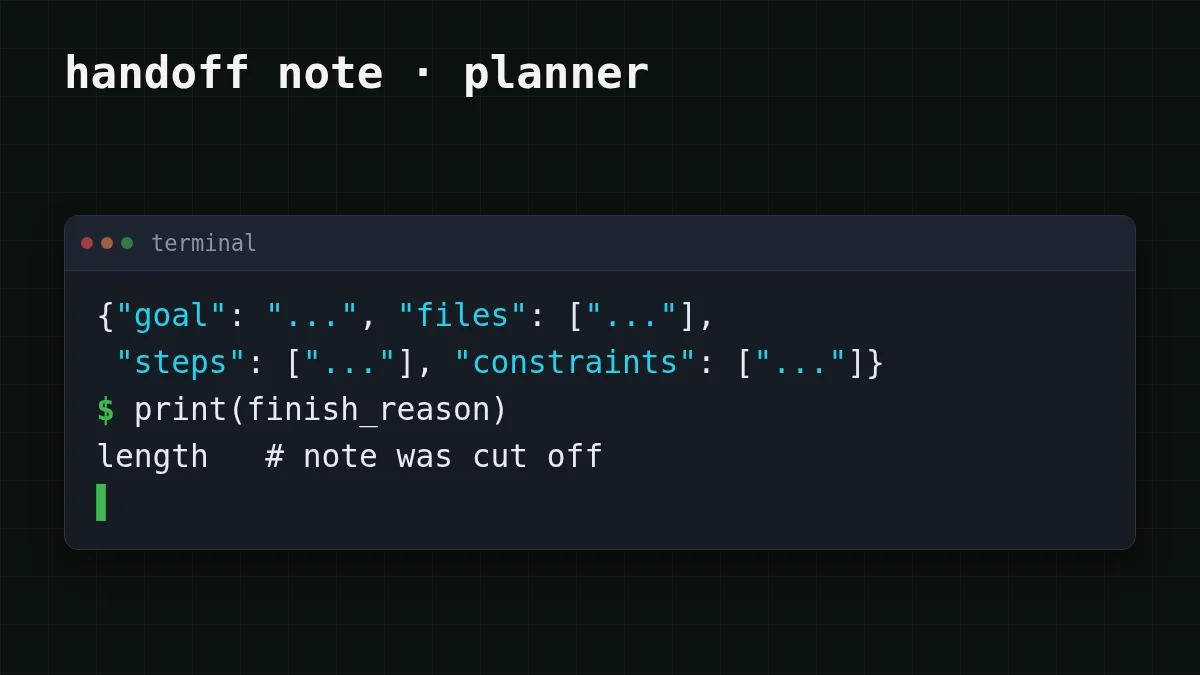
لا يحتاج المخطط لكتابة مقال للمبرمج. اطلب حقولًا: الهدف، الملفات، الخطوات، القيود. لنفترض أن ملاحظة قصيرة من ثماني خطوات بسطر واحد تستغرق حوالي 400 رمز بدلًا من 1,500 (افتراض: ضع رقمك من usage)، وكل وكيل لاحق يقرأ تلك الملاحظة الأصغر. حدّد الإجابة بـ max_tokens، مضبوطًا أعلى قليلًا من الملاحظة المتوقعة، حتى لا يتمكن نموذج ثرثار من إعادة إدخال المقال خلسة.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
إذا كان finish_reason هو length، فقد قُطعت الملاحظة بواسطة الحد: ارفع max_tokens قليلًا أو قصّر المخطط (كيف يبدو ذلك الخطأ). معرّف النموذج وعنوان URL الأساسي في وثائق CheapTokens.
2. مرّر لكل وكيل فقط ما يحتاجه#
إذا كان المراجع يفحص الكود مقابل المهمة، فهو لا يحتاج الخطة: المهمة والكود كافيان. إذا كان يفحص الكود مقابل الخطة أيضًا، فاحتفظ بالخطة. إزالة الخطة من سياقه تغيير بسطر واحد في المنسّق:
قارن
ما يقرأه المراجع
قبل: كل شيء
المهمة 1,000 + الخطة 1,500 + الكود 3,000 = 5,500 رمز إدخال.
بعد: المهمة والكود
المهمة 1,000 + الكود 3,000 = 4,000 رمز إدخال.
مع كلا التغييرين (وملاحظة الـ 400 رمز، وهي افتراضنا)، تصبح سلسلة المثال: المخطط 1,000 إدخال و400 إخراج، المبرمج 1,000 + 400 = 1,400 إدخال و3,000 إخراج، المراجع 1,000 + 3,000 = 4,000 إدخال و800 إخراج. أي 1,000 + 1,400 + 4,000 = 6,400 رمز إدخال و400 + 3,000 + 800 = 4,200 إخراج، مقابل 9,000 و5,300 سابقًا. نفس 100 مهمة يوميًا:
| النموذج | الإدخال $/1M | الإخراج $/1M | لكل طلب | 100 طلبات | OpenRouter، 100 طلبات |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6,400 رمز إدخال و4,200 رمز إخراج لكل طلب. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
لمهمة واحدة على MiniMax-M2.7، السلسلة المقلّصة هي $0.00095، انخفاضًا من $0.0012.
3. أعطِ الأدوار القصيرة نموذجًا رخيصًا#
يكتب المخطط إجابات قصيرة، لذا ابدأ هناك: جرّب GLM-5.3-Flash (سياق 390K، حتى 8,192 رمز إخراج لكل إجابة) وقارن النتيجة على 10–20 من مهامك. يكتب المبرمج أطول الإجابات: يسمح DeepSeek-V4-Flash بما يصل إلى 32,768 رمز إخراج لكل إجابة. بما أن كل نموذج يقع على رصيد واحد بسعر واحد في أي ساعة، فإن خلطها في سلسلة واحدة يحتاج فقط إلى سلسلة model مختلفة لكل وكيل. الأسعار الحالية لكليهما في جدول الأسعار وعلى صفحة DeepSeek.
لماذا لا نمرر ذاكرة KV المؤقتة فقط؟#
الورقة البحثية SwaT (arXiv:2610.15095)، المقدمة في 10 أكتوبر 2026 من قبل Alabdulkareem وTenison وZhang وZhu وKatz وGutfreund، تقترح ذلك بالضبط: يسلّم الوكلاء بعضهم البعض حالة ذاكرة KV المؤقتة بدلًا من النص، فيتخطى المستقبل إعادة قراءة النص. وفقًا لصفحة الملخص (قُرئت في 31 أكتوبر 2026)، يذكر المؤلفون دقة متوسطة أعلى بنسبة 40% (مع ضغط ذاكرة KV المؤقتة) من التواصل نصًا إلى نص، ووقت حائط متوسط أسرع 4 مرات عبر 17 معيارًا و12 نموذجًا لغويًا كبيرًا و6 عائلات نماذج. الـ 40% هي دقة، وليست توفيرًا في الرموز أو السعر.
طريقة بحثية كهذه تحتاج إلى الوصول إلى الذاكرة المؤقتة الداخلية للنموذج. طلب إكمال المحادثة يأخذ نصًا ويعطي نصًا، لذا مع API فإن رافعتك هي النص: التغييرات الثلاثة أعلاه.
قبل أن تتوسع إلى مئات التشغيلات#
قائمة التحقق
قائمة التحقق من التسليم
للصورة الأكبر لميزانيات الوكلاء، راجع كيف تقدّر تكلفة وكيل ذكاء اصطناعي ولماذا تستخدم الوكلاء رموزًا كثيرة.


