Tối ưu chi phíHướng dẫn
Chi phí bàn giao đa agent: một chuỗi 3 agent dùng bao nhiêu token
Xem vì sao mỗi agent trong chuỗi đọc lại mọi bàn giao trước đó, điều đó tốn bao nhiêu token, và ba thay đổi giúp thu nhỏ đầu vào.
Trên trang này
Ba agent của bạn đã hoàn thành công việc, và hóa đơn lớn hơn vẻ ngoài của công việc. Lý do rất đơn giản: với bàn giao dạng văn bản, mỗi agent phải trả tiền để đọc mọi thứ mà các agent trước đã viết. Một kế hoạch 1.500 token được trả một lần khi planner viết nó, rồi lại được coder trả, rồi lại được reviewer trả. Cắt gọn bàn giao, chỉ đưa cho mỗi agent những gì nó cần, và đầu vào của mọi agent sau sẽ nhỏ đi.
Dưới đây: một ví dụ 3 agent kèm phép tính token, ước tính chi phí cho 100 tác vụ mỗi ngày theo giá hiện hành, và ba thay đổi bạn có thể làm ngay hôm nay. API chat-completions là stateless, nên mỗi yêu cầu mang lại toàn bộ ngữ cảnh của nó (vì sao một cuộc trò chuyện dài tốn hơn và cách mảng messages hoạt động bao quát những điều cơ bản).
Token tích tụ ở đâu#
Giả sử bạn chạy một planner, một coder và một reviewer. Tác vụ cộng hướng dẫn là 1.000 token. Planner viết một kế hoạch 1.500 token, coder viết 3.000 token mã và ghi chú, reviewer viết một phán quyết 800 token. Đây là những con số tròn cho ví dụ, không phải đo lường; hãy thay bằng số của bạn từ trường usage (cách đọc nó).
Đoán số
Reviewer đọc bao nhiêu token làm đầu vào?
Dự đoán của bạn
08.000
Hiện đáp án
Trả lời: 5.500
5.500: tác vụ (1.000), kế hoạch (1.500) và mã (3.000) đều đến trong yêu cầu của nó.
Đầu vào của mỗi agent là tác vụ cộng mọi bàn giao mà nó nhận:
Cuộn bảng sang phải →
| Agent | Đọc (đầu vào) | Viết (đầu ra) |
|---|---|---|
| Planner | 1.000 (tác vụ) | 1.500 |
| Coder | 1.000 + 1.500 = 2.500 | 3.000 |
| Reviewer | 1.000 + 1.500 + 3.000 = 5.500 | 800 |
| Toàn chuỗi | 1.000 + 2.500 + 5.500 = 9.000 | 1.500 + 3.000 + 800 = 5.300 |
Chuỗi đọc 9.000 token để tạo ra 5.300. Thêm một agent thứ tư và nó sẽ đọc tác vụ cộng cả ba bàn giao, vậy đầu vào tăng theo mỗi bước nhảy, không chỉ một bàn giao.
100 tác vụ mỗi ngày tốn bao nhiêu#
Một token bàn giao được tính một lần là đầu ra, khi agent viết nó, rồi là đầu vào cho mỗi agent sau đọc nó. Token đầu ra có giá cao hơn token đầu vào, nên trong ví dụ này các câu trả lời chiếm phần lớn hơn trong hóa đơn dù chuỗi đọc nhiều hơn viết (token đầu vào so với đầu ra).
Một tác vụ là 9.000 token vào và 5.300 ra. Trên MiniMax-M2.7 đó là $0.0012 mỗi tác vụ. Cho 100 tác vụ mỗi ngày, đây là giá hiện hành trên các mô hình của chúng tôi, bên cạnh OpenRouter:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 100 yêu cầu | OpenRouter, 100 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00039 | $0.0392 | $0.0773 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00067 | $0.0665 | $0.126 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.125 | $0.906 |
9.000 token đầu vào và 5.300 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Tổng cộng, tính cả đầu vào và đầu ra, các mô hình CheapTokens ở trên rẻ hơn OpenRouter cho chuỗi này.
Muốn tính cho chuỗi của riêng bạn? Đưa yêu cầu trung bình của một agent vào máy tính: khoảng 3.000 token vào và 1.800 ra, lặp lại 300 lần, là 100 tác vụ của ba agent.
Máy tính chi phí
100 tác vụ mỗi ngày, mỗi tác vụ ba agent
Token đầu vào mỗi yêu cầu: 3.000 · Token đầu ra mỗi yêu cầu: 1.800 · Số yêu cầu mỗi ngày: 300
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0396 | $1.19 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0675 | $2.03 |
| MiniMax-M2.7$0.05$0.15 | $0.126 | $3.78 |
Ba cách để giảm hóa đơn#
1. Biến bàn giao thành một ghi chú ngắn có cấu trúc#
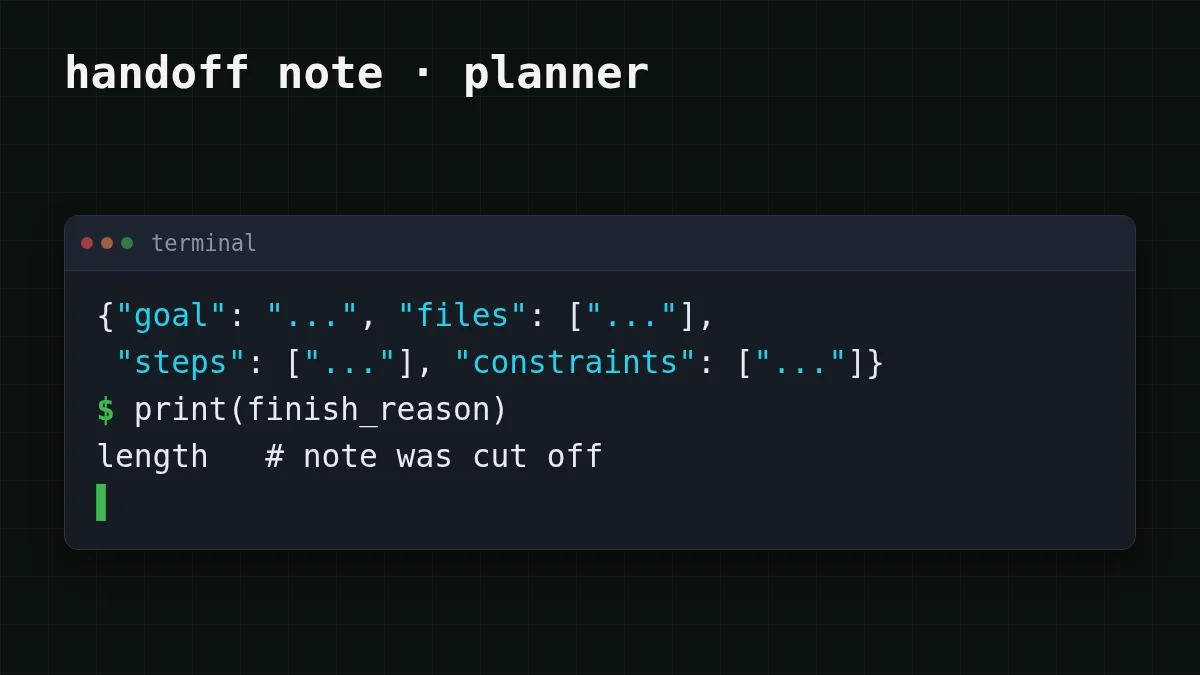
Planner không cần viết một bài luận cho coder. Yêu cầu các trường: mục tiêu, tệp, bước, ràng buộc. Giả sử một ghi chú ngắn gồm tám bước một dòng tốn khoảng 400 token thay vì 1.500 (một giả định: đưa số của bạn từ usage), và mọi agent sau đọc ghi chú nhỏ hơn đó. Giới hạn câu trả lời bằng max_tokens, đặt cao hơn một chút so với ghi chú dự kiến, để một mô hình hay nói nhiều không thể lén đưa bài luận trở lại.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
task = 'Add a --dry-run flag to the export command'

plan = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    max_tokens=500,
    messages=[
        {'role': 'system', 'content': 'Reply with JSON only: {goal, files, steps, constraints}. At most 8 steps, one line each.'},
        {'role': 'user', 'content': task},
    ],
)
note = plan.choices[0].message.content
print(plan.choices[0].finish_reason, plan.usage.completion_tokens)
Nếu finish_reason là length, ghi chú đã bị cắt bởi giới hạn: tăng max_tokens một chút hoặc rút gọn schema (lỗi đó trông thế nào). Model id và base URL có trong tài liệu CheapTokens.
2. Chỉ đưa cho mỗi agent những gì nó cần#
Nếu reviewer kiểm tra mã so với tác vụ, nó không cần kế hoạch: tác vụ và mã là đủ. Nếu nó cũng kiểm tra mã so với kế hoạch, hãy giữ kế hoạch. Cắt kế hoạch khỏi ngữ cảnh của nó là một thay đổi một dòng trong orchestrator của bạn:
So sánh
Reviewer đọc gì
Trước: mọi thứ
Tác vụ 1.000 + kế hoạch 1.500 + mã 3.000 = 5.500 token vào.
Sau: tác vụ và mã
Tác vụ 1.000 + mã 3.000 = 4.000 token vào.
Với cả hai thay đổi (và ghi chú 400 token, là giả định của chúng tôi), chuỗi ví dụ trở thành planner 1.000 vào và 400 ra, coder 1.000 + 400 = 1.400 vào và 3.000 ra, reviewer 1.000 + 3.000 = 4.000 vào và 800 ra. Đó là 1.000 + 1.400 + 4.000 = 6.400 token vào và 400 + 3.000 + 800 = 4.200 ra, so với 9.000 và 5.300 trước đó. Vẫn 100 tác vụ mỗi ngày:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 100 yêu cầu | OpenRouter, 100 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0003 | $0.0296 | $0.0583 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00052 | $0.0516 | $0.0963 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00095 | $0.095 | $0.696 |
6.400 token đầu vào và 4.200 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Cho một tác vụ trên MiniMax-M2.7, chuỗi đã cắt gọn là $0.00095, giảm từ $0.0012.
3. Giao vai trò ngắn cho một mô hình rẻ#
Planner viết câu trả lời ngắn, nên bắt đầu từ đó: thử GLM-5.3-Flash (ngữ cảnh 390K, tối đa 8.192 token đầu ra mỗi câu trả lời) và so sánh kết quả trên 10–20 tác vụ của riêng bạn. Coder viết câu trả lời dài nhất: DeepSeek-V4-Flash cho phép tối đa 32.768 token đầu ra mỗi câu trả lời. Vì mọi mô hình nằm trên một số dư với một mức giá tại bất kỳ giờ nào, trộn chúng trong một chuỗi chỉ cần một chuỗi model khác nhau cho mỗi agent. Giá hiện tại cho cả hai có trong bảng giá và trên trang DeepSeek.
Tại sao không chỉ truyền KV cache?#
Bài báo SwaT (arXiv:2610.15095), gửi ngày 10 tháng 10 năm 2026 bởi Alabdulkareem, Tenison, Zhang, Zhu, Katz và Gutfreund, đề xuất đúng điều đó: các agent bàn giao trạng thái KV-cache cho nhau thay vì văn bản, để bên nhận bỏ qua việc đọc lại văn bản. Theo trang tóm tắt (đọc ngày 31 tháng 10 năm 2026), các tác giả báo cáo độ chính xác trung bình cao hơn 40% (với nén KV-cache) so với giao tiếp văn bản-văn bản và thời gian thực trung bình nhanh hơn 4 lần trên 17 bộ chuẩn, 12 LLM và 6 họ mô hình. Con số 40% là độ chính xác, không phải tiết kiệm token hay giá.
Một phương pháp nghiên cứu như vậy cần truy cập vào cache nội bộ của mô hình. Một yêu cầu chat-completions nhận văn bản vào và cho văn bản ra, nên với API, đòn bẩy của bạn là văn bản: ba thay đổi ở trên.
Trước khi bạn mở rộng lên hàng trăm lần chạy#
Danh sách kiểm tra
Danh sách kiểm tra bàn giao
Để có bức tranh lớn hơn về ngân sách agent, xem cách ước tính chi phí của một AI agent và vì sao agent dùng quá nhiều token.


