モデルと比較比較
2026年の最も安いOpenAI APIモデル:gpt-5-nano vs gpt-6-luna
2026年10月28日に確認した公式価格によるOpenAIの最も安いAPIモデルと、同じ1,000リクエストがオープンウェイトモデルでいくらかかるか。
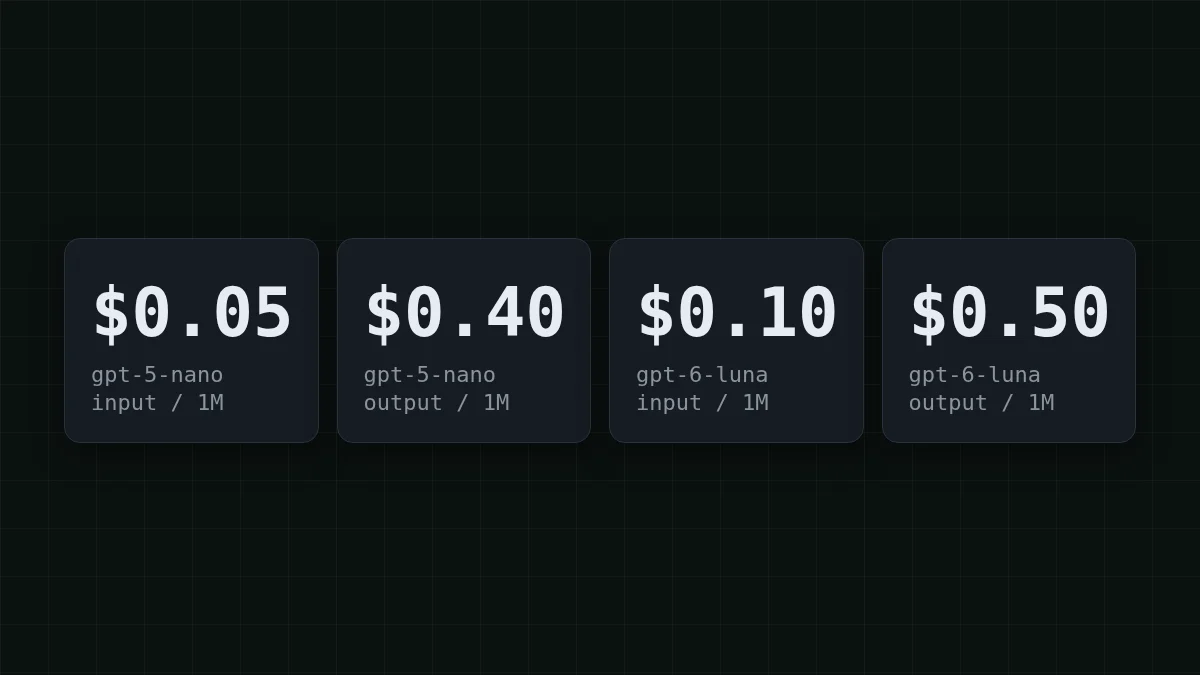
OpenAIの料金ページで最も安いテキストモデルは gpt-5-nano です。入力100万トークンあたり$0.05、出力100万トークンあたり$0.40です。新しいGPT-6ラインの中では、gpt-6-luna が入力$0.10、出力$0.50で最も安くなっています。これらの数値はOpenAIの料金ページから2026年10月28日に確認したものです。ページには公開日が記載されていないため、確認日を信頼してください。
しかし、トークンあたりの低価格はタスクあたりの低価格と同じではありません。小規模で大量のジョブでは、CheapTokens上のオープンウェイトモデル、例えばGLM-5.3-FlashやDeepSeek-V4-Flashの方が総額で安くなります。以下では具体的なジョブでそれを示し、その後ご自身の数値を当てはめてみてください。
下から見るOpenAIの価格ラダー#
すべての価格は100万トークンあたり、標準ティア、短いコンテキスト(最大272K入力トークン)です。最後の列は具体的な1つのジョブの計算です。1,000リクエスト、各500入力トークンと200出力トークン。チケットにタグを付けるサポートボットを想像してください。
テーブルを右にスクロールしてください →
| モデル | 入力 | 出力 | キャッシュ入力 | 1,000リクエスト(500入力 / 200出力) |
|---|---|---|---|---|
| gpt-5-nano | $0.05 | $0.40 | $0.005 | $0.105 |
| gpt-4.1-nano | $0.10 | $0.40 | $0.025 | $0.13 |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.15 |
| gpt-4o-mini | $0.15 | $0.60 | $0.075 | $0.195 |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | $0.34 |
| gpt-5.4-nano | $0.20 | $1.25 | $0.02 | $0.35 |
| gpt-5-mini | $0.25 | $2.00 | $0.025 | $0.525 |
2つの点が目立ちます。第一に、gpt-5-nanoは入力価格が最も低く、出力ではgpt-4.1-nanoと並びます。したがって、OpenAIに留まりタスクが単純なら、これが出発点です。第二に、多くのプロジェクトが安価なモデルとして選んだgpt-4o-miniは、今では入力でも出力でもgpt-5-nanoより高くつきます。もしそれがあなたのモデルなら、OpenAIから離れずにより安い選択肢があります。
表の上にはgpt-4.1-mini($0.40 / $1.60)とgpt-5.4-mini($0.75 / $4.50)があります。比較用の大きなティア:gpt-6.1-terraは$1 / $5(GPT-6.1 Terra API priceで取り上げました)、gpt-6.1-solは$2 / $10、gpt-6-astraは$10 / $50です。同じページからの注意点:リージョナル処理エンドポイントは、2026年3月5日以降にリリースされたモデルに対して10%の割増があります。ページには価格のみが記載されているため、タスクを移行する前に各モデルのページでコンテキストサイズと制限を確認してください。
1,000件の小さなリクエストでお金はどこへ行くか#
チケットタグ付けボットを例に取りましょう。各リクエストは約500トークン(指示とチケット)を送り、約200トークンを受け取ります。gpt-5-nanoでは、1,000件のコストは:
- 入力:0.5Mトークン × $0.05 = $0.025
- 出力:0.2Mトークン × $0.40 = $0.08
- 合計:$0.025 + $0.08 = $0.105
内訳を見てください。短い回答はトークン数の3分の1未満ですが、$0.105のうち$0.08を占めています。これが安価なモデル選びの落とし穴です:出力価格が入力価格よりも頻繁に請求額を決めます。この考え方の詳細はinput vs output tokensで説明しています。
OpenAIはキャッシュ入力レートも記載しています:gpt-5-nanoでは100万トークンあたり$0.005(仕組みはwhat is prompt cachingにあります)。500トークンの入力全体が繰り返しのプロンプトでキャッシュされるとします。入力は0.5M × $0.005 = $0.0025に下がり、ジョブのコストは$0.0025 + $0.08 = $0.0825になります。請求額はほとんど変わりません。200出力トークンは依然として$0.08かかるからです。
同じ計算をより大きなスケールで試してみましょう:
数字を当てる
タガーが1日に200,000リクエストをgpt-5-nanoに送り、各リクエストは500トークン入力、200トークン出力です。これは1日あたり何ドルですか?
あなたの予想
0100
答えを表示
答え: 21
$21。入力:100Mトークン × $0.05 = $5。出力:40Mトークン × $0.40 = $16。合計$5 + $16 = $21。
同じジョブをオープンウェイトモデルで#
次に、同じ1,000リクエスト(500入力、200出力)をCheapTokensの今日のレートで計算します:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
リクエストあたり 500 入力トークンと 200 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
数値で言うと:GLM-5.3-Flashは$0.018、DeepSeek-V4-Flashは$0.0275、MiniMax-M2.7は$0.055です。これをgpt-5-nanoの$0.105と並べてください。表はライブなので、現在の価格リストに従います。GLM-5.3-Flashは390Kコンテキストで最大8,192トークンを回答でき、タグや短い返信には十分です。DeepSeek-V4-Flashは380Kコンテキストで最大32,768トークンを回答でき、出力がレポートや長いコードの場合に重要です。どちらも時間帯に関係なく1つの価格で、ピーク価格はありません。
もう1つのシナリオ、まだgpt-4o-miniを使っているチャットボット。各チャットが約1,200トークン(履歴と新しい質問)を送り、250トークンを受け取り、1日に3,000チャットを処理するとします。gpt-4o-miniでは、3.6M入力トークン × $0.15 = $0.54、0.75M出力トークン × $0.60 = $0.45で、1日$0.99です。gpt-5-nanoでは同じ日が3.6M × $0.05 = $0.18 + 0.75M × $0.40 = $0.30で、$0.48です。同じトラフィックをCheapTokensで示します。ボットに合わせて数値を変更してください:
コスト計算機
チャットボットの1日:3,000チャット
リクエストあたりの入力トークン数: 1,200 · リクエストあたりの出力トークン数: 250 · 1日あたりのリクエスト数: 3,000
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
切り替えは3つの小さな変更で済む#
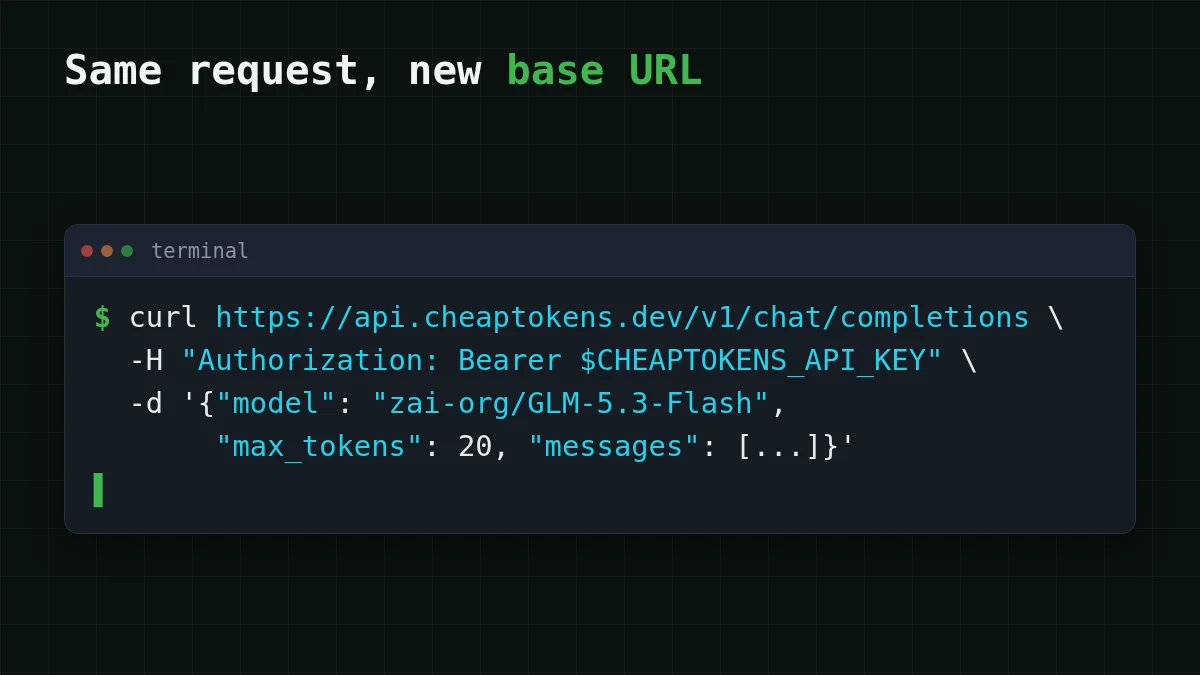
CheapTokensはOpenAI APIを話すので、既存のコードはそのまま動作します。変更するのはベースURL、キー、モデルIDです。プロバイダーによってモデルの命名が異なるため、IDはドキュメントから取得してください。GLM-5.3-Flashの場合、IDはzai-で、ベースURLはhttps:/です。
1つのタグ付けリクエスト、2つの方法
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
実際のチケット50件で実行し、回答を自分で読んでください。各レスポンスのusageフィールドは正確な入力トークン数と出力トークン数を示し、上の計算機に必要なのはこの2つの数値だけです。キー、残高、最初の呼び出しについてはyour first API requestにあります。
どのジョブにどれを#
ケースを選ぶ
何を実行していますか?
オプションを選択して答えを表示
短いテキストのタグ付けや分類
短い回答、大量のボリューム。OpenAIではgpt-5-nanoが最低価格です。CheapTokensではGLM-5.3-Flashを試してください:390Kコンテキスト、最大8,192出力トークン、時間帯に関係なく1つの価格。
長い回答:レポート、下書き、コード
DeepSeek-V4-Flashを試してください。1回の回答で最大32,768トークンを書き、380Kコンテキストを持ちます。
エージェントループやコーディングツール
MiniMax-M2.7またはDeepSeek-V4-Flashを試してください。どちらも他のモデルと同じ残高にあり、新しいアカウントなしで切り替えられます。
OpenAIに留まる必要がある
最低価格にはgpt-5-nanoを、GPT-6ラインの最安モデルが欲しいならgpt-6-lunaを使ってください。gpt-4o-miniを使っているなら、gpt-5-nanoは両方で安くなります。
どれを選ぶにしても、ワークロード全体を移行する前に自分の例でテストしてください。価格表はトークンのコストを教えてくれますが、回答が十分に良いかどうかはあなたのデータだけが教えてくれます。すべてのモデルの現在の価格は料金ページにあり、how much AI tokens costでは1Mと10Mトークンの予算を並べて比較しています。


