Model & perbandinganPerbandingan
Model API OpenAI termurah pada 2026: gpt-5-nano vs gpt-6-luna
Model API OpenAI termurah dengan harga resmi yang dicek pada 28 Okt 2026, dan berapa biaya 1.000 permintaan yang sama pada model open-weight.
Di halaman ini
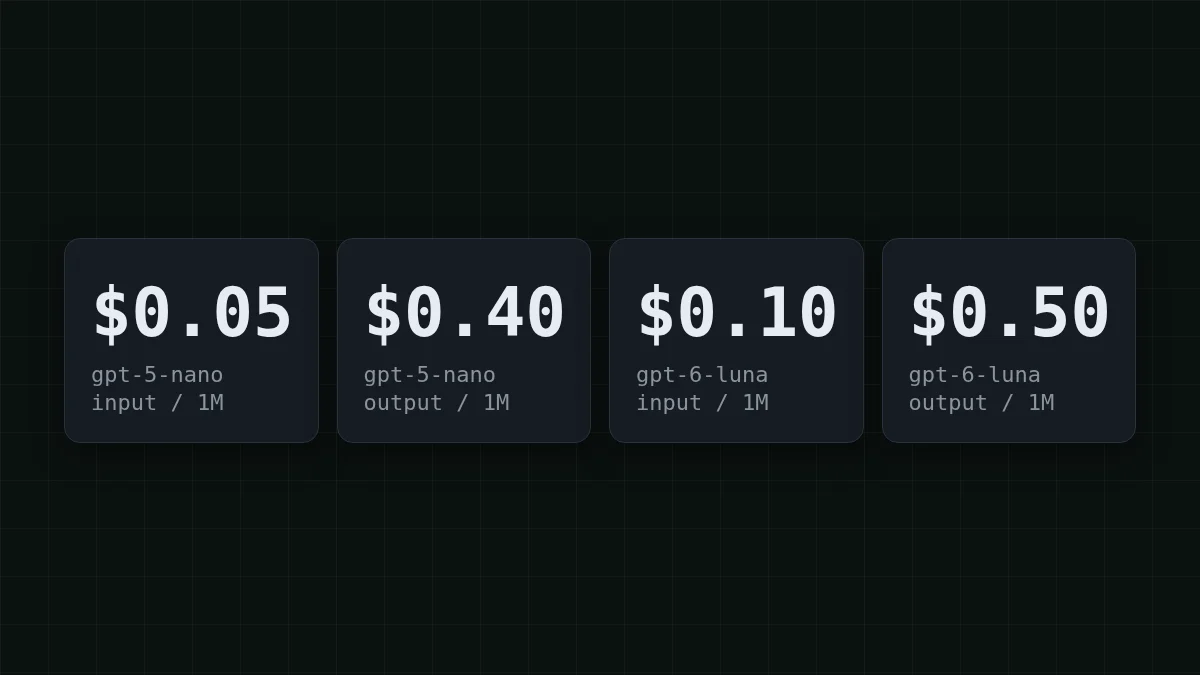
Model teks OpenAI termurah di halaman harganya adalah gpt-5-nano: $0,05 per 1 juta token input dan $0,40 per 1 juta token output. Di lini GPT-6 yang lebih baru, yang termurah adalah gpt-6-luna dengan $0,10 masuk dan $0,50 keluar. Angka-angka itu berasal dari halaman harga OpenAI, dicek pada 28 Oktober 2026. Halaman tersebut tidak mencantumkan tanggal publikasi, jadi tanggal pengecekan itulah yang bisa dipegang.
Tapi harga per token yang rendah tidak sama dengan harga per tugas yang rendah. Untuk pekerjaan kecil bervolume tinggi, model open-weight di CheapTokens, seperti GLM-5.3-Flash dan DeepSeek-V4-Flash, totalnya lebih rendah. Di bawah ini Anda bisa melihatnya pada tugas konkret, lalu masukkan angka Anda sendiri.
Tangga harga OpenAI, dari bawah#
Semua harga per 1 juta token, tier standar, konteks pendek (hingga 272K token input). Kolom terakhir adalah perhitungan untuk satu tugas konkret: 1.000 permintaan, masing-masing 500 token input dan 200 token output. Bayangkan bot dukungan yang memberi tag pada tiket.
Gulir tabel ke kanan →
| Model | Input | Output | Input cache | 1.000 permintaan (500 masuk / 200 keluar) |
|---|---|---|---|---|
| gpt-5-nano | $0,05 | $0,40 | $0,005 | $0,105 |
| gpt-4.1-nano | $0,10 | $0,40 | $0,025 | $0,13 |
| gpt-6-luna | $0,10 | $0,50 | $0,01 | $0,15 |
| gpt-4o-mini | $0,15 | $0,60 | $0,075 | $0,195 |
| gpt-5.6-luna | $0,20 | $1,20 | $0,02 | $0,34 |
| gpt-5.4-nano | $0,20 | $1,25 | $0,02 | $0,35 |
| gpt-5-mini | $0,25 | $2,00 | $0,025 | $0,525 |
Ada dua hal yang menonjol. Pertama, gpt-5-nano memiliki harga input terendah dan menyamai gpt-4.1-nano pada output, jadi jika Anda tetap di OpenAI dan tugasnya sederhana, itu adalah titik awalnya. Kedua, gpt-4o-mini, yang banyak dipilih proyek sebagai model murah, sekarang lebih mahal daripada gpt-5-nano baik pada input maupun output. Jika itu model Anda, Anda punya opsi lebih murah tanpa meninggalkan OpenAI.
Di atas tabel ada gpt-4.1-mini ($0,40 / $1,60) dan gpt-5.4-mini ($0,75 / $4,50). Tier lebih besar sebagai pembanding: gpt-6.1-terra di $1 / $5 (kami bahas di harga API GPT-6.1 Terra), gpt-6.1-sol di $2 / $10 dan gpt-6-astra di $10 / $50. Satu catatan dari halaman yang sama: endpoint pemrosesan regional dikenakan kenaikan 10% untuk model yang dirilis pada atau setelah 5 Maret 2026. Halaman tersebut hanya mencantumkan harga, jadi periksa halaman masing-masing model untuk ukuran konteks dan batasan sebelum Anda memindahkan tugas.
Ke mana uangnya pergi dalam 1.000 permintaan kecil#
Ambil bot pemberi tag tiket. Setiap permintaan mengirim sekitar 500 token (instruksi plus tiket) dan mendapat sekitar 200 kembali. Pada gpt-5-nano, 1.000 permintaan seperti itu berbiaya:
- Input: 0,5 juta token × $0,05 = $0,025
- Output: 0,2 juta token × $0,40 = $0,08
- Total: $0,025 + $0,08 = $0,105
Perhatikan pembagiannya. Jawaban singkatnya kurang dari sepertiga token, tapi itu $0,08 dari $0,105. Itulah jebakan dalam berburu model murah: harga output lebih sering menentukan tagihan daripada harga input. Jika Anda ingin versi lebih panjang dari gagasan itu, token input vs output membahasnya.
OpenAI juga mencantumkan tarif input cache: $0,005 per 1 juta untuk gpt-5-nano (cara kerjanya ada di apa itu prompt caching). Katakanlah seluruh input 500 token Anda adalah prompt berulang dan di-cache. Input turun menjadi 0,5 juta × $0,005 = $0,0025, dan tugasnya berbiaya $0,0025 + $0,08 = $0,0825. Tagihannya hampir tidak bergerak, karena 200 token output tetap berbiaya $0,08.
Coba aritmetika yang sama pada skala lebih besar:
Tebak angkanya
Sebuah pemberi tag mengirim 200.000 permintaan sehari ke gpt-5-nano, masing-masing 500 token masuk dan 200 keluar. Berapa dolar per hari?
Tebakan Anda
0100
Tampilkan jawaban
Jawaban: 21
$21. Input: 100 juta token × $0,05 = $5. Output: 40 juta token × $0,40 = $16. Total $5 + $16 = $21.
Tugas yang sama pada model open-weight#
Sekarang 1.000 permintaan yang sama dengan 500 masuk dan 200 keluar, dihargai di CheapTokens dengan tarif hari ini:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000018 | $0.018 | $0.0358 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000028 | $0.0275 | $0.0551 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.39 |
500 token input dan 200 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Dalam angka: GLM-5.3-Flash memakan $0.018, DeepSeek-V4-Flash $0.0275 dan MiniMax-M2.7 $0.055. Letakkan itu di samping $0,105 untuk gpt-5-nano. Tabelnya live, jadi mengikuti daftar harga saat ini. GLM-5.3-Flash memiliki konteks 390K dan menjawab hingga 8.192 token, yang cukup untuk tag atau balasan singkat. DeepSeek-V4-Flash memiliki konteks 380K dan menjawab hingga 32.768 token, yang penting ketika outputnya berupa laporan atau potongan kode panjang. Keduanya mempertahankan satu harga di jam berapa pun, tanpa harga puncak.
Satu skenario lagi, chatbot yang masih memakai gpt-4o-mini. Katakanlah setiap obrolan mengirim sekitar 1.200 token (riwayat plus pertanyaan baru), mendapat 250 kembali, dan Anda melayani 3.000 obrolan sehari. Pada gpt-4o-mini itu 3,6 juta token input × $0,15 = $0,54 dan 0,75 juta token output × $0,60 = $0,45, jadi $0,99 sehari. Pada gpt-5-nano hari yang sama adalah 3,6 juta × $0,05 = $0,18 plus 0,75 juta × $0,40 = $0,30, jadi $0,48. Berikut lalu lintas yang sama di CheapTokens; ubah angkanya agar sesuai bot Anda:
Kalkulator biaya
Sehari chatbot: 3.000 obrolan
Token input per permintaan: 1.200 · Token output per permintaan: 250 · Permintaan per hari: 3.000
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.102 | $3.06 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.129 | $3.87 |
| MiniMax-M2.7$0.05$0.15 | $0.293 | $8.78 |
Beralih butuh tiga perubahan kecil#
CheapTokens berbicara API OpenAI, jadi kode yang Anda miliki tetap berjalan. Anda mengubah base URL, kunci dan id model. Ambil id dari dokumentasi, karena penyedia menamai model secara berbeda. Untuk GLM-5.3-Flash itu zai-, dan base URL-nya https:/.
Satu permintaan pemberian tag, dua cara
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key="YOUR_CHEAPTOKENS_KEY",
)

resp = client.chat.completions.create(
    model="zai-org/GLM-5.3-Flash",
    max_tokens=20,
    messages=[
        {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
        {"role": "user", "content": "I was charged twice for the same order."},
    ],
)
print(resp.choices[0].message.content)
print(resp.usage)
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "zai-org/GLM-5.3-Flash",
    "max_tokens": 20,
    "messages": [
      {"role": "system", "content": "Tag the ticket as billing, bug or other. Reply with one word."},
      {"role": "user", "content": "I was charged twice for the same order."}
    ]
  }'
Jalankan pada 50 tiket asli Anda dan baca sendiri jawabannya. Field usage di setiap respons memberikan jumlah token input dan output yang tepat, dan kedua angka itu adalah semua yang dibutuhkan kalkulator di atas. Kunci, saldo dan panggilan pertama ada di permintaan API pertama Anda.
Mana untuk tugas apa#
Pilih kasus Anda
Apa yang Anda jalankan?
Pilih opsi untuk melihat jawabannya
Memberi tag atau mengklasifikasi teks pendek
Jawaban singkat, volume besar. Di OpenAI, gpt-5-nano adalah yang termurah. Di CheapTokens, coba GLM-5.3-Flash: konteks 390K, hingga 8.192 token output, satu harga di jam berapa pun.
Jawaban panjang: laporan, draf, kode
Coba DeepSeek-V4-Flash. Ia menulis hingga 32.768 token dalam satu jawaban, dan memiliki konteks 380K.
Loop agen atau alat coding
Coba MiniMax-M2.7 atau DeepSeek-V4-Flash. Keduanya berada di satu saldo dengan model lain, jadi Anda bisa beralih di antara keduanya tanpa akun baru.
Anda harus tetap di OpenAI
Gunakan gpt-5-nano untuk harga terendah, atau gpt-6-luna jika Anda ingin model termurah dari lini GPT-6. Jika Anda memakai gpt-4o-mini, gpt-5-nano lebih murah di kedua sisi.
Mana pun yang Anda pilih, uji pada contoh Anda sendiri sebelum memindahkan seluruh beban kerja. Tabel harga memberi tahu berapa biaya satu token; hanya data Anda yang memberi tahu apakah jawabannya cukup baik. Harga terkini untuk setiap model ada di halaman harga, dan berapa biaya token AI menempatkan anggaran 1 juta dan 10 juta token berdampingan.


