Novità AIAggiornamento
Prezzo API di GPT-6.1 Terra: $1 in, $5 out per 1M di token
Cosa significa il nuovo prezzo di GPT-6.1 Terra di OpenAI per un task di un agente in 20 passi, accanto al vecchio prezzo di GPT-5.6 Terra e ai modelli più economici.
In questa pagina
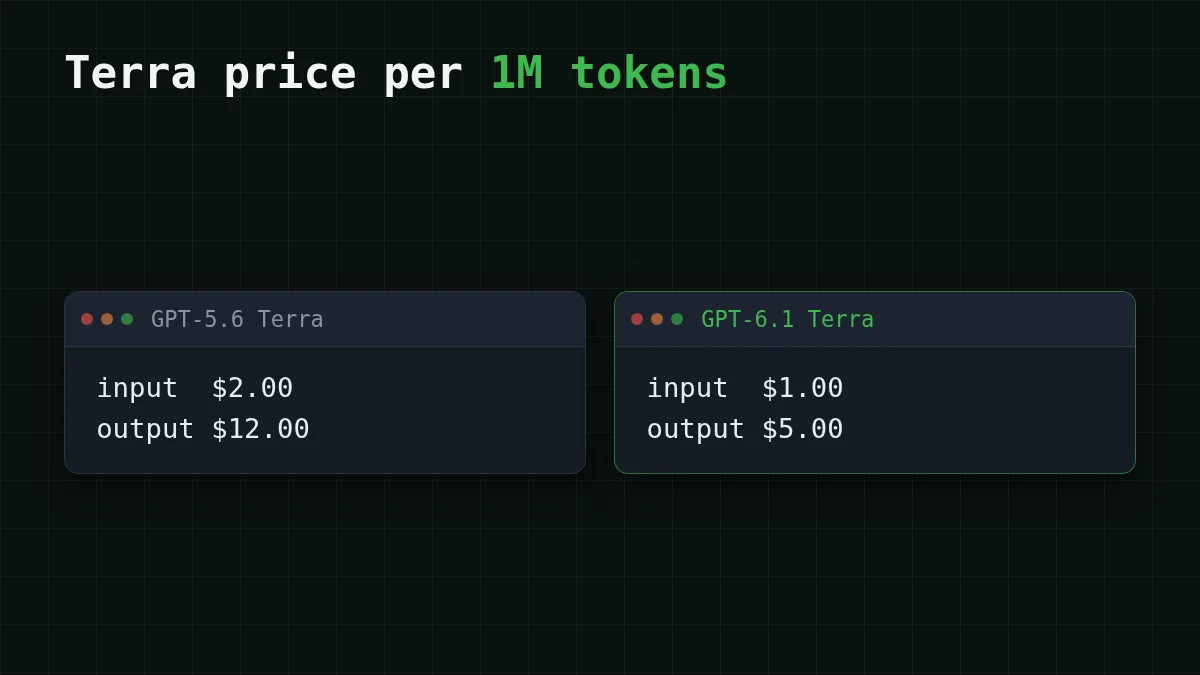
GPT-6.1 Terra è elencato a $1,00 per 1M di token in input e $5,00 per 1M di token in output nella pagina dei prezzi dell'API di OpenAI (verificato il 27 ottobre 2026). Il precedente Terra, GPT-5.6 Terra, è elencato nella stessa pagina a $2,00 e $12,00. Se il tuo agente di coding gira su GPT-5.6 Terra, passarlo a GPT-6.1 Terra dimezza all'incirca la bolletta per lo stesso task. Qui sotto: di quanto per un tipico task di un agente, e dove un modello più economico ti porta più lontano.
Cosa è cambiato nella pagina dei prezzi#
GPT-6.1 Terra è elencato nella pagina dei prezzi di OpenAI (verificato il 27 ottobre 2026) con l'id API gpt-6.1-terra. L'input è sceso alla metà del vecchio prezzo. L'output è passato da $12,00 a $5,00. Quel secondo numero conta più di quanto sembri: gli agenti scrivono molto, e l'output è il lato costoso.
La pagina ha più di una riga, però, e scegliere quella sbagliata è il modo più facile per ritrovarsi con una fattura a sorpresa:
Abbina le coppie
Abbina ogni livello della pagina dei prezzi alle sue tariffe
Tocca un elemento a sinistra, poi il suo abbinamento
- Standard, input fino a 272K token$1,00 in, $5,00 out per 1M
- Input oltre 272K token$2,00 in, $7,50 out per 1M
- Batch / Flex$0,50 in, $2,50 out per 1M
- Fast$2,00 in, $10,00 out per 1M
L'input in cache è elencato separatamente a $0,05 per 1M sul livello standard, il che aiuta quando ogni passo di un agente rinvia lo stesso lungo prefisso. Il resto di questo articolo usa il livello standard e nessuna cache, così i numeri sono facili da rifare.
Quanto costa un task di un agente in 20 passi#
Diciamo che il tuo agente risolva un ticket in 20 passi. Ogni passo invia il task, i file che ha aperto e i risultati degli strumenti finora, circa 30.000 token in input in media, e scrive circa 1.500 token in risposta (un piano, una patch, un comando). È un'ipotesi che sembra semplice, ed è quella che rende costosi gli agenti: l'input viene rinviato a ogni passo. (Se questa parte è nuova, perché gli agenti AI usano così tanti token la spiega nel dettaglio.)
Un task quindi arriva a 20 × 30.000 = 600.000 token in input e 20 × 1.500 = 30.000 token in output. Ogni passo resta ben sotto la soglia dei 272K, quindi si applicano le tariffe standard.
- GPT-6.1 Terra: 0,6 × $1,00 = $0,60 per l'input, 0,03 × $5,00 = $0,15 per l'output, $0,60 + $0,15 = $0,75 per task.
- GPT-5.6 Terra: 0,6 × $2,00 = $1,20 per l'input, 0,03 × $12,00 = $0,36 per l'output, $1,20 + $0,36 = $1,56 per task.
Ora fai la proporzione. Un team che chiude 100 task di questo tipo al giorno paga 100 × $0,75 = $75 al giorno sul nuovo modello contro 100 × $1,56 = $156 sul vecchio. Un taglio reale, e nessuna modifica al tuo codice tranne l'id del modello.
Lo stesso task sui modelli che serviamo, ai prezzi live (un passo è 30.000 in e 1.500 out, per 20 passi):
| Modello | Input $/1M | Output $/1M | Per richiesta | 20 richieste | OpenRouter, 20 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0271 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0332 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.216 |
30.000 token di input e 1500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Per un intero task, DeepSeek-V4-Flash arriva a $0.012, GLM-5.3-Flash a $0.0132 e MiniMax-M2.7 a $0.0345. La tabella mostra anche il prezzo OpenRouter per ciascuno di essi, e in totale, contando insieme input e output, CheapTokens è il lato più economico.
Prima di spostare un'intera pipeline, invia una manciata dei tuoi ticket al modello candidato e confronta i conteggi dei token nel blocco usage con la tabella qui sopra.
Quale modello per quale lavoro#
Se il calo di prezzo ti ha spinto verso Terra, chiediti prima di cosa ha davvero bisogno il tuo loop. Storie lunghe, risposte lunghe, un budget stretto: sono tre lavori diversi, e abbiamo un modello per ciascuno.
Scegli il tuo caso
Scegli il lavoro più vicino al tuo
Scegli un'opzione per vedere la risposta
Un lungo loop di agente di coding
Prendi DeepSeek-V4-Flash. Ha una context window di 380K, scrive fino a 32.768 token in output per risposta e costa lo stesso a qualsiasi ora del giorno. Si adatta agli agenti che leggono molti file e poi scrivono grandi patch.
Coding e chat di tutti i giorni
Prendi GLM-5.3-Flash. Ha una context window di 390K e risponde fino a 8.192 token, e in totale è più economico di OpenRouter per gli stessi token.
Lavoro da agente con budget stretto
Prendi MiniMax-M2.7. Ha una context window di 180K e risponde fino a 8.192 token, e in totale è più economico di OpenRouter per gli stessi token.
Tutti e tre stanno dietro un unico saldo e parlano sia l'API OpenAI sia quella Anthropic, quindi passare dall'uno all'altro è una modifica di una riga all'id del modello.
Provalo sul tuo task#
Invia uno dei tuoi prompt reali a un modello più economico e leggi il blocco usage nella risposta. Ti dice i token esatti in input e in output, che puoi confrontare con il passo da 30.000 in / 1.500 out ipotizzato sopra. Richiesta di esempio (l'indirizzo e l'id del modello sono quelli da copiare; tieni la tua chiave in una variabile d'ambiente):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Write a unit test for a function that parses ISO dates."}],
    "max_tokens": 800
  }'
La configurazione completa è nella documentazione di CheapTokens, il listino prezzi live è nella pagina dei prezzi, e come stimare il costo di un agente AI mostra come trasformare i tuoi log nei due numeri da cui è partito questo articolo.


