Ano ang context window sa AI? Ano ang pumupuno dito at ano ang gawin
Ang context window ay ang working memory ng modelo para sa isang request: ang iyong prompt, ang chat history at ang sagot. Tingnan kung ano ang pumupuno dito, kung paano tantiyahin ito, at tatlong gawi.
Sa pahinang ito
Maayos na tumakbo ang iyong chat sa loob ng dalawampung mensahe, at ngayon ay nagiging malabo na ang mga sagot. Isang bagay na lumalaki sa bawat mensahe ay ang context window: ang working memory ng modelo para sa isang request. Hawak nito ang lahat ng ipinapadala mo kasama ang sagot na isinusulat ng modelo, at mayroon itong fixed na laki, halimbawa 380K tokens para sa DeepSeek-V4-Flash.
Ano ang context window#
Isipin mo ang isang mesa. Ang modelo ay makakapagtrabaho lamang sa kung ano ang nasa mesa sa ngayon: ang iyong mga tagubilin, ang pag-uusap hanggang ngayon, isang na-paste na dokumento at ang sagot na isinusulat nito. Anumang wala sa mesa ay hindi umiiral para dito. Ang dokumentasyon ng Anthropic tungkol sa context windows (sinuri noong 27 Oktubre 2026) ay pareho ang sinasabi: ang window ay ang lahat ng teksto na maaaring i-reference ng modelo kapag bumubuo ito ng tugon, kasama ang tugon mismo, at hiwalay ito sa data kung saan sinanay ang modelo.
Ang mesa ay may fixed na laki, binibilang sa tokens. Ang token ay isang piraso ng teksto, humigit-kumulang ¾ ng isang salitang Ingles; ano ang token sa AI ay mas malalim na tumatalakay. Narito ang tatlong modelo sa CheapTokens at ang kanilang mga window:
- GLM-5.3-Flash: 390K tokens
- DeepSeek-V4-Flash: 380K tokens
- MiniMax-M2.7: 180K tokens
Ang K ay nangangahulugang libo. Ang 380K na window ay humigit-kumulang 285,000 salitang Ingles: 380,000 × 0.75 = 285,000. Iyon ay ilang nobela sa isang mesa, at nauubos pa rin ito nang mas mabilis kaysa sa inaasahan mo.
Ano ang binibilang dito#
Lahat ng nasa request ay binibilang, hindi lamang ang iyong huling mensahe:
- ang system prompt (ang nakatayong mga tagubilin);
- bawat naunang mensahe, sa iyo at sa modelo;
- mga depinisyon ng tool at resulta ng tool, kung gumagamit ka ng agent o editor plugin;
- mga dokumento at larawan na ikinakabit mo;
- ang sagot mismo, kasama ang anumang pag-iisip na ginagawa ng modelo.
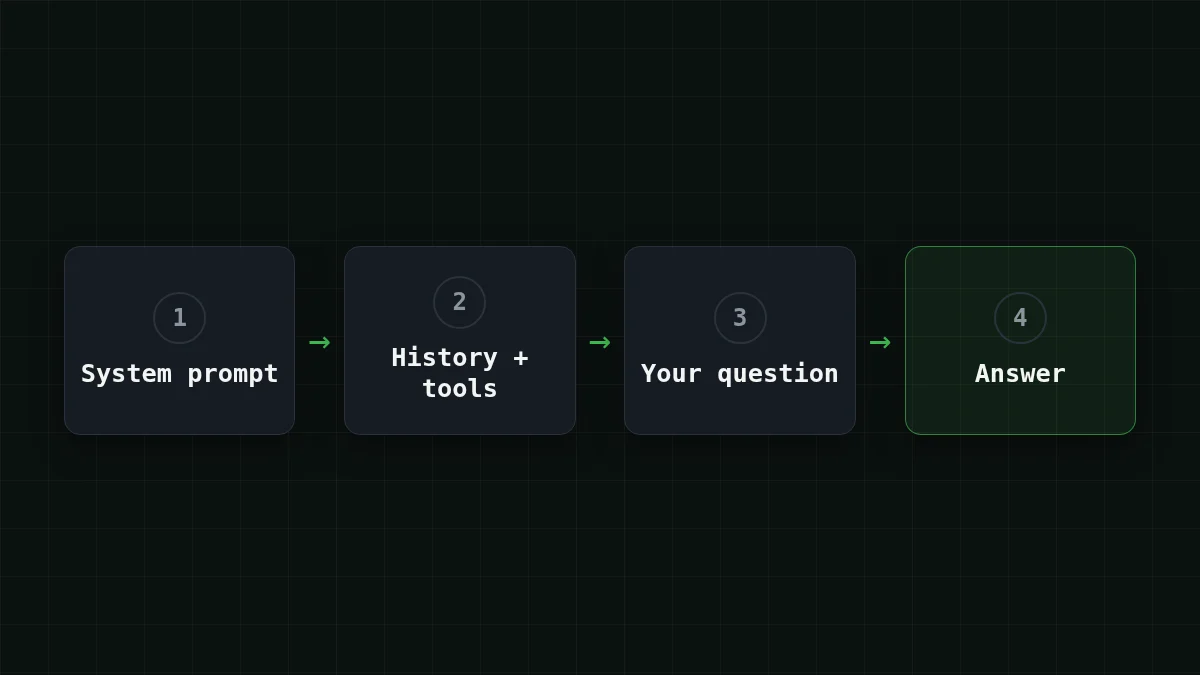
Ang editor agent ang mapaglinlang na kaso. Sa bawat hakbang, ipinapadala nitong muli ang listahan ng tool kasama ang lahat ng nabasa nito hanggang ngayon. Nag-type ka ng isang pangungusap; mas marami ang nakikita ng window.
Hindi mo kailangang hulaan ang laki. Ang bawat tugon ay may dalang usage field na may mga bilang ng token. Ang minimal na chat loop na ito (OpenAI-compatible API, model id mula sa CheapTokens docs) ay nagpapakita ng dalawang bagay nang sabay: ang buong history ay ipinapadala sa bawat turn, at ang mga bilang ay bumabalik.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

history = [{"role": "system", "content": "You are a helpful assistant."}]

def ask(text):
    history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model="deepseek-ai/DeepSeek-V4-Flash-0731",
        messages=history,  # the whole conversation goes out every time
        max_tokens=1000,
    )
    answer = resp.choices[0].message.content
    history.append({"role": "assistant", "content": answer})
    print(resp.usage.prompt_tokens, "in /", resp.usage.completion_tokens, "out")
    return answer
Tawagin ang ask() ng sampung beses at panoorin ang unang numero na umakyat. Ang pag-akyat na iyon ang buong kuwento ng artikulong ito.
Window vs. max output: dalawang magkaibang numero#
Bawat pahina ng modelo ay naglilista ng dalawang laki, at madalas na pinagpapalit ito ng mga baguhan. Ang window ay ang buong mesa, input at output na magkasama. Ang output limit ay kung gaano kahaba ang isang sagot: hanggang 32,768 tokens para sa DeepSeek-V4-Flash, hanggang 8,192 para sa GLM-5.3-Flash at MiniMax-M2.7.
Nagsasalo sila sa parehong espasyo. Anuman ang kunin ng iyong input, ang sagot ay kailangang magkasya sa natitira. Kung gusto mong makita kung ano ang hitsura ng putol na sagot, bakit humihinto ang sagot ng AI sa gitna ng pangungusap ay dumadaan dito.
Mabilisang pagsusuri
Ang DeepSeek-V4-Flash ay may 380K na window at 32,768-token na output limit. Nagpadala ka ng 375K tokens na input. Mga gaano kahaba ang maaaring maging sagot?
Ipakita ang sagot
Sagot: Mga 5K tokens, ang natitira sa window
Ang window ay sumasaklaw sa input at output nang magkasama: 380K − 375K ay nag-iiwan ng mga 5K, na mas mababa sa 32,768 cap.
Bakit pinupuno ng mahabang chat ang window (at ang bill)#
Hindi naaalala ng modelo ang iyong huling mensahe. Upang maipagpatuloy ang isang pag-uusap, ang API ay tumatanggap ng buong history muli sa bawat turn: ang mga naunang turn ay ganap na itinatago, at ang sagot ng modelo ay nagiging bahagi ng susunod na input. (Minsan ay tahimik na itinatapon ng mga chat app ang pinakalumang mga mensahe; hindi ito ginagawa ng API para sa iyo.)
Sabihin nating nakikipag-chat ka sa isang support assistant sa loob ng 30 turn. Ipagpalagay ang 400-token na system prompt, 150 tokens bawat tanong at 450 bawat sagot, kaya ang bawat palitan ay nagdadagdag ng 600 tokens sa history.
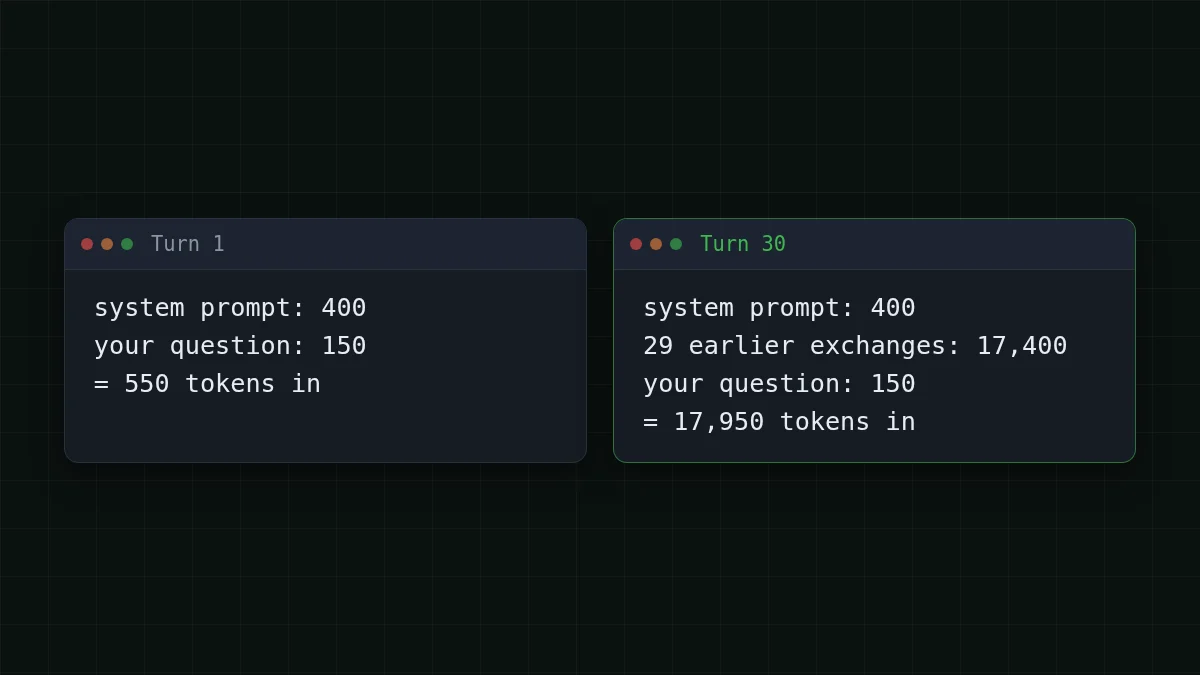
Ang Turn 1 ay nagpapadala ng mga 550 tokens. Ang Turn 30 ay nagpapadala ng 400 + 150 + 29 × 600 = 17,950. Kapag pinagsama-sama sa buong chat, ang bawat turn ay may dalang 550 tokens ng sarili nitong simula, kaya 30 × 550 = 16,500. Sa ibabaw nito, ang turn n ay muling nagpapadala ng n − 1 na naunang palitan ng 600 tokens bawat isa: 600 × 435 = 261,000, kung saan 435 = 1 + 2 + … + 29. Ang input ng buong chat ay 16,500 + 261,000 = 277,500 tokens, at ang mga sagot ay nagdadagdag ng 30 × 450 = 13,500.
Sa DeepSeek-V4-Flash, ang buong chat na iyon ay nagkakahalaga ng $0.0055. Narito ang lahat ng tatlong modelo, kasama ang reference na presyo ng OpenRouter sa tabi nila; binibilang ang input at output nang magkasama, ang bawat isa ay mas mura kaysa sa OpenRouter para sa chat na ito:
| Modelo | Input $/1M | Output $/1M | Gastos | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0061 | $0.0125 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0055 | $0.0153 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0159 | $0.0995 |
277,500 input at 13,500 output na token sa kabuuan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa average, ang chat na iyon ay 277,500 ÷ 30 = 9,250 tokens in bawat request at 450 out.
Gusto mo ng sarili mong chat? Baguhin ang mga numero sa ibaba, halimbawa sa 100 turn, at panoorin kung gaano kabilis lumaki ang kabuuan.
Calculator ng gastos
Ang parehong 30-turn na chat, sa average
Mga input token bawat kahilingan: 9,250 · Mga output token bawat kahilingan: 450 · Mga kahilingan bawat araw: 30
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0061 | $0.183 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0055 | $0.165 |
| MiniMax-M2.7$0.05$0.15 | $0.0159 | $0.477 |
Ngayon ang tapat na bahagi. Ang 17,950 tokens ay wala pang 5% ng 380K na window, kaya ang isang plain na chat ay bihirang tumama sa pader. Ang lumalaki ay ang bill at ang ingay. Ang dokumentasyon ng Anthropic ay nagpapansin na ang accuracy at recall ay bumababa habang lumalaki ang bilang ng token (tinatawag nila itong context rot), kaya ang mas malaking window ay hindi awtomatikong mas mahusay: ang inilalagay mo ay kasinghalaga ng kung gaano karami ang kasya. Kung saan lumilitaw ang pader ay sa mga dokumento at agent. Sa sariling API ng Anthropic, ang isang request na ang input lamang ay mas malaki kaysa sa window ay nakakakuha ng 400 error, prompt is too long. Para sa cost side ng parehong epekto, tingnan ang bakit mas mahal ang mahabang AI chat.
Kasya ba ang aking dokumento?#
Isang magaspang na tuntunin para sa tekstong Ingles: ang isang token ay mga ¾ ng isang salita, kaya tokens ≈ words ÷ 0.75. Ang ibang mga wika ay karaniwang kumukuha ng mas maraming token bawat salita, kaya mag-iwan ng dagdag na margin. Subukan ito bago magpatuloy sa pagbabasa.
Hulaan ang numero
Ilang token ang isang 90,000-salitang libro?
Ang iyong hula
0300,000
Ipakita ang sagot
Sagot: 120,000
Mga 120,000: 90,000 ÷ 0.75 = 120,000. Kasya ito sa alinman sa tatlong window nang may labis na espasyo.
Ngayon isang mas malaking kaso. Sabihin nating mayroon kang 150,000-salitang archive ng support emails at gusto mo ng buod: 150,000 ÷ 0.75 = 200,000 tokens. Ang 200,000 tokens ay higit pa sa 180K na window, kaya para sa archive na ito piliin ang GLM-5.3-Flash (390K) o DeepSeek-V4-Flash (380K). Ang DeepSeek-V4-Flash ay nag-iiwan pa ng 380,000 − 200,000 = 180,000 tokens na espasyo sa DeepSeek-V4-Flash, higit pa sa sapat para sa isang buod sa ilalim ng 32,768-token na answer limit nito. Ang pagbabasa ng 200,000 tokens na iyon at pagsulat ng 2,000-token na buod ay nagkakahalaga ng $0.0032.
Isang mas maliit na kaso: ang 60,000-salitang ulat ay 60,000 ÷ 0.75 = 80,000 tokens. Kayang-kaya ito ng MiniMax-M2.7 na may 100K na natitira, na ginagawang sapat ang 180K na window nito para sa mga chat at mid-size na dokumento.
Tatlong gawi para sa halos punong window#
1. Ibuod at magsimulang muli. Sa turn 30, ang request ay may dalang 17,950 tokens. Hilingin sa modelo na magsulat ng 200-token na buod ng mga desisyon hanggang ngayon, pagkatapos ay magsimula ng bagong chat kasama nito. Ang susunod na request ay 400 + 200 + 150 = 750 tokens in, at alam pa rin ng modelo kung ano ang mahalaga.
2. Ipadala lamang ang bahaging kailangan mo. I-paste ang kabanata na tinatanong mo, hindi ang buong libro; ang function, hindi ang buong repository. Mas kaunti sa mesa ay nangangahulugan ng mas maliit na bill, at, ayon sa context-rot note ng Anthropic, isang modelo na may mas kaunting maliligaw.
3. Panatilihing payat ang mga fixed na bahagi at bantayan ang usage. Ang system prompt, mga depinisyon ng tool at mahahabang resulta ng tool ay sumasama sa bawat hakbang. Putulin ang hindi mo ginagamit, i-print ang mga bilang ng token pagkatapos ng bawat tugon tulad ng sa loop sa itaas, at itakda ang max_tokens sa haba na aktwal na kailangan mo.
Kapag gusto mong subukan ito sa isang tunay na modelo, ang CheapTokens docs ay nagpapakita ng unang request sa ilang linya, at ang pricing page ay naglilista ng live na presyo ng bawat modelo. Para sa mahahabang dokumento at agent loops, ang DeepSeek-V4-Flash (380K context, hanggang 32,768 output tokens, isang fixed na presyo na walang peak hours) at GLM-5.3-Flash (390K, ang pinakamalaking window sa tatlo) ang mga dapat unang tingnan.


