API та SDKПосібник
LangChain ChatOpenAI з власним base_url: CheapTokens у Python
Спрямуйте ChatOpenAI з LangChain на CheapTokens: base_url, ключ і id моделі в Python, а потім виклик, потокова передача та використання токенів на виклик.
На цій сторінці
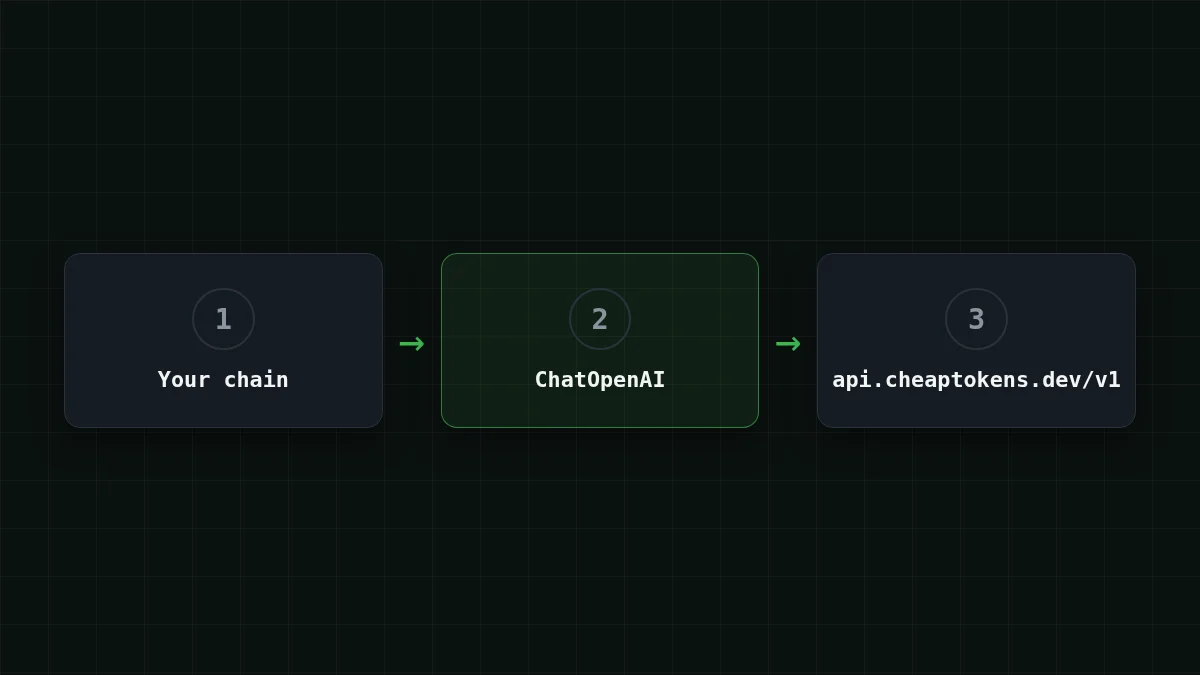
У вас уже є ланцюг LangChain, який звертається до ChatOpenAI, і ви хочете, щоб він працював на іншій кінцевій точці без переписування. Це можливо: передайте три аргументи — base_url, api_key і model, — а решта ланцюга залишиться як є. CheapTokens підтримує протокол OpenAI Chat Completions за адресою https:/, тож ChatOpenAI працює з ним напряму.
Наведені нижче кроки відповідають документації LangChain ChatOpenAI станом на 27 жовтня 2026 року. На сторінці не вказано ні дати, ні версії, тому я не фіксую тут реліз langchain-openai: встановлюйте останній.
Крок за кроком
Підключення LangChain за три кроки
Встановлення
pip install -U langchain-openaiЗадайте ключ
Тримайте ключ у змінній середовища, а не у файлі:
export CHEAPTOKENS_API_KEY="your-key"Викличте модель
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() повертає повідомлення; .content — це текст відповіді. Ось і все підключення. Отримайте ключ і поповніть баланс у документації CheapTokens.
Який id моделі вказувати в model#
Використовуйте повний id з префіксом розробника. Коротка назва на кшталт deepseek- — це те, що ви бачите в таблицях цін; API приймає deepseek-. Id зі списку моделей CheapTokens:
deepseek-: контекст 380K, до 32 768 вихідних токенів на відповідь. Гарний варіант за замовчуванням для ланцюгів із довгими документами та довгими відповідями.ai/ DeepSeek- V4- Flash- 0731 zai-: контекст 390K, до 8 192 вихідних токенів.org/ GLM- 5. 3- Flash MiniMaxAI/: контекст 180K, до 8 192 вихідних токенів.MiniMax- M2. 7
Перемикання — це зміна одного рядка, бо модель — просто рядок:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
Усі три моделі мають спільний баланс, тож ви можете випробувати кожну на тому самому ланцюзі, нічого нового не відкриваючи. Актуальні ціни — на сторінці цін; для MiniMax-M2.7 вхідні токени коштують $0.05, а вихідні — $0.15 за 1M токенів.
Налаштування base_url через середовище#
Якщо ви не хочете чіпати код, LangChain читає адресу із середовища. У документації наведено порядок пріоритету:
- аргумент
base_url(абоopenai_api_base), який ви передаєте в коді; OPENAI_API_BASE, який читає LangChain;OPENAI_BASE_URL, який читає SDKopenai.
Швидка перевірка
Ви задаєте base_url у коді й також експортуєте OPENAI_BASE_URL з іншою адресою. Який із них використає ChatOpenAI?
Показати відповідь
Відповідь: Аргумент base_url у коді
Явний аргумент має найвищий пріоритет, потім OPENAI_API_BASE, потім OPENAI_BASE_URL. Забута змінна у вашій оболонці не перенаправить виклик, який явно задає base_url.
Один побічний ефект із тієї ж сторінки документації: коли задано OPENAI_BASE_URL, LangChain за замовчуванням не вмикає stream_usage. Це важливо в наступних двох розділах.
Потокова передача відповіді#
Для інтерфейсу ви хочете отримувати текст у міру надходження. stream() видає фрагменти, і кожен фрагмент містить частину .content:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
    print(chunk.content, end="", flush=True)
Цього достатньо для вікна чату. Якщо ви також хочете отримати кількість токенів наприкінці потоку, передайте stream_: ChatOpenAI(.. Цей посібник рахує токени з invoke(), як у наступному розділі. Потокова передача в звичайному SDK OpenAI описана в Потокові відповіді в Python.
Читання використання токенів на виклик#
Кожне повідомлення, повернуте invoke(), містить usage_metadata з токенами, використаними у виклику:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
Підсумуйте їх по всьому конвеєру — і отримаєте бюджет на запуск:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
Вхідні та вихідні токени тарифікуються окремо, тож зберігайте обидва числа. Чому існує цей поділ — у Вхідні та вихідні токени, а повний трекер із зупинкою на бюджеті — у Відстеження вартості токенів AI-агента в Python.
Скільки коштує конвеєр LangChain на день#
Припустімо, ви запускаєте бота підтримки з 2 000 звернень на день. Кожен виклик надсилає звернення плюс підказку — близько 3 000 токенів, — а відповідь становить близько 500 токенів. На MiniMax-M2.7 один такий виклик коштує $0.00023. Пересуньте повзунки на свої числа; сайт підсумує їх за поточними цінами:
Калькулятор вартості
Один день роботи бота підтримки
Вхідні токени на запит: 3 000 · Вихідні токени на запит: 500 · Запитів на день: 2 000
| Модель | За день | За місяць |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
Калькулятор показує денну суму: у такому виклику вхідні токени становлять більшу частину, а вихідні — меншу. З CheapTokens загальна сума, з урахуванням вхідних і вихідних разом, виходить нижчою, ніж в OpenRouter, і ціна однакова в будь-яку годину: немає пікових тарифів, під які треба планувати.
Що охоплює цей посібник#
Приклад використовує звичайні chat completions: invoke, stream і usage_metadata. ChatOpenAI відповідає специфікації OpenAI, тож текст відповіді міститься в .content. Згідно з документацією LangChain, він перемикається на Responses API, коли ви використовуєте вбудовані інструменти або параметр reasoning.
Якщо виклик не вдається, причина зазвичай одна з трьох: /v1 відсутній у base_url, короткий id моделі замість повного, або змінна ключа не експортована в оболонці, яка запускає Python. Список типових помилок підключення показує, як виглядає кожна з них.
Наступний крок: запустіть наведений вище блок із трьох кроків зі своїм ланцюгом, а потім спробуйте той самий ланцюг на сумісних з OpenAI кінцевих точках з іншим id моделі.


