APIとSDKガイド
カスタム base_url を使った LangChain ChatOpenAI: Python で CheapTokens
LangChain の ChatOpenAI を CheapTokens に向ける: Python で base_url、キー、モデル id を設定し、呼び出し、ストリーミング、呼び出しごとのトークン使用量を確認。
このページの内容
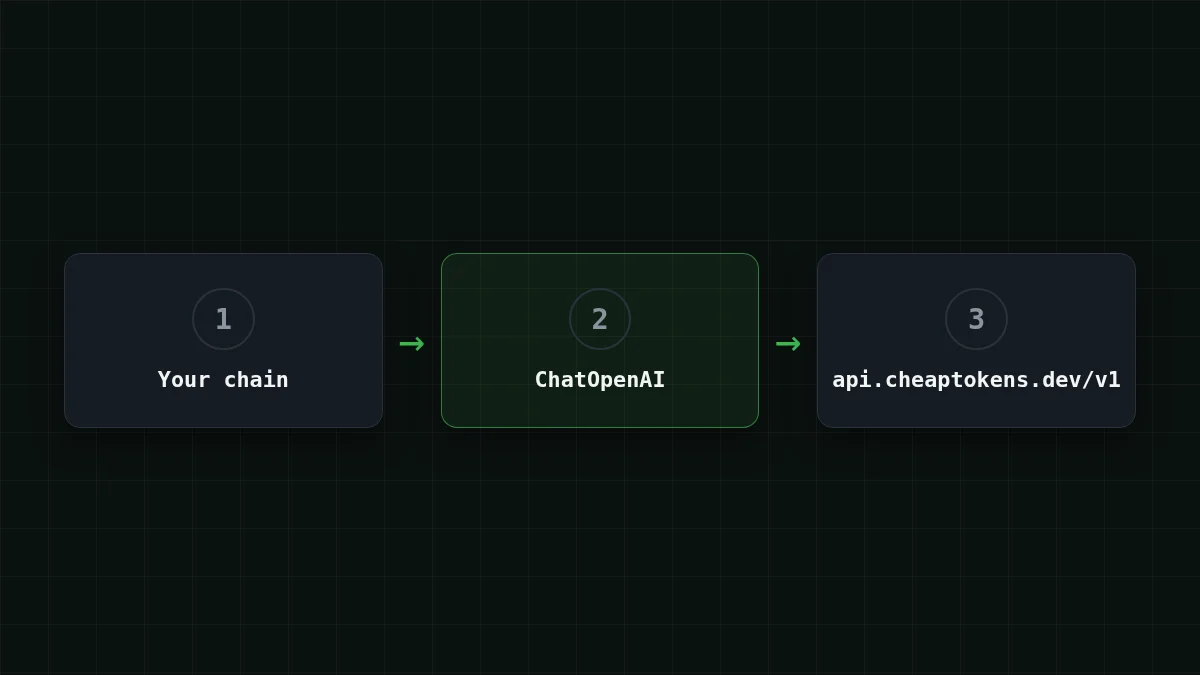
すでに ChatOpenAI と通信する LangChain チェーンがあり、それを書き直さずに別のエンドポイントで動かしたいとします。その場合、base_url、api_key、model の3つの引数を渡すだけで、チェーンの残りはそのままです。CheapTokens は https:/ で OpenAI Chat Completions プロトコルを話すので、ChatOpenAI はそのまま動作します。
以下の手順は、2026年10月27日時点で確認した LangChain ChatOpenAI のドキュメント に従っています。このページには日付やバージョンの記載がないため、ここでは langchain-openai のリリースを固定しません。最新版をインストールしてください。
ステップバイステップ
LangChain を3ステップで接続する
インストール
pip install -U langchain-openaiキーを設定する
キーはファイル内ではなく、環境変数に保持してください:
export CHEAPTOKENS_API_KEY="your-key"モデルを呼び出す
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

msg = llm.invoke("Explain what a token is in one sentence.")
print(msg.content)
invoke() はメッセージを返し、.content が回答テキストです。接続はこれだけです。キーの取得と残高のチャージは CheapTokens のドキュメント で行えます。
model に入れるモデル id#
開発者プレフィックス付きの完全な id を使用してください。deepseek- のような短い名前は価格表に表示されるもので、API は deepseek- を受け付けます。CheapTokens のモデル一覧にある id は次のとおりです:
deepseek-: コンテキスト 380K、回答あたり最大 32,768 出力トークン。長いドキュメントと長い回答を扱うチェーンのデフォルトとして適しています。ai/ DeepSeek- V4- Flash- 0731 zai-: コンテキスト 390K、最大 8,192 出力トークン。org/ GLM- 5. 3- Flash MiniMaxAI/: コンテキスト 180K、最大 8,192 出力トークン。MiniMax- M2. 7
モデルは単なる文字列なので、切り替えは1行の変更で済みます:
llm = ChatOpenAI(
    model="zai-org/GLM-5.3-Flash",
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
3つとも1つの残高を共有するので、新たに何かを開くことなく同じチェーンでそれぞれを試せます。現在の価格は 料金ページ にあります。MiniMax-M2.7 の場合、入力は $0.05、出力は $0.15 (100万トークンあたり) です。
環境変数で base_url を設定する#
コードに触れたくない場合は、LangChain が環境変数からアドレスを読み取ります。ドキュメントには優先順位が記載されています:
- コード内で渡す
base_url(またはopenai_api_base) 引数; - LangChain が読み取る
OPENAI_API_BASE; openaiSDK が読み取るOPENAI_BASE_URL。
クイックチェック
コード内で base_url を設定し、さらに別のアドレスで OPENAI_BASE_URL をエクスポートしたとします。ChatOpenAI はどちらを使用しますか?
答えを表示
答え: コード内の base_url 引数
明示的な引数が最優先で、次に OPENAI_API_BASE、その次に OPENAI_BASE_URL です。シェルに残った変数を忘れていても、base_url を明示的に設定した呼び出しがリダイレクトされることはありません。
同じドキュメントページによる副作用がもう1つあります: OPENAI_BASE_URL が設定されている場合、LangChain はデフォルトで stream_usage をオフにします。これは次の2つのセクションで重要になります。
回答をストリーミングする#
UI では、テキストが届くそばから表示したいものです。stream() はチャンクを生成し、各チャンクには .content の断片が含まれます:
for chunk in llm.stream("Write a three-line summary of how HTTP works."):
print(chunk.content, end="", flush=True)これでチャットウィンドウには十分です。ストリーム終了時にトークン数も取得したい場合は、stream_ を渡します: ChatOpenAI(.。このガイドでは、次のセクションのように invoke() からトークンを数えます。素の OpenAI SDK でのストリーミングは Python でのストリーミング応答 で扱っています。
呼び出しごとのトークン使用量を読み取る#
invoke() が返す各メッセージには、その呼び出しで使用したトークンを含む usage_metadata が付いています:
msg = llm.invoke("Summarize this ticket in one line: my invoice shows the wrong VAT number.")
print(msg.usage_metadata)
# {'input_tokens': ..., 'output_tokens': ..., 'total_tokens': ...}
これらをパイプライン全体で合計すれば、実行ごとの予算が得られます:
total_in = total_out = 0
for ticket in tickets:
    msg = llm.invoke(ticket)
    total_in += msg.usage_metadata["input_tokens"]
    total_out += msg.usage_metadata["output_tokens"]
入力と出力は別々に価格設定されるので、両方の数値を保持してください。この分割が存在する理由は 入力トークンと出力トークン に、予算で停止するガード付きの完全なトラッカーは Python で AI エージェントのトークンコストを追跡する にあります。
LangChain パイプラインの1日あたりのコスト#
1日2,000件のチケットを処理するサポートボットを運用しているとします。各呼び出しはチケットとプロンプトを送信し、約3,000トークン、回答は約500トークンです。MiniMax-M2.7 では、そのような呼び出し1回のコストは $0.00023 です。スライダーを自分の数値に動かしてください。サイトが現在の価格で合計を計算します:
コスト計算機
サポートボットの1日
リクエストあたりの入力トークン数: 3,000 · リクエストあたりの出力トークン数: 500 · 1日あたりのリクエスト数: 2,000
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.16 | $4.80 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.19 | $5.70 |
| MiniMax-M2.7$0.05$0.15 | $0.45 | $13.50 |
計算機は1日の合計を表示します: この種の呼び出しでは、入力がトークンの大部分を占め、出力はより小さい部分です。CheapTokens では、入力と出力を合わせた合計が OpenRouter より低くなり、価格はどの時間帯でも同じです。計画を立てる必要のあるピーク時間料金はありません。
このガイドの対象範囲#
この例では、プレーンなチャット補完を使用しています: invoke、stream、usage_metadata。ChatOpenAI は OpenAI 仕様に従うため、回答テキストは .content にあります。LangChain のドキュメントによると、組み込みツールや reasoning パラメータを使用すると Responses API に切り替わります。
呼び出しが失敗する場合、原因は通常次の3つのいずれかです: base_url に /v1 がない、完全な id ではなく短いモデル id を使用している、または Python を実行するシェルでキー変数がエクスポートされていない。一般的な接続エラー の一覧に、それぞれがどのように見えるかが示されています。
次のステップ: 上記の3ステップのブロックを自分のチェーンで実行し、次に同じチェーンを別のモデル id で OpenAI 互換エンドポイント 上で試してみてください。


