Premiers pasGuide
Première requête vers CheapTokens avec HTTPie : clé dans l'env, = et :=
Une commande http lisible qui envoie un chat completion avec la clé dans une variable d'environnement, puis montre où se trouvent la réponse et l'utilisation des tokens.
Sur cette page
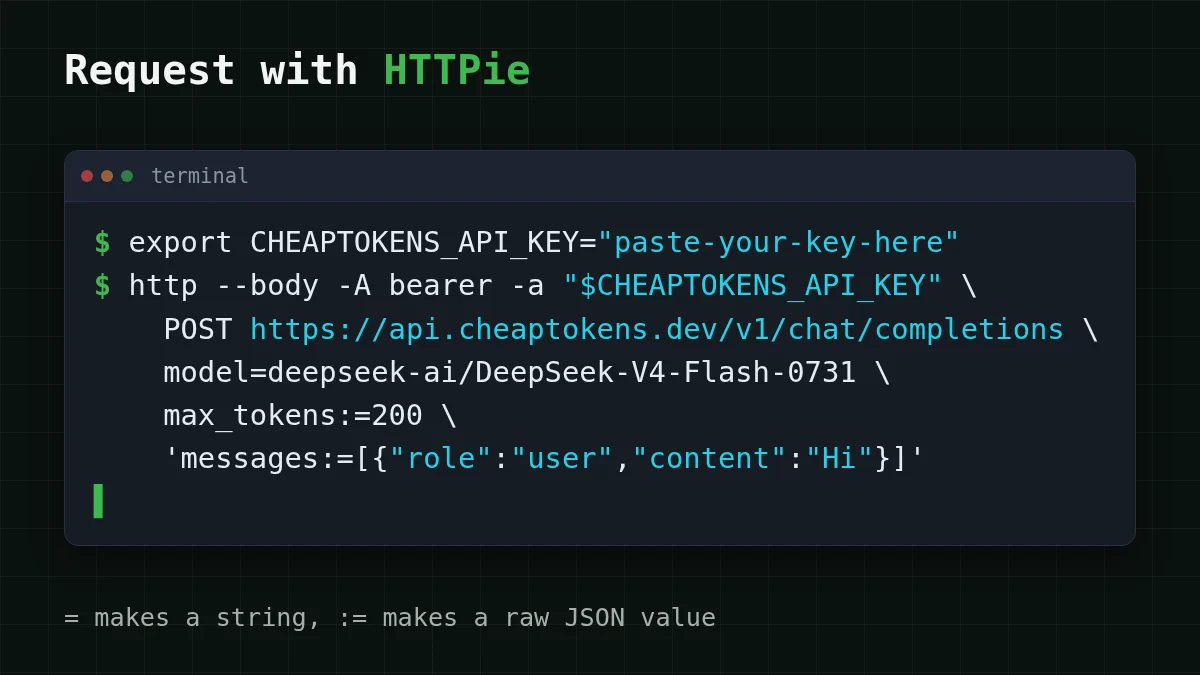
Vous voulez savoir que la clé fonctionne et que l'identifiant du modèle est correct, et vous voulez le savoir en une seule ligne. La commande http de HTTPie fait cela avec bien moins de guillemets que curl : vous tapez les champs, elle construit le JSON. Voici la requête complète, et le reste de l'article explique chaque élément.
export CHEAPTOKENS_API_KEY="paste-your-key-here"

http --body -A bearer -a "$CHEAPTOKENS_API_KEY" \
  POST https://api.cheaptokens.dev/v1/chat/completions \
  model=deepseek-ai/DeepSeek-V4-Flash-0731 \
  max_tokens:=200 \
  'messages:=[{"role":"user","content":"In one sentence, what is a token?"}]'
L'API est compatible OpenAI, donc l'URL de base est https:/ et les requêtes de chat vont vers / sous celle-ci. L'identifiant du modèle est le complet, deepseek- (le nom court des tableaux de prix n'est pas accepté). Si vous n'avez jamais stocké de clé, stockez d'abord une clé API en toute sécurité : taper la ligne export place la clé dans l'historique de votre shell, donc un fichier de profil ou un gestionnaire de secrets est un meilleur emplacement.
Ce que font réellement = et :=#
C'est la seule partie de HTTPie que vous devez apprendre. La documentation JSON de HTTPie (version 3.2.4, datée du 1er novembre 2024, consultée le 9 novembre 2026) indique que = définit un champ chaîne et que := définit une valeur JSON brute : un nombre, un booléen, un tableau ou un objet. Les champs fournis de cette manière sont envoyés comme corps JSON par défaut, vous n'ajoutez donc pas d'en-tête Content-Type vous-même.
Dans notre requête, cela donne trois formes différentes :
model=deepseek-est une chaîne, doncai/ DeepSeek- V4- Flash- 0731 =.max_tokens:=200est un nombre, donc:=. Avec=vous enverriez la chaîne"200".messages:=[…]est un tableau d'objets, donc:=à nouveau, et la valeur est entre guillemets simples pour que le shell laisse les guillemets doubles internes tranquilles.
La documentation précise aussi qu'un corps provenant de stdin ne peut pas être combiné avec des champs en ligne de commande, alors choisissez un seul style. Pour un premier test, les champs sont plus courts et plus faciles à modifier.
Vérification rapide
Qu'envoie max_tokens=200 (avec un = simple) ?
Afficher la réponse
Réponse: La chaîne "200"
= crée toujours une chaîne. Pour un nombre, il faut :=, donc écrivez max_tokens:=200.
Où se trouve la réponse#
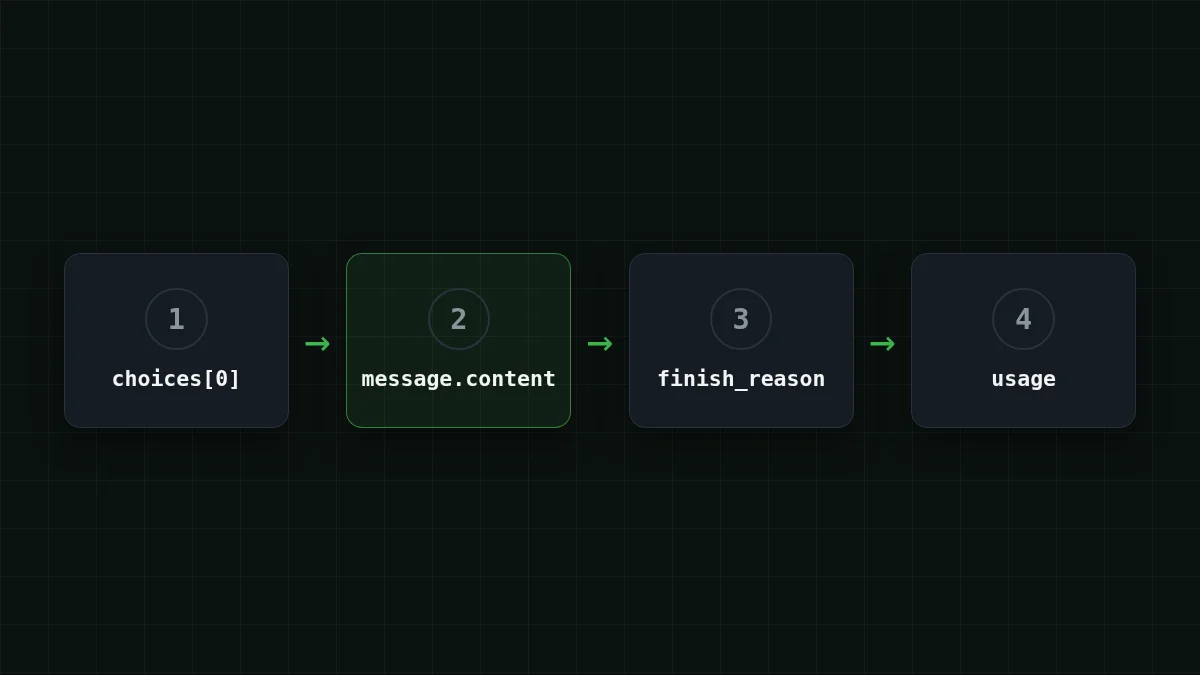
La réponse suit le format chat-completions d'OpenAI. Vous cherchez trois choses, et elles se trouvent à des endroits différents :
{
  "choices": [
    {
      "message": { "role": "assistant", "content": "…the answer text…" },
      "finish_reason": "stop"
    }
  ],
  "usage": { "prompt_tokens": …, "completion_tokens": …, "total_tokens": … }
}
Le texte de la réponse est choices[0].. finish_reason se trouve à côté dans le même choix, et usage est au niveau supérieur. usage indique combien de tokens vous avez envoyés (prompt_tokens) et combien le modèle en a écrit (completion_), ce qui est pratique pour estimer le coût d'une requête.
Si vous ne voulez que le texte, passez le corps à jq :
http --body -A bearer -a "$CHEAPTOKENS_API_KEY" \
  POST https://api.cheaptokens.dev/v1/chat/completions \
  model=deepseek-ai/DeepSeek-V4-Flash-0731 \
  max_tokens:=200 \
  'messages:=[{"role":"user","content":"In one sentence, what is a token?"}]' \
  | jq -r '.choices[0].message.content'
Essayez vous-mêmeEssayez : rendez la limite trop petite et lisez finish_reasonAfficher la réponse
Passez max_tokens:=200 à max_tokens:=5 et relancez. La réponse est tronquée, et finish_reason affiche length au lieu de stop : la limite a arrêté le modèle, pas la fin de la réflexion. Pourquoi une réponse est tronquée couvre la solution.
Changez de modèle : modifiez un champ#
Le modèle est une seule chaîne, donc en essayer un autre est une modification d'un mot. Les deux identifiants ci-dessous sont disponibles sur CheapTokens avec un seul solde ; DeepSeek-V4-Flash vous donne un contexte de 380K et jusqu'à 32 768 tokens de sortie par réponse, GLM-5.3-Flash un contexte de 390K et jusqu'à 8 192.
Une requête, deux modèles
DeepSeek-V4-Flash
http --body -A bearer -a "$CHEAPTOKENS_API_KEY" \
  POST https://api.cheaptokens.dev/v1/chat/completions \
  model=deepseek-ai/DeepSeek-V4-Flash-0731 \
  max_tokens:=200 \
  'messages:=[{"role":"user","content":"Name three uses of a token limit."}]'
GLM-5.3-Flash
http --body -A bearer -a "$CHEAPTOKENS_API_KEY" \
  POST https://api.cheaptokens.dev/v1/chat/completions \
  model=zai-org/GLM-5.3-Flash \
  max_tokens:=200 \
  'messages:=[{"role":"user","content":"Name three uses of a token limit."}]'
Vous ne savez pas quel identifiant utiliser ? Listez les modèles avec GET /v1/models et copiez la chaîne exacte.
Combien coûte une requête de test#
Une question courte comme celle-ci est bon marché. Disons que la question fait environ 100 tokens et la réponse environ 150 : cette requête coûte $0.000017. Mille d'entre elles ressemblent à ceci, entrée et sortie comptées ensemble :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000008 | $0.008 | $0.0158 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000017 | $0.0165 | $0.028 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000028 | $0.0275 | $0.33 |
100 tokens d'entrée et 150 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Au total, entrée et sortie comptées ensemble, DeepSeek-V4-Flash revient moins cher qu'OpenRouter, et le prix est un tarif fixe sans heures de pointe. Les tarifs actuels de chaque modèle sont sur la page de tarification.
Si ça ne fonctionne pas#
- Vous avez tapé
messages=[…]avec un=simple. Le tableau part comme une chaîne, pas comme une liste de messages. Utilisez:=et des guillemets simples autour de toute la valeur. - Le JSON dans
:=est invalide. Chaque clé et chaîne a besoin de guillemets doubles, et les guillemets externes doivent être simples. Si vous modifiez le texte du message, gardez les guillemets équilibrés. - La clé est vide.
echo ${#CHEAPTOKENS_affiche la longueur sans montrer la clé ;API_ KEY} 0signifie que la variable n'est pas définie dans ce terminal. - L'identifiant du modèle est le nom court. Utilisez le
deepseek-complet. Pour les réponses 401 et 404, voir mauvaise clé, URL de base ou identifiant de modèle.ai/ DeepSeek- V4- Flash- 0731 - Vous avez pensé à
--session. La documentation d'authentification de HTTPie indique que les fichiers de session stockent les identifiants en texte clair, donc gardez la clé dans l'environnement et laissez--sessionhors de cette commande.
Vérifiez votre version avec http --version si un indicateur se comporte différemment de ce qui précède. Vous préférez Python ? La même requête sans SDK se trouve dans première requête en Python avec requests. Pour la référence complète de l'API, voir la documentation CheapTokens.


