API & SDKGuide
Première requête en Rust avec async-openai : URL de base, clé, usage
Un petit programme Rust avec tokio et async-openai qui envoie un chat completion à CheapTokens et affiche la réponse et les compteurs de tokens.
Sur cette page
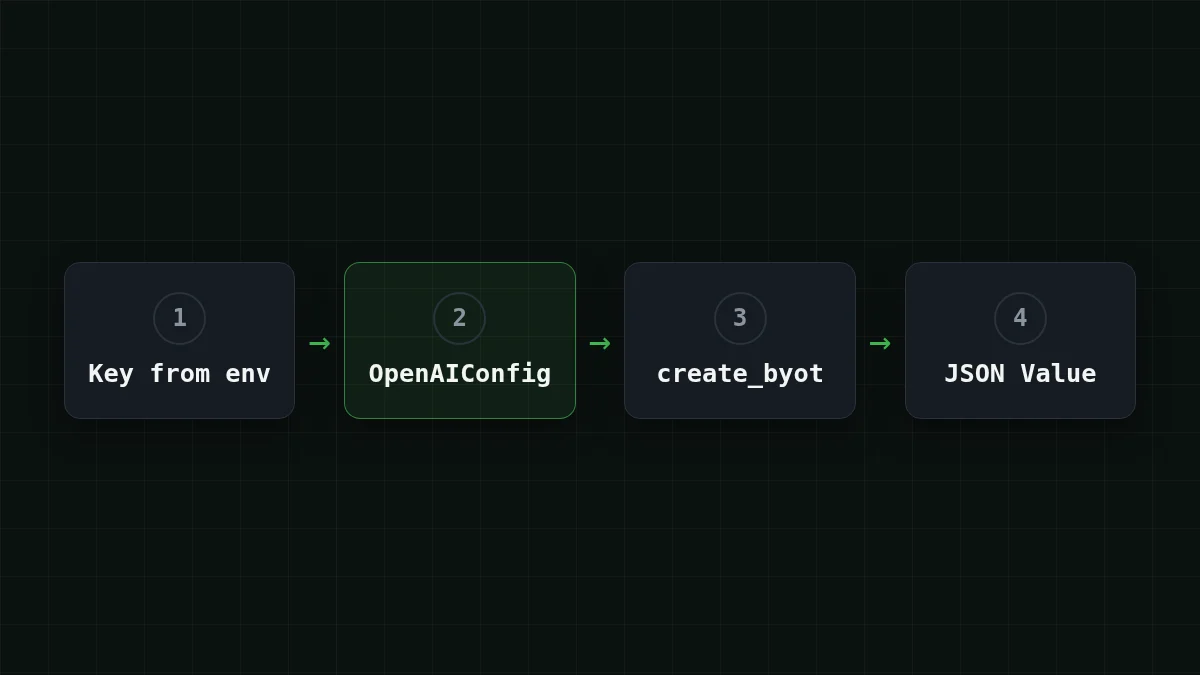
Pour appeler CheapTokens depuis Rust avec async-openai, construisez un OpenAIConfig avec l'URL de base https:/ et votre clé, puis envoyez la requête avec create_byot et un corps JSON. Le texte de la réponse et les compteurs de tokens proviennent du JSON renvoyé. Cela fait environ 25 lignes de code, et le même programme fonctionne pour n'importe quel modèle de la page des modèles CheapTokens une fois que vous changez une seule chaîne.
La page docs.rs du crate (vérifiée le 8 novembre 2026) liste la version 0.43.0 sous licence MIT, et c'est la version que suit ce guide.
Pourquoi create_byot plutôt que des requêtes typées#
async-openai vous donne normalement un constructeur de requête typé : vous remplissez une struct, il vous renvoie une struct. C'est confortable jusqu'à ce qu'une passerelle renvoie un champ que les structs ne connaissent pas. La fonctionnalité byot ("bring your own types") ajoute des méthodes *_byot qui acceptent n'importe quel corps JSON et renvoient n'importe quel type que vous pouvez désérialiser, y compris un simple serde_.
Pour une première requête, c'est exactement ce qu'il vous faut. Vous écrivez le même JSON que vous mettriez dans un appel curl, et vous lisez usage directement depuis la réponse, sans type à rechercher.
Configurer le projet#
Étape par étape
Créez le projet et définissez la clé
Ajouter les crates
Dans un projet neuf (cargo new cheaptokens-), ajoutez trois dépendances. async-openai a besoin de deux fonctionnalités ici : byot pour les méthodes create_byot et chat-completion pour la section chat.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Placer la clé dans une variable d'environnement
Créez la clé dans votre compte CheapTokens et gardez-la hors du code source. Si vous voulez la version longue, voir comment stocker une clé API en toute sécurité.
export CHEAPTOKENS_API_KEY="paste-your-key-here"Sur Windows PowerShell, la même ligne est $env:CHEAPTOKENS_.
Lancer le programme
Collez le code de la section suivante dans src/main.rs et démarrez-le.
cargo runLe programme#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Trois lignes portent toute l'idée. with_api_base est l'endroit où CheapTokens intervient : l'URL de base se termine par /v1, et async-openai ajoute lui-même le chemin de l'endpoint. with_api_key prend la valeur lue depuis l'environnement. Et model est l'id complet deepseek- — les noms courts des tableaux de prix ne sont pas acceptés par l'API.
L'indexation d'un Value avec une clé manquante donne null au lieu d'un panic, donc une faute de frappe dans un nom de champ apparaît comme null dans la sortie plutôt qu'un crash. C'est pratique quand vous explorez une réponse.
Ce qui revient#
La passerelle parle le format OpenAI Chat Completions, donc la réponse a la forme habituelle (tronquée ici, les ... marquent les champs que nous sautons) :
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
Les nombres dans usage sont de vrais compteurs pour votre requête, ils remplacent donc les zéros quand vous l'exécutez. prompt_tokens est ce que vous avez envoyé, completion_ est ce que le modèle a écrit. Ils sont facturés à des prix différents, ce qui est l'intérêt de les afficher. Si la différence est nouvelle pour vous, tokens d'entrée vs de sortie l'explique en cinq minutes.
Essayez vous-mêmeEssayez : mettez "max_tokens" à 5 et relancez. Que dit finish_reason ?Afficher la réponse
Dans le format OpenAI Chat Completions, il dit length. Le modèle a atteint votre plafond et la phrase est coupée en plein milieu. Avec une réponse normale, il dit stop. Si vous voyez length dans un vrai job, augmentez max_tokens — cet article couvre la correction.
Combien coûte une requête#
Disons que vous exécutez cet appel en boucle, une petite question en entrée et une réponse courte en sortie : 300 tokens d'entrée et 200 tokens de sortie à chaque fois. Sur DeepSeek-V4-Flash, cela fait $0.000025 par requête, à partir du prix en direct de $0.015 par 1M de tokens d'entrée et $0.10 par 1M de tokens de sortie. Comptés ensemble, entrée et sortie, c'est moins cher qu'OpenRouter, et le modèle conserve un contexte de 380K et répond jusqu'à 32 768 tokens.
Le tableau ci-dessous montre la même requête sur chaque modèle, multipliée par 1 000.
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 tokens d'entrée et 200 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Les prix sont sur la page de tarification.
Changer de modèle#
Le code ne change pas quand le modèle change ; seule la chaîne dans "model" change. Par exemple, zai- a un contexte de 390K et répond jusqu'à 8 192 tokens. Pour éviter complètement de modifier le code, lisez l'id depuis une seconde variable avec std::env::var("CHEAPTOKENS_. Si vous n'êtes pas sûr des ids que votre clé voit, listez les modèles avec GET /v1/models.
Si ça ne fonctionne pas#
environment variable not founddès le début : la clé n'est pas exportée dans ce terminal. Exportez-la à nouveau dans la même fenêtre où vous lancezcargo run.- Une erreur 401 de l'API : la clé est fausse ou a un espace ou un guillemet parasite autour.
- Une erreur 404 : vérifiez que l'URL de base se termine par
/v1et que l'id du modèle est le complet, avec le préfixedeepseek-ai/. API 401 ou 404 : clé, URL de base, id de modèle détaille la marche à suivre. - Le compilateur ne trouve pas
create_byot: la fonctionnalitébyotn'est pas activée. Relancez la lignecargo addde la configuration.
Pour un problème de connexion qui n'est aucun de ceux-là, voir les erreurs de connexion courantes.
La même première requête existe pour d'autres langages : Go et Ruby. Pour en savoir plus sur l'API elle-même, ouvrez la documentation CheapTokens.


