API y SDKGuía
Primera petición en Rust con async-openai: URL base, clave, uso
Un pequeño programa en Rust con tokio y async-openai que envía un chat completion a CheapTokens e imprime la respuesta y los recuentos de tokens.
En esta página
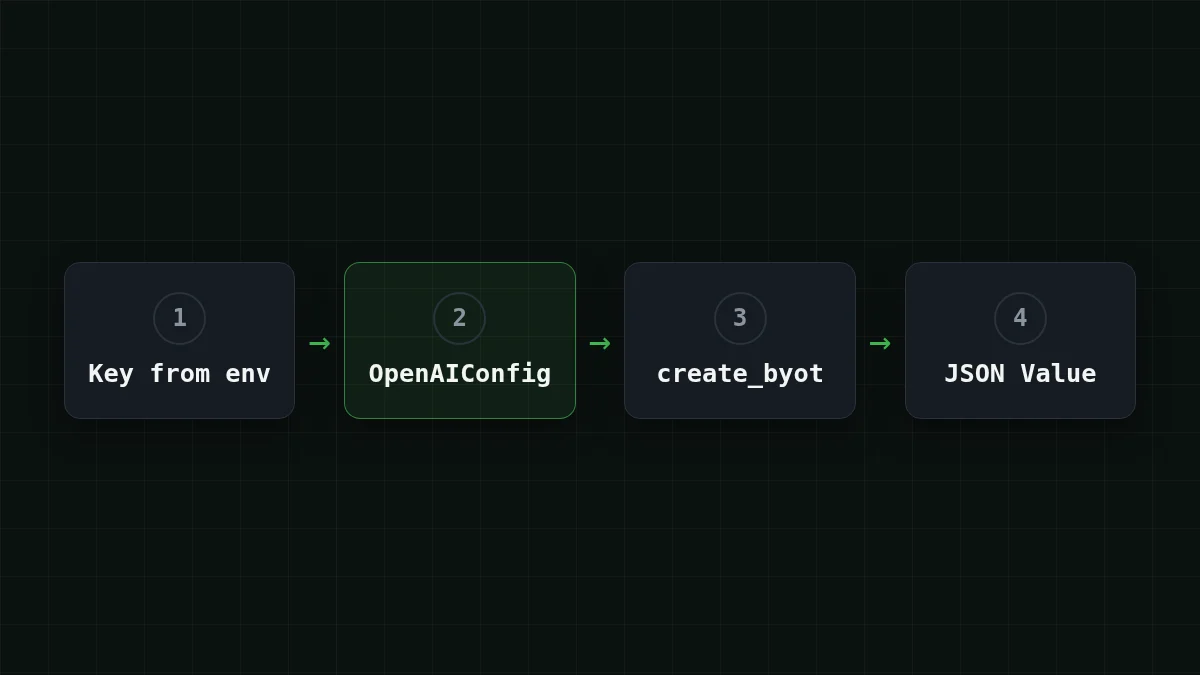
Para llamar a CheapTokens desde Rust con async-openai, construye un OpenAIConfig con la URL base https:/ y tu clave, y luego envía la petición con create_byot y un cuerpo JSON. El texto de la respuesta y los recuentos de tokens salen del JSON que devuelve. Son unas 25 líneas de código, y el mismo programa sirve para cualquier modelo de la página de modelos de CheapTokens con solo cambiar una cadena.
La página docs.rs del crate (consultada el 8 de noviembre de 2026) lista la versión 0.43.0 bajo la licencia MIT, y es la versión que sigue esta guía.
Por qué create_byot en lugar de peticiones tipadas#
async-openai normalmente te da un constructor de peticiones tipado: rellenas una struct y te devuelve una struct. Eso es cómodo hasta que una pasarela devuelve un campo que las structs no conocen. La feature byot ("bring your own types") añade métodos *_byot que aceptan cualquier cuerpo JSON y devuelven cualquier tipo en el que puedas deserializar, incluido un serde_ simple.
Para una primera petición eso es exactamente lo que quieres. Escribes el mismo JSON que pondrías en una llamada curl, y lees usage directamente de la respuesta, sin ningún tipo que consultar.
Configurar el proyecto#
Paso a paso
Crea el proyecto y define la clave
Añade los crates
En un proyecto nuevo (cargo new cheaptokens-), añade tres dependencias. async-openai necesita dos features aquí: byot para los métodos create_byot y chat-completion para la sección de chat.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Pon la clave en una variable de entorno
Crea la clave en tu cuenta de CheapTokens y mantenla fuera del código fuente. Si quieres la versión larga, consulta cómo almacenar una clave de API de forma segura.
export CHEAPTOKENS_API_KEY="paste-your-key-here"En Windows PowerShell la misma línea es $env:CHEAPTOKENS_.
Ejecuta el programa
Pega el código de la siguiente sección en src/main.rs y arráncalo.
cargo runEl programa#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Tres líneas concentran toda la idea. with_api_base es donde entra CheapTokens: la URL base termina en /v1, y async-openai añade la ruta del endpoint por sí mismo. with_api_key toma el valor que leímos del entorno. Y model es el id completo deepseek- — la API no acepta los nombres cortos de las tablas de precios.
Indexar un Value con una clave inexistente devuelve null en lugar de un panic, así que una errata en el nombre de un campo aparece como null en la salida en vez de un crash. Eso viene bien cuando estás explorando una respuesta.
Qué devuelve#
La pasarela habla el formato OpenAI Chat Completions, así que la respuesta tiene la forma habitual (recortada aquí, las marcas ... indican campos que omitimos):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
Los números de usage son recuentos reales de tu petición, así que sustituyen a los ceros cuando lo ejecutes. prompt_tokens es lo que enviaste, completion_ es lo que escribió el modelo. Se facturan a precios distintos, que es la razón de imprimirlos. Si la diferencia es nueva para ti, tokens de entrada vs salida lo explica en cinco minutos.
Pruébalo tú mismoPruébalo: pon "max_tokens" a 5 y ejecuta de nuevo. ¿Qué dice finish_reason?Mostrar respuesta
En el formato OpenAI Chat Completions dice length. El modelo alcanzó tu límite y la frase se corta a medias. Con una respuesta normal dice stop. Si ves length en un trabajo real, sube max_tokens — este artículo cubre la solución.
Cuánto cuesta una petición#
Supón que ejecutas esta llamada en bucle, una pregunta pequeña de entrada y una respuesta corta de salida: 300 tokens de entrada y 200 de salida cada vez. En DeepSeek-V4-Flash eso es $0.000025 por petición, a partir del precio en vivo de $0.015 por 1M de tokens de entrada y $0.10 por 1M de tokens de salida. Sumando entrada y salida, sale más barato que OpenRouter, y el modelo mantiene un contexto de 380K y responde hasta 32.768 tokens.
La tabla de abajo muestra la misma petición en todos los modelos, multiplicada por 1.000.
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 tokens de entrada y 200 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Los precios están en la página de precios.
Cambiar de modelo#
El código no cambia cuando cambia el modelo; solo lo hace la cadena de "model". Por ejemplo, zai- tiene un contexto de 390K y responde hasta 8.192 tokens. Para no editar el código en absoluto, lee el id de una segunda variable con std::env::var("CHEAPTOKENS_. Si no tienes claro qué ids ve tu clave, lista los modelos con GET /v1/models.
Si no funciona#
environment variable not foundjusto al principio: la clave no está exportada en esta terminal. Expórtala de nuevo en la misma ventana donde ejecutascargo run.- Un error 401 de la API: la clave es incorrecta o tiene un espacio o una comilla de más alrededor.
- Un error 404: comprueba que la URL base termina en
/v1y que el id del modelo es el completo, con el prefijodeepseek-ai/. API 401 o 404: clave, URL base, id de modelo lo recorre paso a paso. - El compilador no encuentra
create_byot: la featurebyotno está habilitada. Ejecuta de nuevo la líneacargo addde la configuración.
Para un problema de conexión que no sea ninguno de esos, consulta los errores de conexión habituales.
La misma primera petición existe para otros lenguajes: Go y Ruby. Para más información sobre la propia API, abre la documentación de CheapTokens.


