API ও SDKগাইড
async-openai দিয়ে Rust-এ প্রথম অনুরোধ: বেস URL, কী, ব্যবহার
tokio এবং async-openai সহ একটি ছোট Rust প্রোগ্রাম যা CheapTokens-এ একটি চ্যাট কমপ্লিশন পাঠায় এবং উত্তর ও টোকেন গণনা প্রিন্ট করে।
এই পৃষ্ঠায়
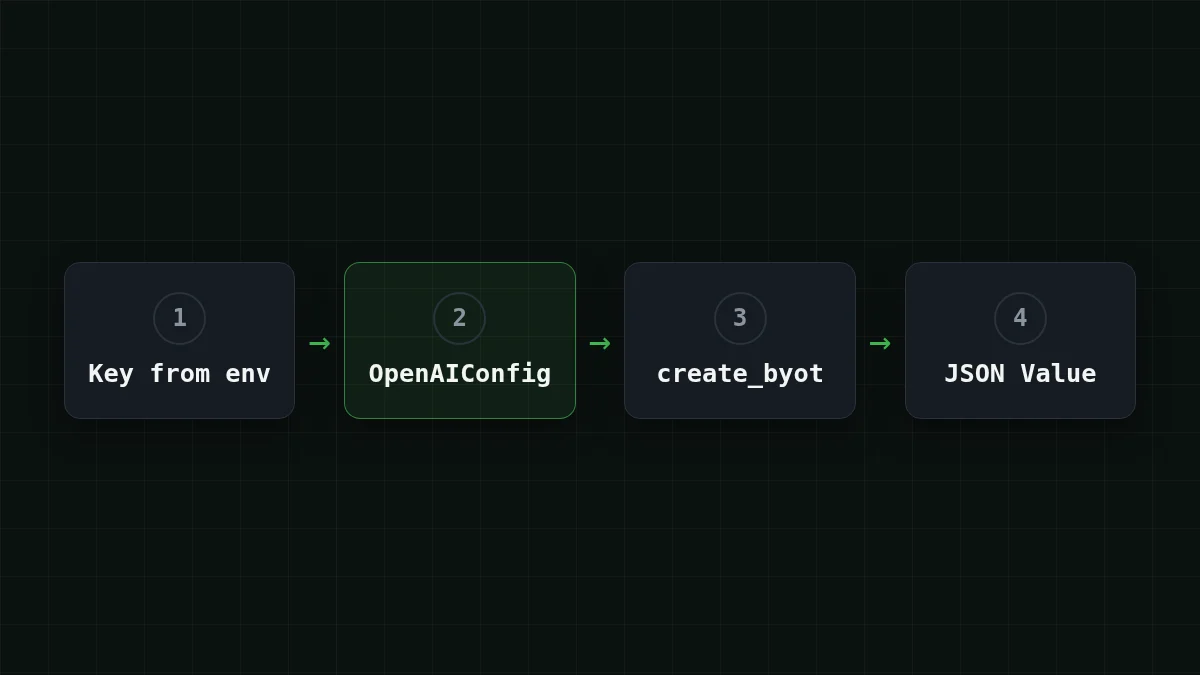
Rust থেকে async-openai দিয়ে CheapTokens কল করতে, বেস URL https:/ এবং আপনার কী দিয়ে একটি OpenAIConfig তৈরি করুন, তারপর create_byot এবং একটি JSON বডি দিয়ে অনুরোধ পাঠান। উত্তর টেক্সট এবং টোকেন গণনা ফিরে আসা JSON থেকে বেরিয়ে আসে। এটি প্রায় 25 লাইনের কোড, এবং একই প্রোগ্রাম CheapTokens মডেল পৃষ্ঠা-এর যেকোনো মডেলের জন্য কাজ করে, শুধু একটি স্ট্রিং পরিবর্তন করলেই।
ক্রেটের docs.rs পৃষ্ঠা (৮ নভেম্বর ২০২৬-এ যাচাই করা) MIT লাইসেন্সের অধীনে সংস্করণ 0.43.0 তালিকাভুক্ত করে, এবং এই গাইড সেই সংস্করণ অনুসরণ করে।
কেন টাইপড অনুরোধের পরিবর্তে create_byot#
async-openai সাধারণত আপনাকে একটি টাইপড অনুরোধ বিল্ডার দেয়: আপনি একটি স্ট্রাক্ট পূরণ করেন, এটি আপনাকে একটি স্ট্রাক্ট ফেরত দেয়। যতক্ষণ না একটি গেটওয়ে এমন একটি ফিল্ড ফেরত দেয় যা স্ট্রাক্টগুলো জানে না, ততক্ষণ এটি আরামদায়ক। byot ফিচার ("নিজের টাইপ আনুন") *_byot মেথড যোগ করে যা যেকোনো JSON বডি নেয় এবং আপনি যেকোনো টাইপে ডিসিরিয়ালাইজ করতে পারেন, যার মধ্যে সাধারণ serde_ও রয়েছে।
প্রথম অনুরোধের জন্য এটি ঠিক যা আপনি চান। আপনি curl কলে যে JSON দিতেন সেটাই লেখেন, এবং usage সরাসরি প্রতিক্রিয়া থেকে পড়েন, কোনো টাইপ খোঁজার প্রয়োজন নেই।
প্রকল্প সেট আপ করুন#
ধাপে ধাপে
প্রকল্প তৈরি করুন এবং কী সেট করুন
ক্রেটগুলো যোগ করুন
একটি নতুন প্রকল্পে (cargo new cheaptokens-), তিনটি নির্ভরতা যোগ করুন। async-openai-এর এখানে দুটি ফিচার দরকার: create_byot মেথডের জন্য byot এবং চ্যাট বিভাগের জন্য chat-completion।
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
কীটি একটি পরিবেশ ভেরিয়েবলে রাখুন
আপনার CheapTokens অ্যাকাউন্টে কী তৈরি করুন এবং এটি সোর্স কোডের বাইরে রাখুন। আপনি যদি দীর্ঘ সংস্করণ চান, কীভাবে একটি API কী নিরাপদে সংরক্ষণ করবেন দেখুন।
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell-এ একই লাইন হল $env:CHEAPTOKENS_।
প্রোগ্রাম চালান
পরবর্তী বিভাগের কোড src/main.rs-এ পেস্ট করুন এবং এটি শুরু করুন।
cargo runপ্রোগ্রাম#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
তিনটি লাইন পুরো ধারণাটি বহন করে। with_api_base হল যেখানে CheapTokens ঢোকে: বেস URL /v1 দিয়ে শেষ হয়, এবং async-openai নিজেই এন্ডপয়েন্ট পাথ যোগ করে। with_api_key পরিবেশ থেকে আমরা যে মান পড়েছি তা নেয়। এবং model হল সম্পূর্ণ আইডি deepseek- — মূল্য সারণীর সংক্ষিপ্ত নামগুলো API গ্রহণ করে না।
একটি Value-এ অনুপস্থিত কী দিয়ে ইনডেক্সিং করলে প্যানিকের পরিবর্তে null দেয়, তাই একটি ফিল্ড নামে টাইপো ক্র্যাশের বদলে আউটপুটে null হিসেবে দেখায়। প্রতিক্রিয়া অন্বেষণ করার সময় এটি সুবিধাজনক।
কী ফিরে আসে#
গেটওয়ে OpenAI Chat Completions ফরম্যাটে কথা বলে, তাই প্রতিক্রিয়ার স্বাভাবিক আকৃতি থাকে (এখানে ছাঁটা, ... চিহ্নগুলি আমরা যে ফিল্ডগুলি এড়িয়ে যাই তা চিহ্নিত করে):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}usage-এর সংখ্যাগুলি আপনার অনুরোধের জন্য প্রকৃত গণনা, তাই আপনি চালালে সেগুলি শূন্যগুলি প্রতিস্থাপন করে। prompt_tokens হল আপনি যা পাঠিয়েছেন, completion_ হল মডেল যা লিখেছে। সেগুলি ভিন্ন মূল্যে বিল করা হয়, যা সেগুলি প্রিন্ট করার উদ্দেশ্য। যদি পার্থক্যটি আপনার কাছে নতুন হয়, ইনপুট বনাম আউটপুট টোকেন পাঁচ মিনিটে এটি ব্যাখ্যা করে।
নিজে চেষ্টা করুনচেষ্টা করুন: "max_tokens" 5-এ সেট করুন এবং আবার চালান। finish_reason কী বলে?উত্তর দেখান
OpenAI Chat Completions ফরম্যাটে এটি length বলে। মডেল আপনার ক্যাপে পৌঁছেছে এবং বাক্যটি মাঝপথে কাটা পড়েছে। স্বাভাবিক উত্তরে এটি stop বলে। যদি আপনি একটি বাস্তব কাজে length দেখেন, max_tokens বাড়ান — এই নিবন্ধটি সমাধানটি কভার করে।
একটি অনুরোধের খরচ#
ধরুন আপনি এই কলটি একটি লুপে চালান, একটি ছোট প্রশ্ন ভিতরে এবং একটি সংক্ষিপ্ত উত্তর বাইরে: প্রতিটি 300 ইনপুট টোকেন এবং 200 আউটপুট টোকেন। DeepSeek-V4-Flash-এ এটি প্রতি অনুরোধে $0.000025, প্রতি 1M ইনপুট টোকেনে $0.015 এবং প্রতি 1M আউটপুট টোকেনে $0.10 এর লাইভ মূল্য থেকে। ইনপুট এবং আউটপুট একসাথে গণনা করলে, এটি OpenRouter-এর চেয়ে সস্তা, এবং মডেলটি 380K কনটেক্সট রাখে এবং 32,768 টোকেন পর্যন্ত উত্তর দেয়।
নিচের সারণীটি প্রতিটি মডেলে একই অনুরোধ দেখায়, 1,000 গুণ।
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১,০০০টি অনুরোধ | OpenRouter, ১,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
প্রতি অনুরোধে ৩০০ ইনপুট এবং ২০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
মূল্য মূল্য পৃষ্ঠা-এ লাইভ।
মডেল পরিবর্তন#
মডেল পরিবর্তন হলে কোড পরিবর্তন হয় না; শুধু "model"-এর স্ট্রিং পরিবর্তন হয়। উদাহরণস্বরূপ, zai--এ 390K কনটেক্সট রয়েছে এবং 8,192 টোকেন পর্যন্ত উত্তর দেয়। কোড সম্পাদনা এড়াতে, std::env::var("CHEAPTOKENS_ দিয়ে দ্বিতীয় ভেরিয়েবল থেকে আইডি পড়ুন। আপনার কী কোন আইডিগুলি দেখে তা নিশ্চিত না হলে, GET /v1/models দিয়ে মডেল তালিকা করুন।
যদি এটি কাজ না করে#
- শুরুতে
environment variable not found: কীটি এই টার্মিনালে এক্সপোর্ট করা হয়নি। যে উইন্ডোতে আপনিcargo runচালান সেখানেই আবার এক্সপোর্ট করুন। - API থেকে 401 ত্রুটি: কীটি ভুল বা এর চারপাশে একটি অতিরিক্ত স্পেস বা উদ্ধৃতি রয়েছে।
- 404 ত্রুটি: বেস URL
/v1দিয়ে শেষ হয় এবং মডেল আইডিdeepseek-ai/প্রিফিক্স সহ সম্পূর্ণটি কিনা তা পরীক্ষা করুন। API 401 বা 404: কী, বেস URL, মডেল আইডি এর মধ্য দিয়ে যায়। - কম্পাইলার
create_byotখুঁজে পাচ্ছে না:byotফিচার সক্রিয় নেই। সেটআপ থেকেcargo addলাইনটি আবার চালান।
এগুলোর কোনোটিই নয় এমন সংযোগ সমস্যার জন্য, সাধারণ সংযোগ ত্রুটি দেখুন।
একই প্রথম অনুরোধ অন্যান্য ভাষার জন্য বিদ্যমান: Go এবং Ruby। API সম্পর্কে আরও জানতে, CheapTokens ডক্স খুলুন।


