API e SDKGuida
Prima richiesta in Rust con async-openai: base URL, chiave, usage
Un piccolo programma Rust con tokio e async-openai che invia un chat completion a CheapTokens e stampa la risposta e i conteggi dei token.
In questa pagina
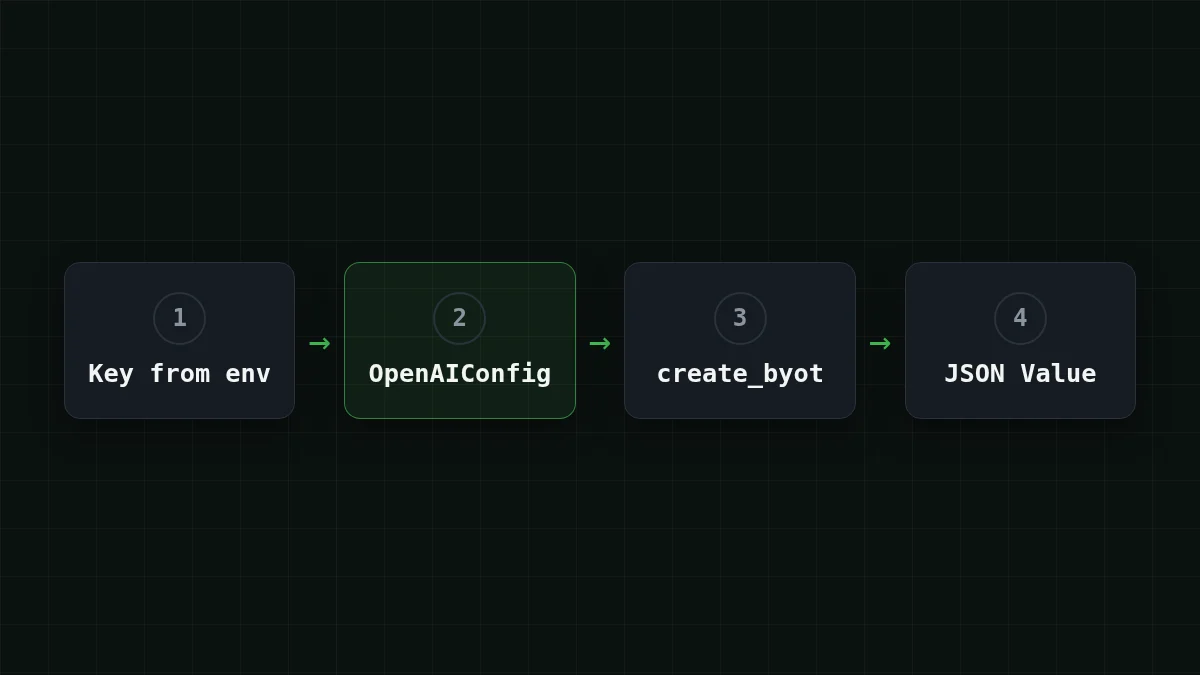
Per chiamare CheapTokens da Rust con async-openai, costruisci un OpenAIConfig con la base URL https:/ e la tua chiave, poi invia la richiesta con create_byot e un body JSON. Il testo della risposta e i conteggi dei token provengono dal JSON che ritorna. Sono circa 25 righe di codice, e lo stesso programma funziona per qualsiasi modello nella pagina dei modelli CheapTokens una volta cambiata una stringa.
La pagina docs.rs del crate (verificata l'8 novembre 2026) elenca la versione 0.43.0 con licenza MIT, ed è la versione seguita da questa guida.
Perché create_byot invece delle richieste tipizzate#
async-openai normalmente ti offre un builder di richieste tipizzato: riempi una struct, ti restituisce una struct. È comodo finché un gateway non restituisce un campo che le struct non conoscono. La feature byot ("bring your own types") aggiunge metodi *_byot che accettano qualsiasi body JSON e restituiscono qualsiasi tipo in cui puoi deserializzare, incluso un semplice serde_.
Per una prima richiesta è esattamente ciò che vuoi. Scrivi lo stesso JSON che metteresti in una chiamata curl, e leggi usage direttamente dalla risposta, senza dover cercare un tipo.
Configura il progetto#
Passo dopo passo
Crea il progetto e imposta la chiave
Aggiungi i crate
In un progetto nuovo (cargo new cheaptokens-), aggiungi tre dipendenze. async-openai richiede due feature qui: byot per i metodi create_byot e chat-completion per la sezione chat.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Metti la chiave in una variabile d'ambiente
Crea la chiave nel tuo account CheapTokens e tienila fuori dal codice sorgente. Se vuoi la versione lunga, vedi come memorizzare in sicurezza una chiave API.
export CHEAPTOKENS_API_KEY="paste-your-key-here"Su Windows PowerShell la stessa riga è $env:CHEAPTOKENS_.
Esegui il programma
Incolla il codice della sezione successiva in src/main.rs e avvialo.
cargo runIl programma#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Tre righe contengono l'idea centrale. with_api_base è dove entra CheapTokens: la base URL termina con /v1, e async-openai aggiunge da sé il percorso dell'endpoint. with_api_key prende il valore letto dall'ambiente. E model è l'id completo deepseek- — i nomi brevi delle tabelle dei prezzi non sono accettati dall'API.
Accedere a un Value con una chiave mancante restituisce null invece di un panic, quindi un errore di battitura nel nome di un campo appare come null nell'output anziché un crash. È comodo quando esplori una risposta.
Cosa ritorna#
Il gateway parla il formato OpenAI Chat Completions, quindi la risposta ha la forma usuale (qui ridotta, i ... indicano i campi che saltiamo):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
I numeri in usage sono conteggi reali per la tua richiesta, quindi sostituiscono gli zeri quando lo esegui. prompt_tokens è ciò che hai inviato, completion_ è ciò che ha scritto il modello. Sono fatturati a prezzi diversi, ed è il motivo per cui li stampiamo. Se la differenza è nuova per te, token di input vs output la spiega in cinque minuti.
Provalo tu stessoProva: imposta "max_tokens" a 5 ed esegui di nuovo. Cosa dice finish_reason?Mostra risposta
Nel formato OpenAI Chat Completions dice length. Il modello ha raggiunto il tuo limite e la frase è tagliata a metà. Con una risposta normale dice stop. Se vedi length in un job reale, alza max_tokens — questo articolo spiega la soluzione.
Quanto costa una richiesta#
Supponi di eseguire questa chiamata in un loop, una piccola domanda in ingresso e una risposta breve in uscita: 300 token di input e 200 token di output ciascuna. Su DeepSeek-V4-Flash sono $0.000025 per richiesta, dal prezzo live di $0.015 per 1M token di input e $0.10 per 1M token di output. Contati insieme, input e output, è più economico di OpenRouter, e il modello mantiene un contesto di 380K e risponde fino a 32.768 token.
La tabella sotto mostra la stessa richiesta su ogni modello, moltiplicata per 1.000.
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 token di input e 200 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
I prezzi sono nella pagina dei prezzi.
Cambiare modello#
Il codice non cambia quando cambia il modello; cambia solo la stringa in "model". Per esempio, zai- ha un contesto di 390K e risponde fino a 8.192 token. Per evitare del tutto di modificare il codice, leggi l'id da una seconda variabile con std::env::var("CHEAPTOKENS_. Se non sei sicuro di quali id veda la tua chiave, elenca i modelli con GET /v1/models.
Se non funziona#
environment variable not foundproprio all'inizio: la chiave non è esportata in questo terminale. Esportala di nuovo nella stessa finestra in cui eseguicargo run.- Un errore 401 dall'API: la chiave è sbagliata o ha uno spazio o una virgoletta di troppo.
- Un errore 404: controlla che la base URL termini con
/v1e che l'id del modello sia quello completo, con il prefissodeepseek-ai/. API 401 o 404: chiave, base URL, id modello lo illustra passo per passo. - Il compilatore non trova
create_byot: la featurebyotnon è abilitata. Esegui di nuovo la rigacargo adddella configurazione.
Per un problema di connessione che non rientra in nessuno di questi, vedi i comuni errori di connessione.
La stessa prima richiesta esiste per altri linguaggi: Go e Ruby. Per saperne di più sull'API stessa, apri la documentazione CheapTokens.


