400 dopo una tool call: rimanda indietro reasoning_content
Perché la seconda richiesta di un loop con tool call restituisce 400 su un modello thinking, una correzione in Python che aggiunge il messaggio completo e quando puoi evitarla.
In questa pagina
Il tuo loop dell'agente funziona alla prima richiesta e fallisce alla seconda con un 400. Su un modello thinking, una causa documentata è un campo mancante: il messaggio assistant che rimandi indietro ha perso il suo reasoning_. Se è questa la causa, aggiungere l'intero messaggio esattamente come lo ha restituito l'API lo risolve.
La guida alla modalità thinking di DeepSeek (docs, verificata l'8 novembre 2026) riassume la regola in una frase: quando la richiesta ha il parametro tools, reasoning_ deve essere rimandato indietro per intero in tutte le richieste successive, compresi i turni senza tool call. Altrimenti l'API restituisce 400. La stessa pagina dice che il thinking è attivo per impostazione predefinita, con effort high. Quindi un loop scritto per un modello non-thinking può rompersi senza che cambi una sola riga.
Cosa succede tra la prima e la seconda richiesta#
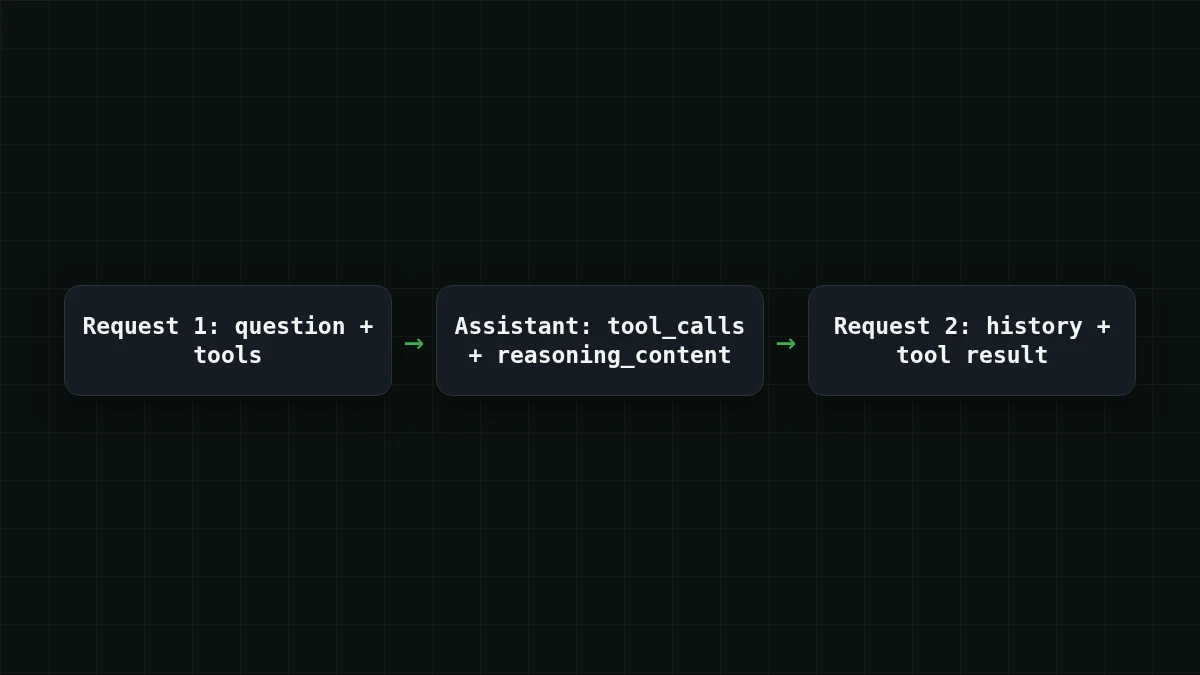
In modalità thinking la catena di pensiero torna in reasoning_, un campo allo stesso livello di content. Immagina il loop:
- Invii la domanda e la lista
tools. - Il modello risponde con
tool_calls(ereasoning_accanto).content - Esegui il tool e rimandi tutto indietro: la cronologia, il messaggio assistant e un messaggio
toolcon il risultato.
Il 400 arriva sulla richiesta del passo 3 se il messaggio assistant al suo interno non ha reasoning_.
La pagina di DeepSeek documenta il 400 solo per questo caso di tool call e non riporta un testo di errore, quindi quando verifichi se hai questo problema guarda lo stato HTTP, non un messaggio specifico.
La correzione: aggiungi il messaggio così come restituito#
La mossa più sicura è non ricostruire affatto il messaggio assistant. Prendilo dalla risposta e aggiungilo intero. Ecco un loop completo con l'SDK Python di OpenAI puntato su CheapTokens. Il tool meteo è uno stub, quindi puoi eseguirlo così com'è.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
La riga che conta è messages.. L'SDK conserva i campi che non conosce, quindi qualunque cosa l'API abbia messo sul messaggio, reasoning_ incluso, viaggia indietro con esso. Anche la risposta finale viene aggiunta, ed è ciò che chiede la regola: dopo la prima tool call, ogni richiesta successiva porta con sé il reasoning dei turni assistant precedenti.
La meccanica delle tool call in sé (schema, tool_call_id, parsing degli argomenti) è in Function calling in Python with an OpenAI-compatible API. La base URL, la chiave e l'id del modello sono sulla pagina dei docs di CheapTokens; il modello usato qui è descritto sulla pagina DeepSeek: contesto da 380K e fino a 32.768 token di output per risposta, il che lascia spazio per un thinking lungo più una risposta.
Un colpevole comune: un messaggio ricostruito a mano#
Un modo comune per perdere il campo è un codice che non aggiunge l'oggetto risposta ma costruisce un nuovo dict. Sembra innocuo: role, content, tool calls. I framework e i wrapper fanno lo stesso quando memorizzano la cronologia nel proprio formato. L'unico campo di cui non hanno mai sentito parlare è quello che va perso.
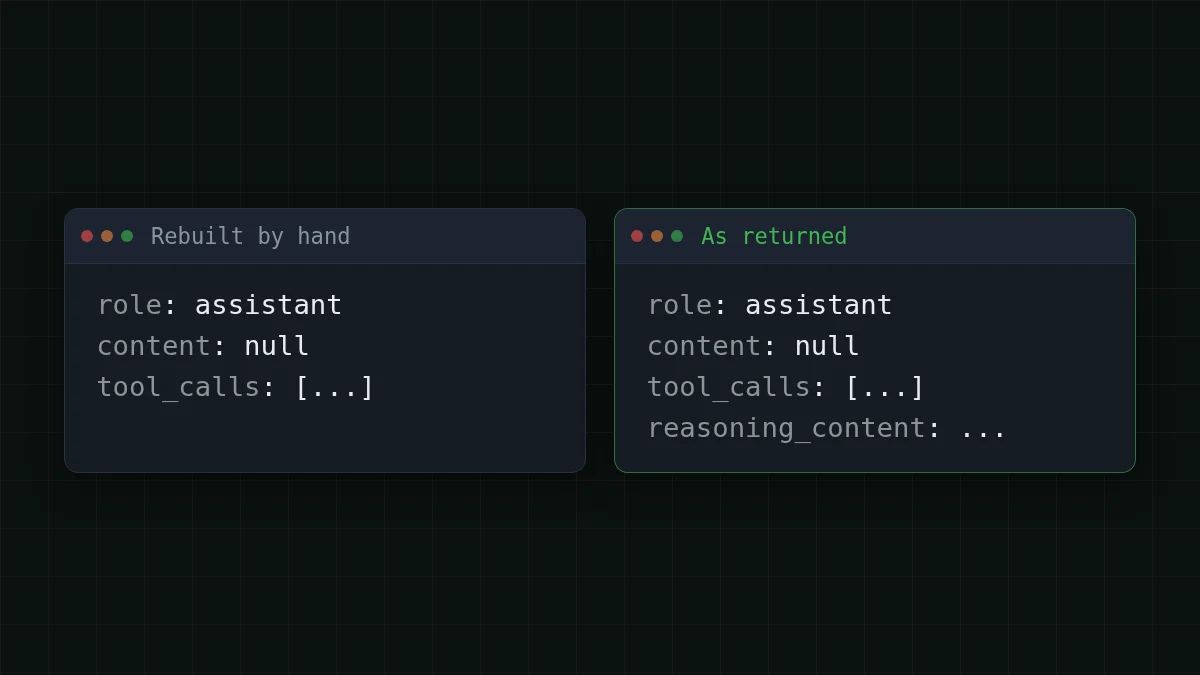
Confronta
Ricostruito a mano vs aggiunto intero
Ricostruito a mano (si rompe)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Aggiunto intero (funziona)
messages.append(msg.model_dump(exclude_none=True))Se usi un framework e non puoi toccare quella riga, controlla come memorizza i turni assistant. Una cronologia che passa attraverso un serializer che conserva solo content e tool_calls ha lo stesso bug, solo un livello più in basso.
Quando non ti serve#
Non ogni chiamata a un modello thinking richiede questa attenzione extra. Per una chat multi-turno senza tool, la guida di DeepSeek dice che reasoning_ non deve essere rimandato indietro; se lo invii comunque, viene ignorato e il reasoning precedente non viene aggiunto al contesto. Quindi una chat semplice può continuare a ometterlo senza che nulla si rompa.
Scegli il tuo caso
Qual è il tuo caso?
Scegli un'opzione per vedere la risposta
La richiesta ha tools, il modello fa thinking
Aggiungi l'intero messaggio assistant a ogni turno, sia nei turni con tool sia nelle risposte finali.
Chat semplice, senza parametro tools
Nessuna correzione necessaria. Puoi omettere reasoning_ dalla cronologia, oppure inviarlo; viene ignorato.
Un framework costruisce la cronologia per te
Trova dove serializza i messaggi assistant e assicurati che reasoning_ sopravviva. Se non è possibile, chiama l'API con il tuo loop per la parte relativa ai tool.
Un effetto collaterale da tenere a mente: la cronologia che rimandi è input a ogni richiesta, quindi un reasoning lungo in un loop lungo si accumula. Come vengono contati i token di thinking è trattato in Reasoning effort and thinking tokens, e cosa fare quando una richiesta supera i limiti del modello è in Request too long: 400 vs 413.
Se restituisce ancora 400#
Segui questo ordine:
- Stampa
messagessubito prima della chiamata che fallisce. Ogni messaggio assistant proveniente dal modello hareasoning_, se la risposta lo aveva?content - Ricostruisci un messaggio da qualche parte: un helper, una classe di cronologia, un
json.dumpse ritorno con una lista fissa di chiavi? - Il messaggio
toolper ognitool_call_idè presente, con lo stesso id? - È davvero la lunghezza? Una richiesta oltre il limite di contesto è un 400 diverso, descritto nell'articolo sopra.
Verifica rapida
Cosa aggiungi dopo che il modello chiede un tool?
Mostra risposta
Risposta: L'intero messaggio assistant così come restituito, reasoning_content incluso
Le tool_calls sono ciò a cui rispondono i tuoi messaggi tool, e con i tool nella richiesta il reasoning deve viaggiare insieme a loro.
Questa è tutta la correzione: un'aggiunta, nessuna ricostruzione. Aggiungi il limite di passi dell'esempio a ogni loop che rilasci, così un turno sbagliato costa cinque richieste, non cinquecento.


