FehlerbehebungAnleitung
400 nach einem Tool-Call: reasoning_content zurücksenden
Warum der zweite Request einer Tool-Call-Schleife bei einem Thinking-Modell 400 zurückgibt, eine Python-Lösung, die die vollständige Nachricht anhängt, und wann du sie überspringen kannst.
Auf dieser Seite
Deine Agent-Schleife funktioniert beim ersten Request und scheitert beim zweiten mit einem 400. Bei einem Thinking-Modell ist eine dokumentierte Ursache ein fehlendes Feld: Die Assistant-Nachricht, die du zurückschickst, hat ihr reasoning_ verloren. Wenn das die Ursache ist, behebt das Anhängen der gesamten Nachricht genau so, wie die API sie zurückgegeben hat, das Problem.
DeepSeeks Thinking-Mode-Guide (Doku, geprüft am 8. November 2026) fasst die Regel in einem Satz zusammen: Wenn der Request den Parameter tools hat, muss reasoning_ in allen folgenden Requests vollständig zurückgegeben werden, auch in Turns ohne Tool-Call. Andernfalls gibt die API 400 zurück. Dieselbe Seite sagt, dass Thinking standardmäßig aktiv ist, mit Effort high. Eine Schleife, die du für ein Nicht-Thinking-Modell geschrieben hast, kann also brechen, ohne dass sich eine einzige Zeile ändert.
Was zwischen Request eins und Request zwei passiert#
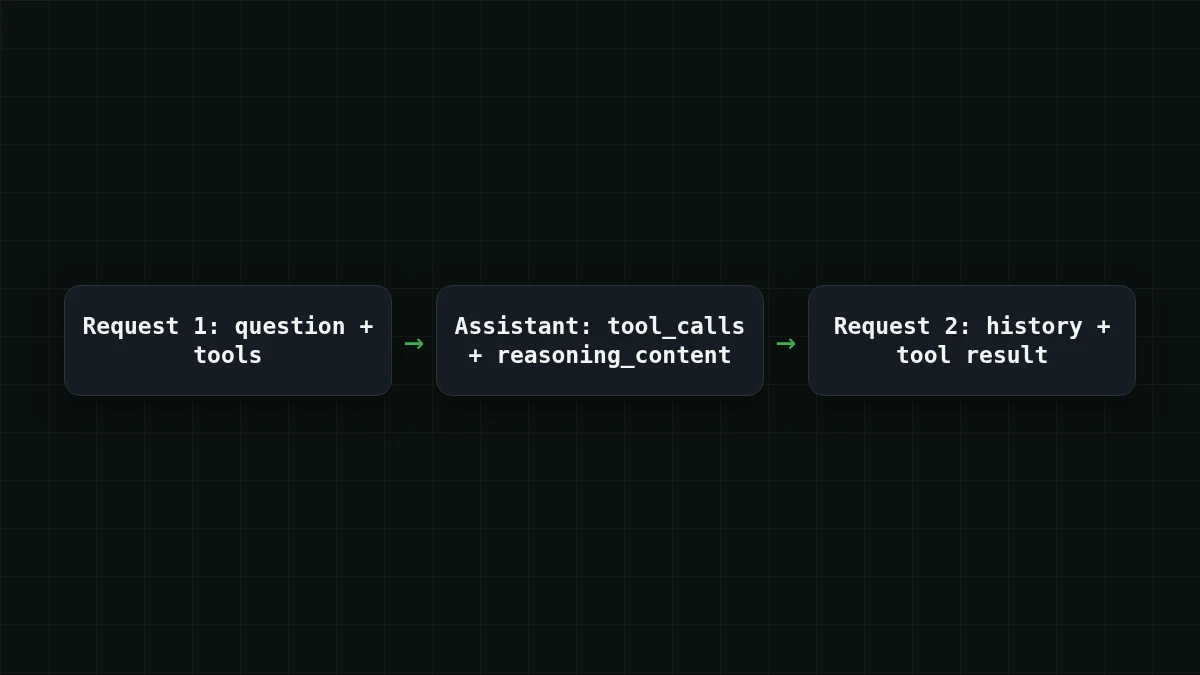
Im Thinking-Mode kommt die Gedankenkette in reasoning_ zurück, einem Feld auf derselben Ebene wie content. Stell dir die Schleife vor:
- Du sendest die Frage und die Liste
tools. - Das Modell antwortet mit
tool_calls(undreasoning_daneben).content - Du führst das Tool aus und sendest alles zurück: die Historie, die Assistant-Nachricht und eine
tool-Nachricht mit dem Ergebnis.
Das 400 kommt beim Request in Schritt 3, wenn die Assistant-Nachricht darin kein reasoning_ hat.
Die DeepSeek-Seite dokumentiert das 400 nur für diesen Tool-Call-Fall und zitiert keinen Fehlertext. Schau also auf den HTTP-Status, nicht auf eine bestimmte Meldung, wenn du prüfst, ob du dieses Problem hast.
Die Lösung: die Nachricht so anhängen, wie sie zurückkam#
Der sicherste Weg ist, die Assistant-Nachricht gar nicht neu zu bauen. Nimm sie aus der Response und hänge sie vollständig an. Hier ist eine vollständige Schleife mit dem OpenAI Python SDK, das auf CheapTokens zeigt. Das Weather-Tool ist ein Stub, du kannst sie also direkt ausführen.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
Die eine Zeile, auf die es ankommt, ist messages.. Das SDK behält Felder, die es nicht kennt, also reist alles, was die API auf die Nachricht gesetzt hat, inklusive reasoning_, mit ihr zurück. Auch die finale Antwort wird angehängt, was genau der Regel entspricht: Nach dem ersten Tool-Call trägt jeder spätere Request das Reasoning früherer Assistant-Turns mit.
Die Tool-Call-Mechanik selbst (Schema, tool_call_id, Argumente parsen) steht in Function calling in Python with an OpenAI-compatible API. Base-URL, Key und Modell-ID findest du auf der CheapTokens-Dokumentationsseite; das hier verwendete Modell ist auf der DeepSeek-Seite beschrieben: 380K Kontext und bis zu 32.768 Output-Tokens pro Antwort, was Platz für langes Thinking plus eine Antwort lässt.
Ein häufiger Übeltäter: eine von Hand neu gebaute Nachricht#
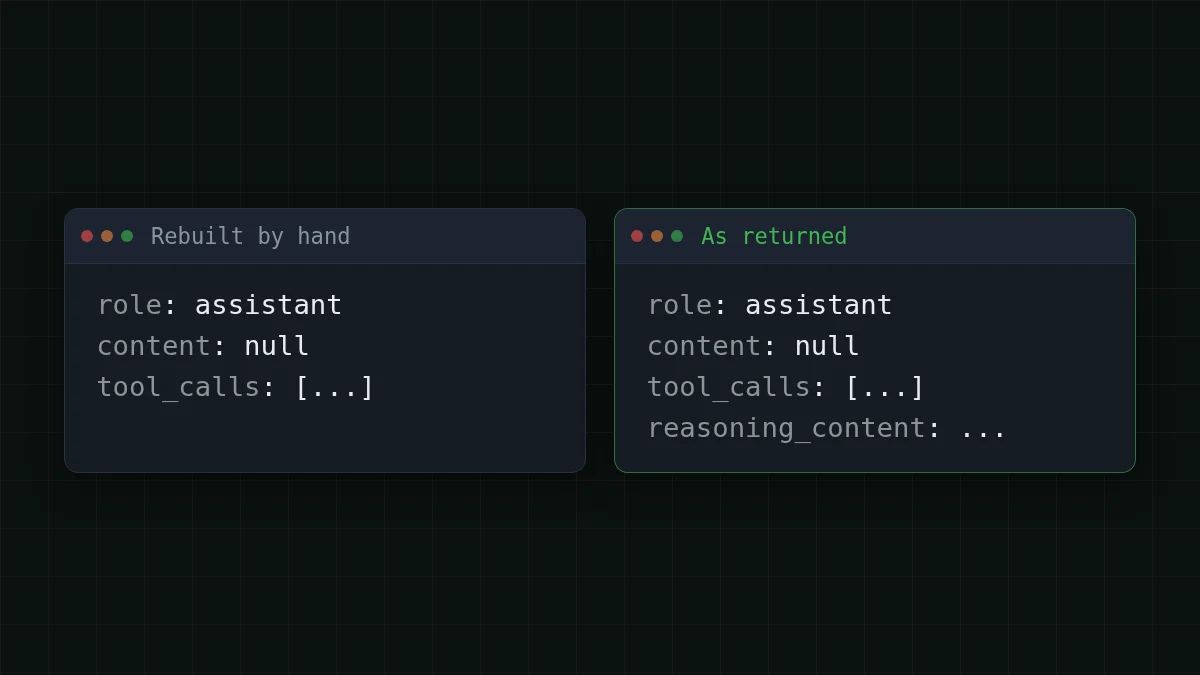
Ein häufiger Grund, das Feld zu verlieren, ist Code, der nicht das Response-Objekt anhängt, sondern ein neues Dict baut. Es sieht harmlos aus: role, content, tool calls. Frameworks und Wrapper machen dasselbe, wenn sie die Historie in ihrem eigenen Format speichern. Das eine Feld, von dem sie nie gehört haben, ist genau das, das fehlt.
Vergleichen
Von Hand neu gebaut vs. vollständig angehängt
Von Hand neu gebaut (bricht)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Vollständig angehängt (funktioniert)
messages.append(msg.model_dump(exclude_none=True))Wenn du ein Framework verwendest und diese Zeile nicht anfassen kannst, prüfe, wie es Assistant-Turns speichert. Eine Historie, die durch einen Serializer geht, der nur content und tool_calls behält, hat denselben Bug, nur eine Ebene tiefer.
Wann du das nicht brauchst#
Nicht jeder Aufruf eines Thinking-Modells braucht die zusätzliche Sorgfalt. Für Multi-Turn-Chat ohne Tools sagt DeepSeeks Guide, dass reasoning_ nicht zurückgegeben werden muss; wenn du es trotzdem sendest, wird es ignoriert und früheres Reasoning nicht zum Kontext hinzugefügt. Ein einfacher Chat kann es also weiterhin weglassen, und nichts bricht.
Wähle deinen Fall
Welcher Fall ist deiner?
Wähle eine Option, um die Antwort zu sehen
Der Request hat tools, das Modell denkt
Hänge in jedem Turn die gesamte Assistant-Nachricht an, bei Tool-Turns ebenso wie bei finalen Antworten.
Einfacher Chat, kein tools-Parameter
Keine Korrektur nötig. Du kannst reasoning_ aus der Historie weglassen oder senden; es wird ignoriert.
Ein Framework baut die Historie für dich
Finde heraus, wo es Assistant-Nachrichten serialisiert, und stelle sicher, dass reasoning_ überlebt. Wenn nicht, rufe die API für den Tool-Teil mit deiner eigenen Schleife auf.
Ein Nebeneffekt, den du im Blick behalten solltest: Die Historie, die du erneut sendest, ist bei jedem Request Input, also summiert sich langes Reasoning in einer langen Schleife. Wie Thinking-Tokens gezählt werden, steht in Reasoning effort and thinking tokens, und was zu tun ist, wenn ein Request die Grenzen des Modells überschreitet, in Request too long: 400 vs 413.
Wenn es immer noch 400 zurückgibt#
Geh das der Reihe nach durch:
- Gib
messagesdirekt vor dem fehlschlagenden Aufruf aus. Hat jede Assistant-Nachricht, die vom Modell kam,reasoning_, wenn die Response es hatte?content - Baust du irgendwo eine Nachricht neu: ein Helper, eine History-Klasse, ein
json.dumpsund zurück mit einer festen Liste von Keys? - Ist die
tool-Nachricht für jedentool_call_idvorhanden, mit derselben id? - Ist es wirklich die Länge? Ein Request über dem Kontextlimit ist ein anderes 400, beschrieben im Artikel oben.
Kurzer Check
Was hängst du an, nachdem das Modell ein Tool anfordert?
Antwort anzeigen
Antwort: Die gesamte Assistant-Nachricht so, wie sie zurückkam, inklusive reasoning_content
Die tool_calls sind das, worauf deine Tool-Nachrichten antworten, und wenn Tools im Request sind, muss das Reasoning mit ihnen mitreisen.
Das ist die ganze Lösung: ein Append, kein Neubauen. Füge das Schrittlimit aus dem Beispiel zu jeder Schleife hinzu, die du auslieferst, damit ein schlechter Turn fünf Requests kostet, nicht fünfhundert.


