Rozwiązywanie problemówPrzewodnik
400 po wywołaniu narzędzia: odeślij reasoning_content
Dlaczego drugie żądanie w pętli wywołań narzędzi zwraca 400 w modelu myślącym, poprawka w Pythonie dołączająca całą wiadomość i kiedy można to pominąć.
Na tej stronie
Twoja pętla agenta działa przy pierwszym żądaniu, a przy drugim kończy się błędem 400. W modelu myślącym jedną z udokumentowanych przyczyn jest brakujące pole: wiadomość asystenta, którą odsyłasz, zgubiła swoje reasoning_. Jeśli to jest przyczyna, dołączenie całej wiadomości dokładnie w takiej postaci, w jakiej zwróciło ją API, rozwiązuje problem.
Przewodnik DeepSeek po trybie myślenia (dokumentacja, sprawdzona 8 listopada 2026) ujmuje regułę w jednym zdaniu: gdy żądanie zawiera parametr tools, reasoning_ musi być odesłane w całości we wszystkich kolejnych żądaniach, także w turach bez wywołania narzędzia. W przeciwnym razie API zwraca 400. Ta sama strona mówi, że myślenie jest domyślnie włączone, z wysiłkiem high. Zatem pętla napisana dla modelu niemyślącego może się zepsuć bez zmiany choćby jednej linii.
Co dzieje się między pierwszym a drugim żądaniem#
W trybie myślenia łańcuch myśli wraca w reasoning_, polu na tym samym poziomie co content. Wyobraź sobie pętlę:
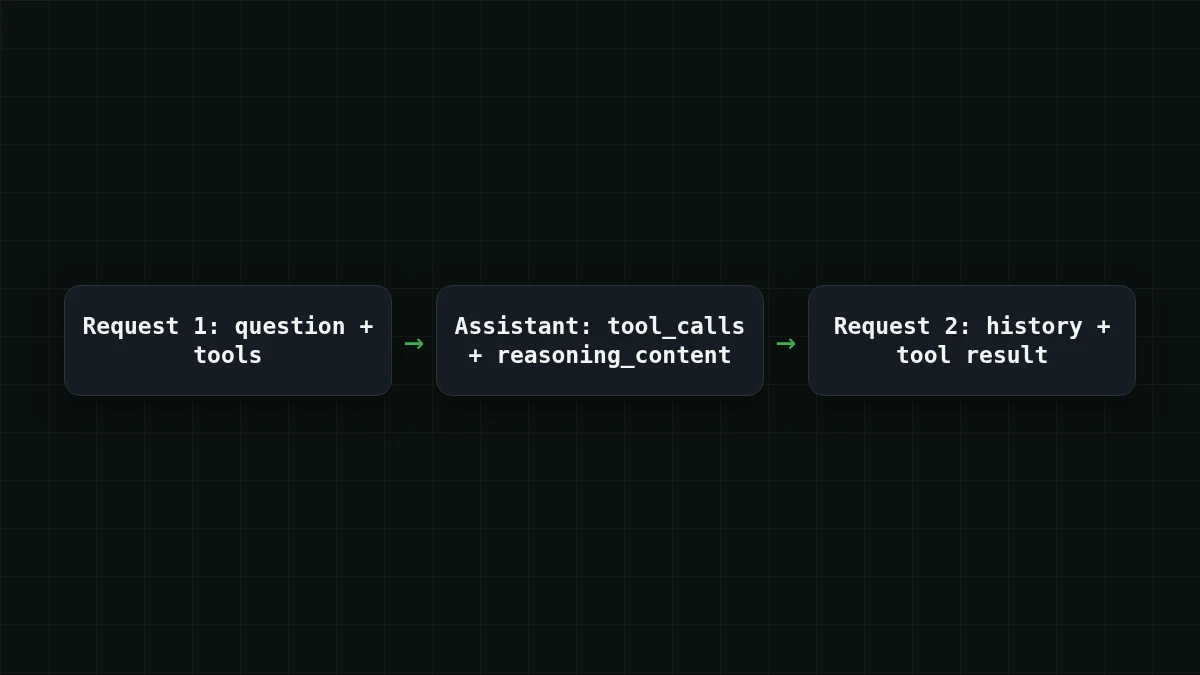
- Wysyłasz pytanie i listę
tools. - Model odpowiada
tool_calls(a obok nichreasoning_).content - Uruchamiasz narzędzie i odsyłasz wszystko: historię, wiadomość asystenta oraz wiadomość
toolz wynikiem.
Błąd 400 pojawia się przy żądaniu z kroku 3, jeśli zawarta w nim wiadomość asystenta nie ma reasoning_.
Strona DeepSeek dokumentuje błąd 400 tylko dla tego przypadku wywołania narzędzia i nie podaje treści błędu, więc sprawdzając, czy masz ten problem, patrz na status HTTP, a nie na konkretny komunikat.
Poprawka: dołącz wiadomość w postaci zwróconej#
Najbezpieczniejszym posunięciem jest w ogóle nie odbudowywać wiadomości asystenta. Weź ją z odpowiedzi i dołącz w całości. Oto kompletna pętla z OpenAI Python SDK skierowanym na CheapTokens. Narzędzie pogodowe to zaślepka, więc możesz uruchomić ją bez zmian.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
Jedna linia ma znaczenie: messages.. SDK zachowuje pola, o których nie wie, więc cokolwiek API umieściło na wiadomości, w tym reasoning_, wraca razem z nią. Ostateczna odpowiedź też jest dołączana, czego wymaga reguła: po pierwszym wywołaniu narzędzia każde późniejsze żądanie niesie rozumowanie wcześniejszych tur asystenta.
Sama mechanika wywołań narzędzi (schemat, tool_call_id, parsowanie argumentów) jest w Function calling in Python with an OpenAI-compatible API. Bazowy URL, klucz i identyfikator modelu są na stronie dokumentacji CheapTokens; użyty tu model jest opisany na stronie DeepSeek: kontekst 380K i do 32 768 tokenów wyjściowych na odpowiedź, co zostawia miejsce na długie myślenie plus odpowiedź.
Częsty winowajca: wiadomość odbudowana ręcznie#
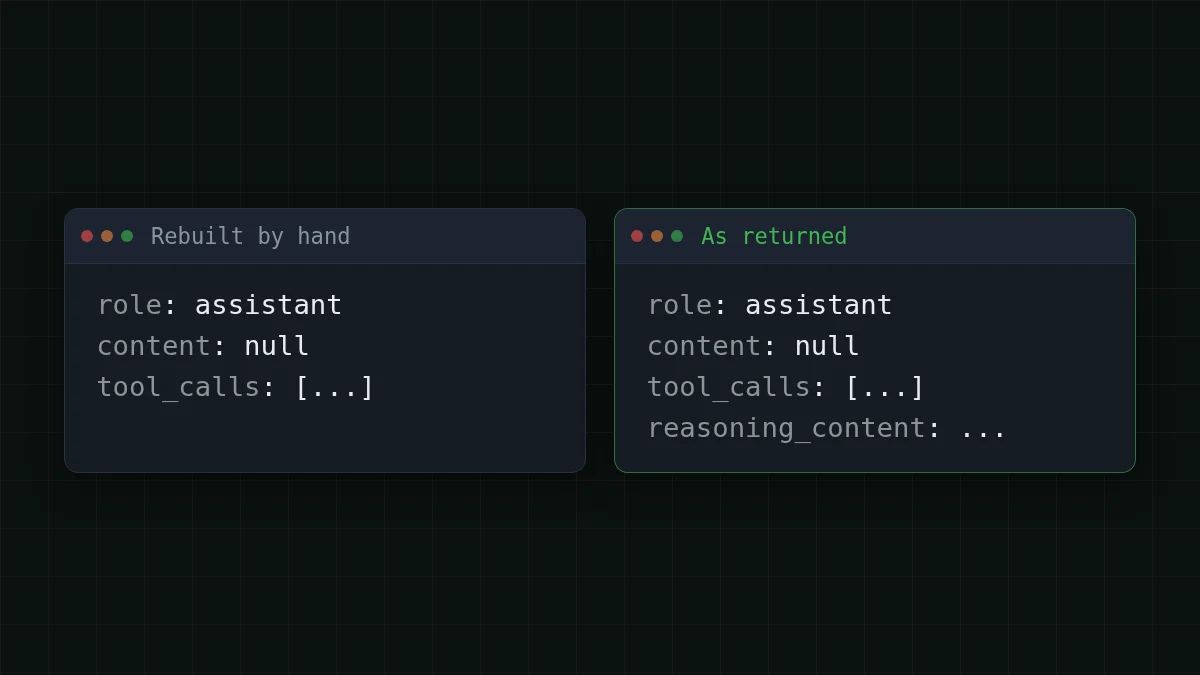
Częstym sposobem utraty pola jest kod, który nie dołącza obiektu odpowiedzi, lecz buduje nowy dict. Wygląda niewinnie: rola, treść, wywołania narzędzi. Frameworki i wrappery robią to samo, gdy przechowują historię we własnym formacie. Jedyne pole, o którym nie słyszały, to właśnie to, które ginie.
Porównaj
Odbudowana ręcznie vs dołączona w całości
Odbudowana ręcznie (psuje się)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
Dołączona w całości (działa)
messages.append(msg.model_dump(exclude_none=True))Jeśli używasz frameworka i nie możesz dotknąć tej linii, sprawdź, jak przechowuje tury asystenta. Historia przechodząca przez serializator, który zachowuje tylko content i tool_calls, ma ten sam błąd, tylko o warstwę niżej.
Kiedy tego nie potrzebujesz#
Nie każde wywołanie modelu myślącego wymaga dodatkowej ostrożności. Dla czatu wieloturowego bez narzędzi przewodnik DeepSeek mówi, że reasoning_ nie musi być odsyłane; jeśli i tak je wyślesz, jest ignorowane, a wcześniejsze rozumowanie nie jest dodawane do kontekstu. Zwykły czat może więc dalej je pomijać i nic się nie psuje.
Wybierz swój przypadek
Który przypadek jest twój?
Wybierz opcję, aby zobaczyć odpowiedź
Żądanie ma tools, model myśli
Dołączaj całą wiadomość asystenta w każdej turze, zarówno w turach narzędziowych, jak i w odpowiedziach końcowych.
Zwykły czat, bez parametru tools
Poprawka niepotrzebna. Możesz pominąć reasoning_ w historii albo je wysłać; jest ignorowane.
Framework buduje historię za ciebie
Znajdź miejsce, w którym serializuje wiadomości asystenta, i upewnij się, że reasoning_ przetrwa. Jeśli nie może, wywołuj API własną pętlą dla części narzędziowej.
Efekt uboczny, o którym warto pamiętać: odsyłana historia jest wejściem przy każdym żądaniu, więc długie rozumowanie w długiej pętli się sumuje. Jak liczone są tokeny myślenia, opisano w Reasoning effort and thinking tokens, a co robić, gdy żądanie przekracza limity modelu, w Request too long: 400 vs 413.
Jeśli nadal zwraca 400#
Przejdź przez to po kolei:
- Wypisz
messagestuż przed nieudanym wywołaniem. Czy każda wiadomość asystenta pochodząca z modelu mareasoning_, jeśli odpowiedź je miała?content - Czy gdziekolwiek odbudowujesz wiadomość: w helperze, klasie historii, przez
json.dumpsi z powrotem ze stałą listą kluczy? - Czy wiadomość
tooldla każdegotool_call_idjest obecna, z tym samym id? - Czy to naprawdę długość? Żądanie przekraczające limit kontekstu to inny błąd 400, opisany w powyższym artykule.
Szybkie sprawdzenie
Co dołączasz, gdy model prosi o narzędzie?
Pokaż odpowiedź
Odpowiedź: Całą wiadomość asystenta w postaci zwróconej, z reasoning_content
To na tool_calls odpowiadają twoje wiadomości narzędziowe, a przy narzędziach w żądaniu rozumowanie musi wędrować razem z nimi.
To cała poprawka: jedno dołączenie, bez odbudowywania. Dodaj limit kroków z przykładu do każdej wysyłanej pętli, żeby zła tura kosztowała pięć żądań, a nie pięćset.


