خرابیوں کا ازالہگائیڈ
ٹول کال کے بعد 400: reasoning_content واپس بھیجیں
ٹول کال لوپ کی دوسری درخواست thinking ماڈل پر 400 کیوں واپس کرتی ہے، ایک Python حل جو پورا پیغام شامل کرتا ہے، اور کب آپ اسے چھوڑ سکتے ہیں۔
اس صفحہ پر
آپ کا ایجنٹ لوپ پہلی درخواست پر کام کرتا ہے اور دوسری پر 400 کے ساتھ ناکام ہو جاتا ہے۔ کسی thinking ماڈل پر، ایک دستاویزی وجہ ایک غائب فیلڈ ہے: آپ جو اسسٹنٹ پیغام واپس بھیجتے ہیں اس نے اپنا reasoning_ کھو دیا ہے۔ اگر یہی وجہ ہو، تو پورا پیغام بالکل ویسے ہی شامل کرنا جیسے API نے واپس کیا تھا اسے ٹھیک کر دیتا ہے۔
DeepSeek کی thinking-mode گائیڈ (دستاویزات، 8 نومبر 2026 کو چیک کی گئی) اصول کو ایک جملے میں بیان کرتی ہے: جب درخواست میں tools پیرامیٹر ہو، تو reasoning_ کو تمام بعد کی درخواستوں میں مکمل طور پر واپس بھیجنا ہوتا ہے، بشمول ان موڑوں کے جن میں کوئی ٹول کال نہیں۔ ورنہ API 400 واپس کرتا ہے۔ وہی صفحہ کہتا ہے کہ thinking بطور ڈیفالٹ آن ہے، effort high کے ساتھ۔ تو ایک غیر-thinking ماڈل کے لیے لکھا گیا لوپ ایک بھی لائن بدلے بغیر ٹوٹ سکتا ہے۔
درخواست ایک اور درخواست دو کے درمیان کیا ہوتا ہے#
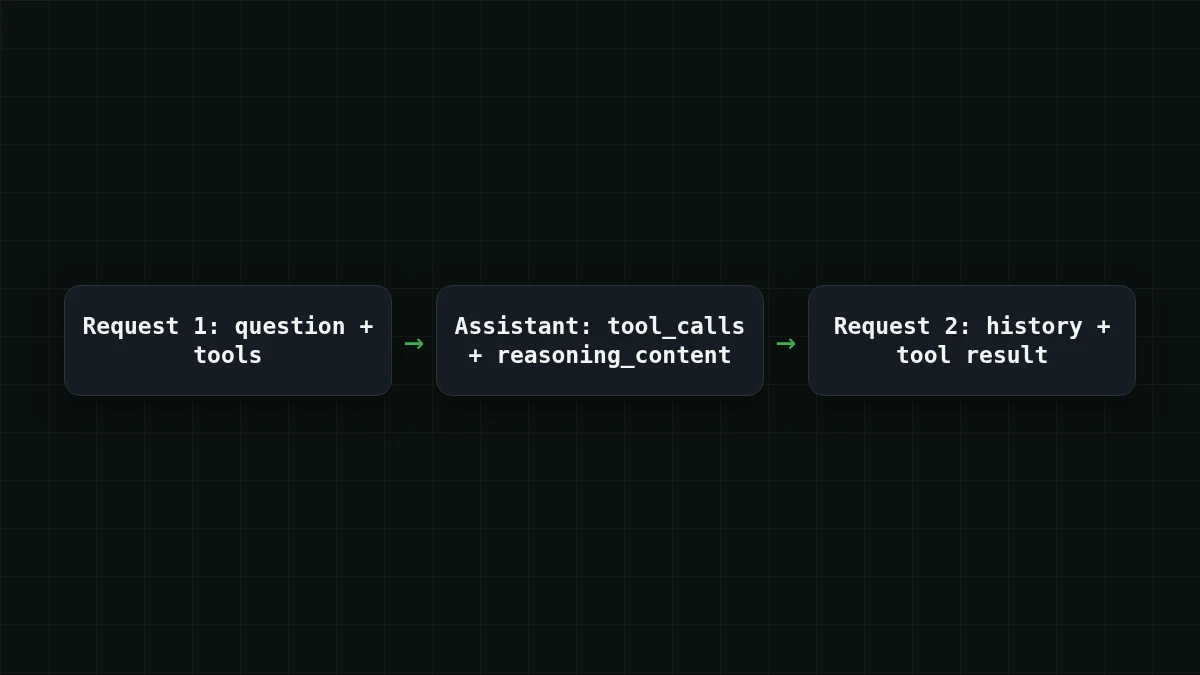
thinking موڈ میں سوچ کا سلسلہ reasoning_ میں واپس آتا ہے، جو content کے ساتھ اسی سطح پر ایک فیلڈ ہے۔ لوپ کا تصور کریں:
- آپ سوال اور
toolsفہرست بھیجتے ہیں۔ - ماڈل
tool_callsکے ساتھ جواب دیتا ہے (اور ان کے ساتھreasoning_)۔content - آپ ٹول چلاتے ہیں اور سب کچھ واپس بھیجتے ہیں: ہسٹری، اسسٹنٹ پیغام، اور نتیجے کے ساتھ ایک
toolپیغام۔
مرحلہ 3 کی درخواست پر 400 آتا ہے اگر اس میں موجود اسسٹنٹ پیغام میں reasoning_ نہ ہو۔
DeepSeek کا صفحہ 400 کو صرف اسی ٹول کال کیس کے لیے دستاویز کرتا ہے اور کوئی ایرر ٹیکسٹ نقل نہیں کرتا، تو جب آپ چیک کریں کہ آپ کو یہ مسئلہ ہے یا نہیں، تو HTTP اسٹیٹس دیکھیں، کسی مخصوص پیغام کو نہیں۔
حل: پیغام کو ویسے ہی شامل کریں جیسے واپس آیا#
سب سے محفوظ اقدام یہ ہے کہ اسسٹنٹ پیغام کو بالکل دوبارہ نہ بنائیں۔ اسے جواب سے لیں اور پورا شامل کریں۔ یہاں CheapTokens کی طرف اشارہ کردہ OpenAI Python SDK کے ساتھ ایک مکمل لوپ ہے۔ موسم کا ٹول ایک stub ہے، تو آپ اسے ویسے ہی چلا سکتے ہیں۔
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
اہم لائن messages. ہے۔ SDK ان فیلڈز کو رکھتا ہے جن کے بارے میں اسے علم نہیں، تو API نے پیغام پر جو کچھ بھی رکھا، reasoning_ سمیت، اس کے ساتھ واپس سفر کرتا ہے۔ حتمی جواب بھی شامل کیا جاتا ہے، جو اصول کا تقاضا ہے: پہلی ٹول کال کے بعد، ہر بعد کی درخواست پہلے کے اسسٹنٹ موڑوں کی reasoning ساتھ لے کر جاتی ہے۔
ٹول کال کی میکانیات خود (schema، tool_call_id، arguments کی پارسنگ) Function calling in Python with an OpenAI-compatible API میں ہیں۔ base URL، key اور model id CheapTokens docs page پر ہیں؛ یہاں استعمال شدہ ماڈل DeepSeek page پر بیان کیا گیا ہے: 380K context اور فی جواب زیادہ سے زیادہ 32,768 آؤٹ پٹ ٹوکنز، جو طویل thinking کے ساتھ ایک جواب کے لیے گنجائش چھوڑتا ہے۔
ایک عام مجرم: ہاتھ سے دوبارہ بنایا گیا پیغام#
فیلڈ کھونے کا ایک عام طریقہ وہ کوڈ ہے جو response آبجیکٹ شامل نہیں کرتا بلکہ ایک نیا dict بناتا ہے۔ یہ بے ضرر لگتا ہے: role، content، tool calls۔ فریم ورکس اور ریپرز بھی ایسا ہی کرتے ہیں جب وہ ہسٹری اپنی فارمیٹ میں محفوظ کرتے ہیں۔ وہ ایک فیلڈ جس کے بارے میں انہوں نے کبھی نہیں سنا، وہی ہے جو غائب ہو جاتی ہے۔
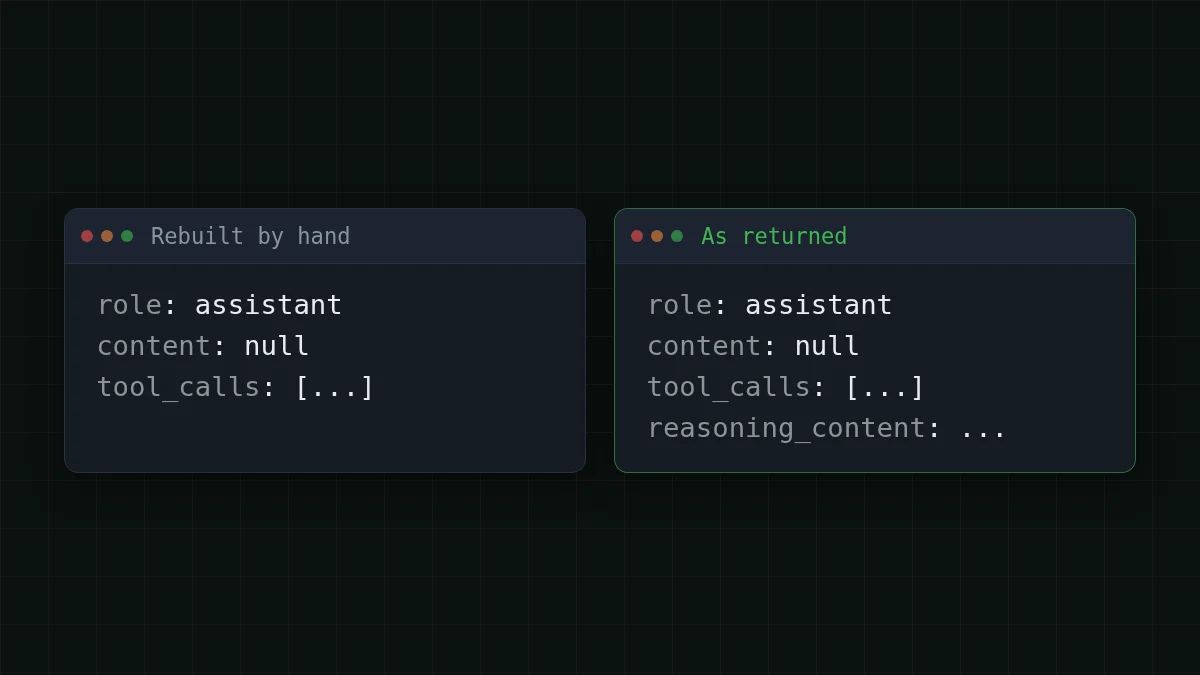
موازنہ کریں
ہاتھ سے دوبارہ بنایا گیا بمقابلہ پورا شامل کیا گیا
ہاتھ سے دوبارہ بنایا گیا (ٹوٹتا ہے)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
پورا شامل کیا گیا (کام کرتا ہے)
messages.append(msg.model_dump(exclude_none=True))اگر آپ کوئی فریم ورک استعمال کرتے ہیں اور اس لائن کو چھو نہیں سکتے، تو دیکھیں کہ وہ اسسٹنٹ موڑ کیسے محفوظ کرتا ہے۔ ایسی ہسٹری جو ایسے serializer سے گزرتی ہے جو صرف content اور tool_calls رکھتا ہے، اسی بگ کا شکار ہے، بس ایک پرت نیچے۔
جب آپ کو اس کی ضرورت نہیں#
ہر thinking-model کال کو اس اضافی احتیاط کی ضرورت نہیں۔ ٹولز کے بغیر ملٹی ٹرن چیٹ کے لیے، DeepSeek کی گائیڈ کہتی ہے کہ reasoning_ کو واپس بھیجنے کی ضرورت نہیں؛ اگر آپ پھر بھی بھیجیں، تو اسے نظر انداز کر دیا جاتا ہے اور پہلے کی reasoning context میں شامل نہیں ہوتی۔ تو ایک سادہ چیٹ اسے گراتا رہ سکتا ہے اور کچھ نہیں ٹوٹتا۔
اپنا کیس منتخب کریں
آپ کا کیس کون سا ہے؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
درخواست میں tools ہے، ماڈل thinking کر رہا ہے
ہر موڑ پر پورا اسسٹنٹ پیغام شامل کریں، ٹول موڑ اور حتمی جوابات یکساں۔
سادہ چیٹ، کوئی tools پیرامیٹر نہیں
کوئی حل درکار نہیں۔ آپ ہسٹری سے reasoning_ گرا سکتے ہیں، یا بھیج سکتے ہیں؛ اسے نظر انداز کر دیا جاتا ہے۔
ایک فریم ورک آپ کے لیے ہسٹری بناتا ہے
وہ جگہ تلاش کریں جہاں وہ اسسٹنٹ پیغامات کو serialize کرتا ہے اور یقینی بنائیں کہ reasoning_ بچ جاتا ہے۔ اگر ایسا نہیں ہو سکتا، تو ٹول والے حصے کے لیے اپنے لوپ سے API کال کریں۔
ایک ضمنی اثر ذہن میں رکھیں: آپ جو ہسٹری دوبارہ بھیجتے ہیں وہ ہر درخواست پر input ہے، تو طویل لوپ میں طویل reasoning جمع ہوتی جاتی ہے۔ thinking ٹوکنز کیسے گنے جاتے ہیں یہ Reasoning effort and thinking tokens میں ہے، اور جب کوئی درخواست ماڈل کی حدود سے بڑھ جائے تو کیا کریں یہ Request too long: 400 vs 413 میں ہے۔
اگر پھر بھی 400 واپس آئے#
اسے ترتیب سے دیکھیں:
- ناکام کال سے ٹھیک پہلے
messagesپرنٹ کریں۔ کیا ماڈل سے آنے والے ہر اسسٹنٹ پیغام میںreasoning_ہے، اگر جواب میں وہ تھا؟content - کیا آپ کہیں پیغام دوبارہ بناتے ہیں: کوئی helper، کوئی history class،
json.dumpsاور واپس keys کی مقررہ فہرست کے ساتھ؟ - کیا ہر
tool_call_idکے لیےtoolپیغام موجود ہے، اسی id کے ساتھ؟ - کیا واقعی لمبائی کا مسئلہ ہے؟ context حد سے بڑھی درخواست ایک مختلف 400 ہے، جو اوپر کے مضمون میں بیان کیا گیا ہے۔
فوری جانچ
ماڈل کے ٹول مانگنے کے بعد آپ کیا شامل کرتے ہیں؟
جواب دکھائیں
جواب: پورا اسسٹنٹ پیغام جیسے واپس آیا، reasoning_content سمیت
tool_calls وہی ہیں جن کا جواب آپ کے tool messages دیتے ہیں، اور درخواست میں ٹولز کے ساتھ reasoning کو ان کے ساتھ چلنا ہوتا ہے۔
یہی پورا حل ہے: ایک append، کوئی دوبارہ تعمیر نہیں۔ مثال سے step limit کو ہر اس لوپ میں شامل کریں جو آپ شپ کرتے ہیں، تاکہ ایک خراب موڑ پانچ درخواستوں کا خرچ ہو، پانچ سو کا نہیں۔


