문제 해결가이드
도구 호출 후 400: reasoning_content를 다시 보내기
사고 모델에서 도구 호출 루프의 두 번째 요청이 400을 반환하는 이유, 전체 메시지를 덧붙이는 Python 수정, 그리고 생략해도 되는 경우.
이 페이지의 내용
에이전트 루프가 첫 번째 요청에서는 동작하고 두 번째 요청에서 400으로 실패합니다. 사고 모델에서 문서화된 원인 중 하나는 누락된 필드입니다. 다시 보내는 assistant 메시지에서 reasoning_가 사라진 것입니다. 이것이 원인이라면, API가 반환한 그대로 메시지 전체를 덧붙이면 해결됩니다.
DeepSeek의 사고 모드 가이드(문서, 2026년 11월 8일 확인)는 이 규칙을 한 문장으로 정리합니다. 요청에 tools 파라미터가 있으면 reasoning_를 이후 모든 요청에서 전체 그대로 다시 전달해야 하며, 도구 호출이 없는 턴도 포함됩니다. 그렇지 않으면 API가 400을 반환합니다. 같은 페이지에 따르면 사고는 기본으로 켜져 있고 effort는 high입니다. 따라서 사고 모델이 아닌 모델용으로 작성한 루프는 한 줄도 바꾸지 않아도 깨질 수 있습니다.
첫 번째 요청과 두 번째 요청 사이에 일어나는 일#
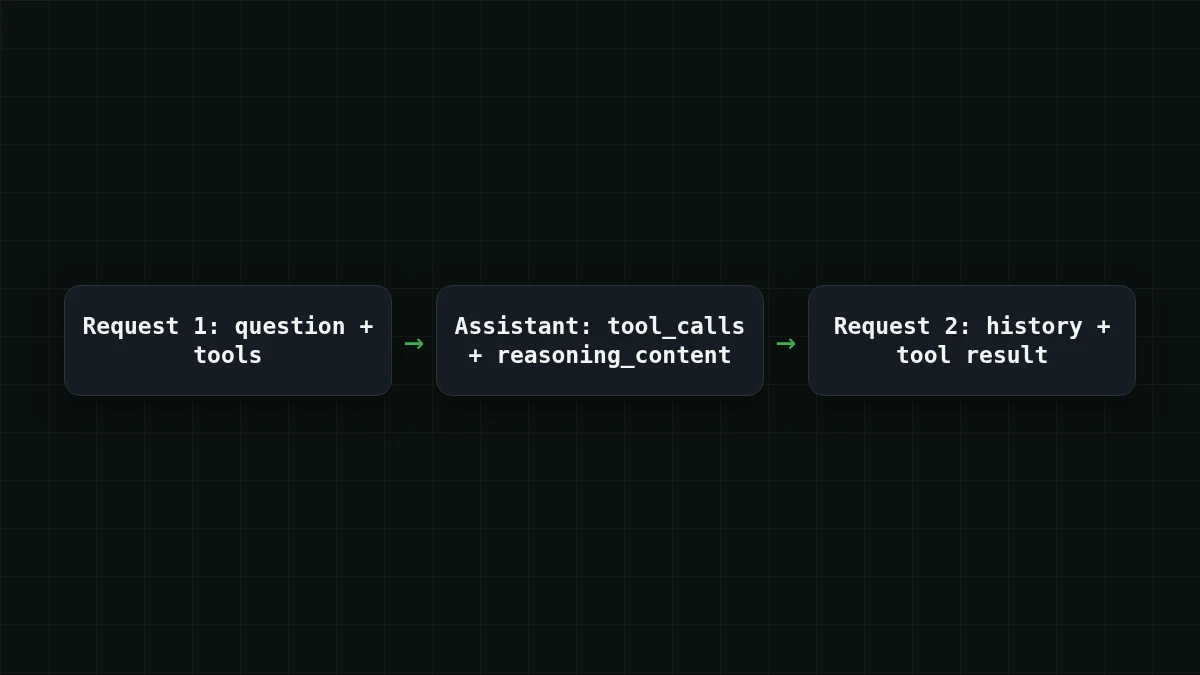
사고 모드에서는 사고의 연쇄가 reasoning_로 반환되며, 이는 content와 같은 레벨의 필드입니다. 루프를 그려 보겠습니다.
- 질문과
tools목록을 보냅니다. - 모델이
tool_calls로 응답합니다(그 옆에reasoning_도 함께).content - 도구를 실행하고 모든 것을 다시 보냅니다. 히스토리, assistant 메시지, 그리고 결과를 담은
tool메시지입니다.
3단계의 요청에서 그 안의 assistant 메시지에 reasoning_가 없으면 400이 발생합니다.
DeepSeek 페이지는 이 도구 호출 사례에 대해서만 400을 문서화하고 오류 텍스트를 인용하지 않으므로, 이 문제가 있는지 확인할 때는 특정 메시지가 아니라 HTTP 상태를 보십시오.
해결책: 반환된 그대로 메시지 덧붙이기#
가장 안전한 방법은 assistant 메시지를 다시 만들지 않는 것입니다. 응답에서 가져와 통째로 덧붙이십시오. 다음은 CheapTokens를 가리키는 OpenAI Python SDK를 사용한 완전한 루프입니다. 날씨 도구는 스텁이므로 그대로 실행할 수 있습니다.
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
중요한 한 줄은 messages.입니다. SDK는 알지 못하는 필드도 보존하므로, API가 메시지에 넣은 것은 무엇이든 reasoning_를 포함해 함께 다시 전달됩니다. 최종 답변도 덧붙이며, 이는 규칙이 요구하는 바입니다. 첫 도구 호출 이후의 모든 요청은 이전 assistant 턴의 추론을 함께 전달합니다.
도구 호출 메커니즘 자체(스키마, tool_call_id, 인자 파싱)는 OpenAI 호환 API로 Python에서 함수 호출하기에 있습니다. base URL, 키, 모델 id는 CheapTokens 문서 페이지에 있고, 여기서 사용한 모델은 DeepSeek 페이지에 설명되어 있습니다. 380K 컨텍스트와 답변당 최대 32,768 출력 토큰으로, 긴 사고와 답변을 위한 여유가 있습니다.
흔한 원인: 손으로 다시 만든 메시지#
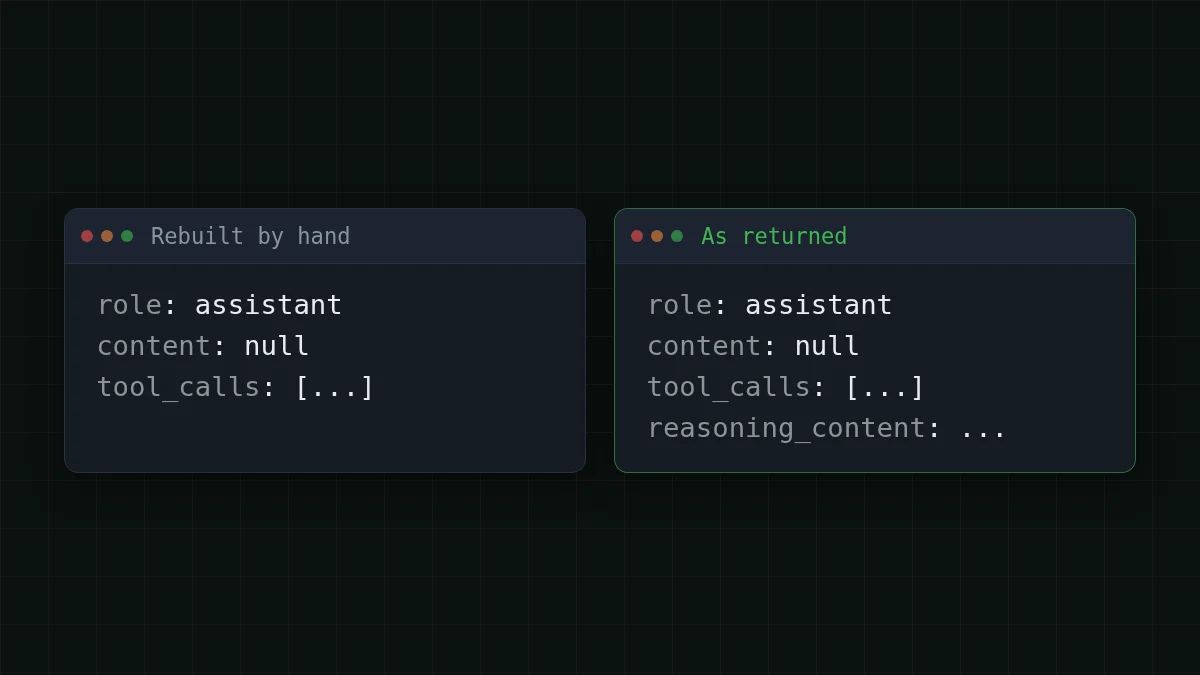
이 필드를 잃는 흔한 방법은 응답 객체를 덧붙이지 않고 새 dict를 만드는 코드입니다. role, content, tool_calls만 있으니 무해해 보입니다. 프레임워크와 래퍼도 히스토리를 자체 형식으로 저장할 때 같은 일을 합니다. 그들이 들어본 적 없는 바로 그 필드가 사라지는 것입니다.
비교하기
손으로 다시 만들기 vs 통째로 덧붙이기
손으로 다시 만들기 (깨짐)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
통째로 덧붙이기 (동작함)
messages.append(msg.model_dump(exclude_none=True))프레임워크를 사용하고 그 줄을 건드릴 수 없다면, assistant 턴을 어떻게 저장하는지 확인하십시오. content와 tool_calls만 유지하는 직렬화기를 거치는 히스토리도 같은 버그이며, 단지 한 계층 아래에 있을 뿐입니다.
이것이 필요 없는 경우#
모든 사고 모델 호출에 이 추가 주의가 필요한 것은 아닙니다. 도구 없는 멀티턴 채팅의 경우 DeepSeek 가이드는 reasoning_를 다시 전달할 필요가 없다고 말합니다. 그래도 보내면 무시되고 이전 추론은 컨텍스트에 추가되지 않습니다. 따라서 일반 채팅은 계속 이것을 버려도 아무것도 깨지지 않습니다.
사례 선택하기
어떤 경우인가요?
답을 보려면 옵션을 선택하세요
요청에 tools가 있고 모델이 사고 중
도구 턴과 최종 답변 모두, 매 턴 assistant 메시지 전체를 덧붙이십시오.
일반 채팅, tools 파라미터 없음
수정이 필요 없습니다. 히스토리에서 reasoning_를 버리거나 보내도 됩니다. 무시됩니다.
프레임워크가 히스토리를 대신 만듦
assistant 메시지를 직렬화하는 곳을 찾아 reasoning_가 살아남는지 확인하십시오. 그럴 수 없다면 도구 부분은 자체 루프로 API를 호출하십시오.
염두에 둘 부작용이 있습니다. 다시 보내는 히스토리는 매 요청의 입력이므로, 긴 루프에서 긴 추론은 누적됩니다. 사고 토큰이 어떻게 계산되는지는 추론 effort와 사고 토큰에, 요청이 모델 한도를 넘어설 때 무엇을 해야 하는지는 요청이 너무 김: 400 vs 413에 있습니다.
그래도 400이 반환되면#
다음을 순서대로 확인하십시오.
- 실패하는 호출 직전에
messages를 출력하십시오. 모델에서 온 모든 assistant 메시지에, 응답에 있었다면reasoning_가 있습니까?content - 어딘가에서 메시지를 다시 만드십니까? 헬퍼, 히스토리 클래스, 고정된 키 목록으로
json.dumps했다가 되돌리는 곳이 있습니까? - 모든
tool_call_id에 대한tool메시지가 같은 id로 존재합니까? - 정말 길이 문제입니까? 컨텍스트 한도를 넘는 요청은 위 문서에 설명된 다른 400입니다.
빠른 확인
모델이 도구를 요청한 뒤 무엇을 덧붙이십니까?
정답 보기
정답: reasoning_content를 포함해 반환된 그대로의 assistant 메시지 전체
tool_calls는 도구 메시지가 응답하는 대상이며, 요청에 도구가 있으면 추론이 그들과 함께 따라가야 합니다.
이것이 수정의 전부입니다. 덧붙이기 한 번, 다시 만들지 않기. 예제의 단계 제한을 배포하는 모든 루프에 추가하여, 잘못된 턴이 500번이 아니라 5번의 요청만 들게 하십시오.


