故障排查指南
工具调用后返回 400:把 reasoning_content 发回去
为什么工具调用循环的第二次请求在思考模型上返回 400,一个追加完整消息的 Python 修复方法,以及何时可以跳过它。
你的 agent 循环在第一次请求时正常,第二次却返回 400。在思考模型上,一个已有文档记载的原因是缺少字段:你回传的 assistant 消息丢失了它的 reasoning_。如果原因正是这个,那么把 API 返回的整条消息原样追加回去即可修复。
DeepSeek 的思考模式指南(文档,查阅于 2026 年 11 月 8 日)用一句话给出了规则:当请求带有 tools 参数时,reasoning_ 必须在后续所有请求中完整回传,包括没有工具调用的轮次。否则 API 返回 400。同一页面还说明思考默认开启,effort 为 high。因此,你为非思考模型写的循环可能一行代码都没改就坏了。
第一次请求和第二次请求之间发生了什么#
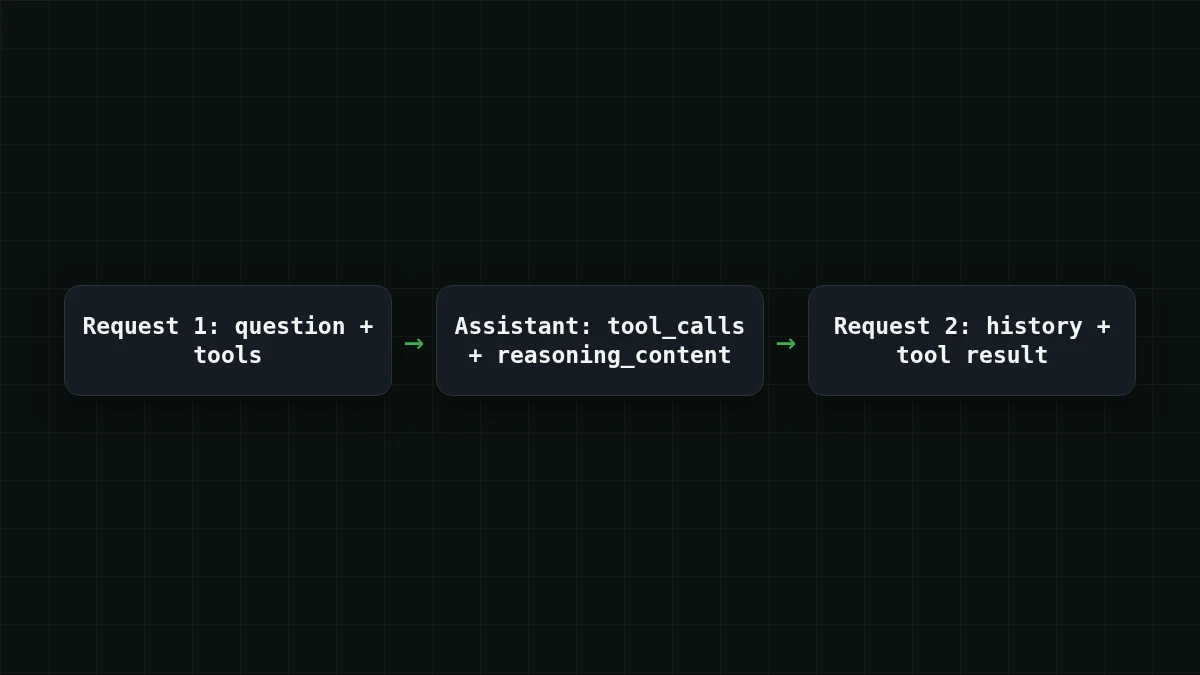
在思考模式下,思维链通过 reasoning_ 返回,该字段与 content 处于同一层级。设想这个循环:
- 你发送问题和
tools列表。 - 模型用
tool_calls回答(旁边还有reasoning_)。content - 你运行工具并把所有内容发回去:历史记录、assistant 消息,以及一条带有结果的
tool消息。
如果第 3 步请求中的 assistant 消息没有 reasoning_,400 就会出现在该请求上。
DeepSeek 页面只针对这个工具调用场景记录了 400,且没有引用错误文本,所以当你检查自己是否有这个问题时,要看 HTTP 状态码,而不是某条具体消息。
修复方法:按返回原样追加消息#
最稳妥的做法是完全不重建 assistant 消息。从响应中取出它并整体追加。下面是一个完整循环,使用指向 CheapTokens 的 OpenAI Python SDK。天气工具是桩实现,因此你可以直接运行。
import json, os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)
MODEL = "deepseek-ai/DeepSeek-V4-Flash-0731"

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Current weather for a city",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}]

def get_weather(city):
    return {"city": city, "temp_c": 7}  # stub

messages = [{"role": "user", "content": "Do I need a jacket in Oslo today?"}]

for _ in range(5):  # hard step limit
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))  # the whole message
    if not msg.tool_calls:
        print(msg.content)
        break
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(get_weather(**args)),
        })
关键的一行是 messages.。SDK 会保留它不认识的字段,因此 API 放在消息上的任何内容,包括 reasoning_,都会随它一起回传。最终答案也会被追加,这正是规则要求的:在第一次工具调用之后,后续每次请求都携带先前 assistant 轮次的推理内容。
工具调用机制本身(schema、tool_call_id、解析参数)见 Function calling in Python with an OpenAI-compatible API。base URL、key 和模型 id 在 CheapTokens 文档页上;这里使用的模型在 DeepSeek 页面上有描述:380K 上下文,每次回答最多 32,768 个输出 token,这为长思考加回答留出了空间。
常见元凶:手工重建的消息#
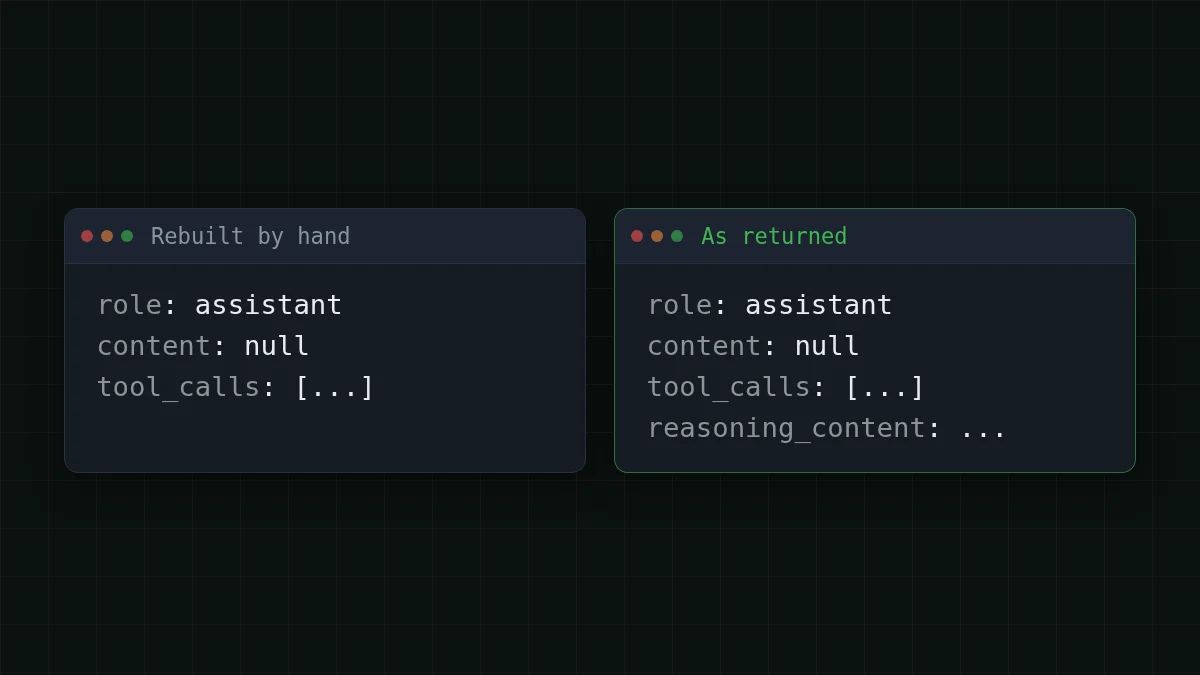
丢失该字段的一种常见方式是代码不追加响应对象,而是构建一个新的 dict。它看起来无害:role、content、tool calls。框架和包装器在用自己的格式存储历史时也会这样做。它们从未听说过的那个字段,正是会丢失的那个。
比较
手工重建 vs 整体追加
手工重建(会坏)
messages.append({
    "role": "assistant",
    "content": msg.content,
    "tool_calls": [c.model_dump() for c in msg.tool_calls],
})
整体追加(可用)
messages.append(msg.model_dump(exclude_none=True))如果你使用框架且无法改动那一行,检查它如何存储 assistant 轮次。经过只保留 content 和 tool_calls 的序列化器的历史记录有同样的 bug,只是低了一层。
何时不需要这样做#
并非每次思考模型调用都需要额外小心。对于没有工具的多轮聊天,DeepSeek 的指南说 reasoning_ 不必回传;如果你仍然发送它,它会被忽略,先前的推理不会加入上下文。因此普通聊天可以继续丢弃它,不会出问题。
选择你的情况
你属于哪种情况?
选择一个选项以查看答案
请求带有 tools,模型在思考
每一轮都追加完整的 assistant 消息,工具轮次和最终答案都一样。
普通聊天,没有 tools 参数
无需修复。你可以从历史中丢弃 reasoning_,也可以发送它;它会被忽略。
框架替你构建历史
找到它序列化 assistant 消息的位置,确保 reasoning_ 能保留下来。如果无法保留,就用自己的循环调用 API 来处理工具部分。
需要记住的一个副作用:你重新发送的历史在每次请求中都是输入,因此长循环中的长推理会累积。思考 token 如何计数见 Reasoning effort and thinking tokens,请求增长超过模型限制时该怎么办见 Request too long: 400 vs 413。
如果仍然返回 400#
按顺序检查以下各项:
- 在失败调用之前立即打印
messages。如果响应中有reasoning_,那么每条来自模型的 assistant 消息是否都有它?content - 你是否在任何地方重建消息:辅助函数、历史类、
json.dumps并用固定键列表转回? - 每个
tool_call_id对应的tool消息是否都存在,且 id 相同? - 真的是长度问题吗?超过上下文限制的请求是另一种 400,上文文章中有描述。
快速检查
模型请求工具后,你追加什么?
显示答案
答案: 按返回原样的完整 assistant 消息,包含 reasoning_content
tool_calls 正是你的工具消息所回应的内容,而请求中有工具时,推理必须随它们一起传递。
这就是全部修复:一次追加,不重建。把示例中的步骤上限加到你要发布的任何循环中,这样一次坏轮次只会花费五次请求,而不是五百次。


