在廉价模型上使用 Browser Use:base_url 设置和运行成本
将 Browser Use 连接到 OpenAI 兼容 API,在真实浏览器中运行价格检查任务,并估算一次运行的成本。
Browser Use 接受任何 OpenAI 兼容端点,因此将它连接到 CheapTokens 需要三个值:base_url、你的密钥和完整模型 id。下面是一个 agent.py,它会打开产品页面、读取价格并报告,同时按实时价格估算一次运行的成本。
浏览器代理在每一步都会把页面文本重新发送给模型,因此估算先于计划。
安装并指向 API#
Browser Use 的 README(2026 年 11 月 8 日检查)使用 uv 安装;该库需要 Python 3.11+,采用 MIT 许可证。文档的支持模型页面展示了自定义端点的模式:使用 base_url 的 ChatOpenAI,然后 Agent(task=.。
uv init --python 3.12
uv add browser-use
将密钥放在脚本旁边的 .env 文件中,绝不要放在代码里:
CHEAPTOKENS_API_KEY=your-key-here然后 agent.py:
import asyncio
import os

from dotenv import load_dotenv
from browser_use import Agent, ChatOpenAI

load_dotenv()

llm = ChatOpenAI(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.getenv('CHEAPTOKENS_API_KEY'),
)

task = (
    'Open https://shop.example/laptop-x (replace with your product page). '
    'Find the current price and whether it is in stock. '
    'Reply with one line: price, currency, in stock yes/no. '
    'Do not click Buy or add anything to the cart.'
)

agent = Agent(task=task, llm=llm)
asyncio.run(agent.run())
用 uv run agent.py 运行它。如果首次运行提示缺少浏览器,请按 Browser Use 快速入门 所示安装(uvx browser-,2026 年 11 月 8 日检查)。
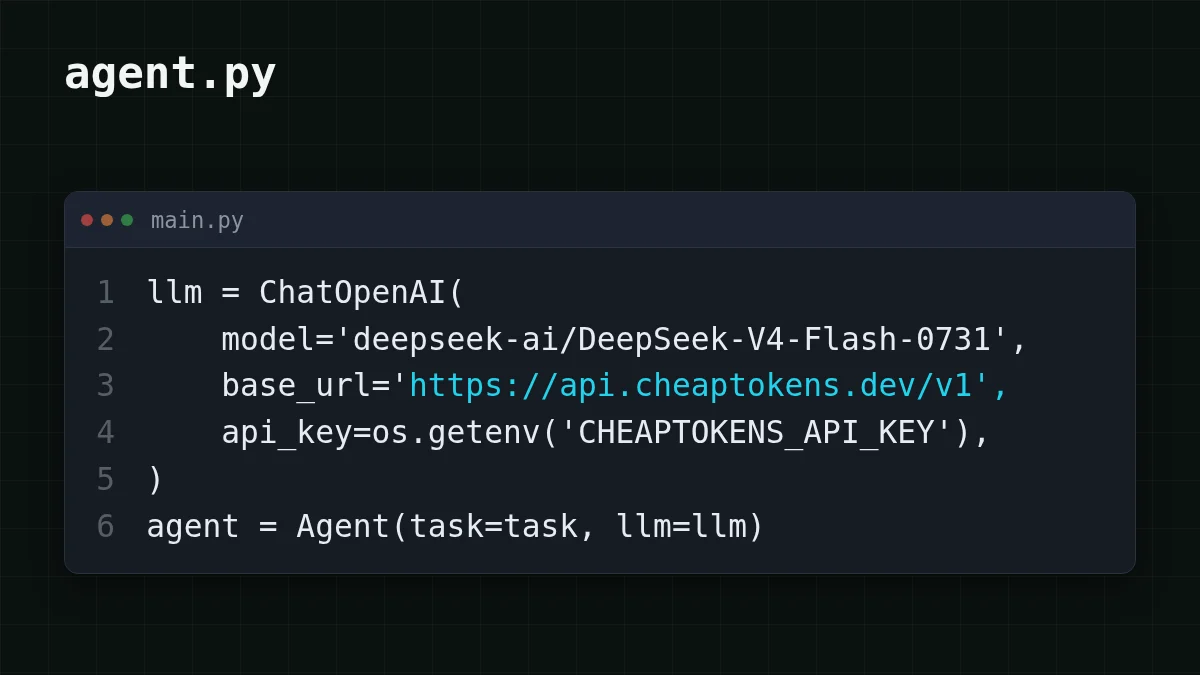
为什么选这个模型:浏览器运行是多次调用,且页面上下文很长。DeepSeek-V4-Flash 有 380K 上下文窗口,每次回答最多 32,768 个输出 token,并且全天任意时段价格一致。id 必须是完整的 deepseek-——价格表中的短名称不被 API 接受。其他 id 和连接基础知识见 CheapTokens 文档。
代理在价格页面上实际做什么#
假设你的任务是“这台笔记本电脑今天多少钱”。代理运行一个循环:获取页面文本,询问模型下一步做什么,在浏览器中执行操作(打开、滚动、点击),然后取回新的页面文本。它重复此过程,直到模型认为已有答案。
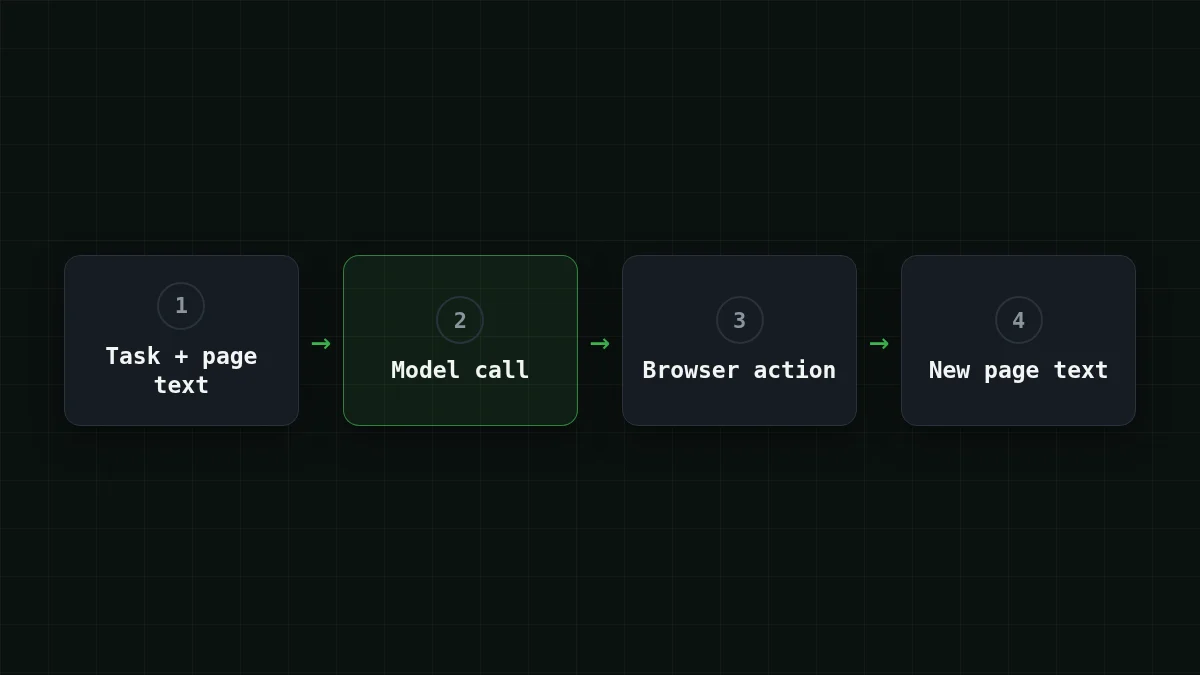
最后一个箭头是成本驱动因素。产品页面可能有数千个 token 的文本,并且每次调用都会携带它。11 月 6 日的一篇频道文章将 Browser Use 列为购物代理的浏览器层,该代理比较报价并跟踪降价;同样的思路适合每天检查一两个页面,如上文任务所示。
选择你的情况
浏览器代理是适合你检查的工具吗?
选择一个选项以查看答案
价格只有在点击后才显示
浏览器代理适合。它在真实浏览器中打开页面,选择尺寸或颜色,滚动并读取出现的内容。将其写成脚本意味着要为每个商店维护选择器。
一个固定 URL 和一个固定价格元素
带选择器的普通脚本更便宜:完全没有模型调用。将固定步骤放在代码中,把模型留给会变化的部分。更多内容见 代理是否需要在每一步都使用模型。
两三个布局不同的商店
浏览器代理适合。一个任务文本覆盖多种页面布局,之后你比较单行答案。
在安排任何计划之前有一个警告:代理会读取页面所说的任何内容,而页面可能包含针对代理的指令。提示注入检查清单 涵盖了应对措施,上文任务出于同样原因禁止购买。
一次运行的成本#
不要猜;要假设。假设一次运行需要 15 步。每一步发送任务、历史和当前页面:约 12,000 个输入 token,模型用约 600 个 token 的简短操作回答。
15 × 12,000 = 180,000 个输入 token,15 × 600 = 9,000 个输出 token 每次运行。在 DeepSeek-V4-Flash 上,该次运行成本为 $0.0036,输入价格为每 100 万 token $0.015。这里输入是输出的 20 倍,这对浏览器工作很典型,并且合计计算时,价格低于 OpenRouter 对该模型的参考价。
下表对 15 步使用相同的每步数字,以便你并排查看每个模型:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 15 次请求 | OpenRouter,15 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00026 | $0.004 | $0.0068 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00024 | $0.0036 | $0.0139 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00069 | $0.0104 | $0.124 |
每次请求 12,000 个输入 token 和 600 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
然后按你的计划扩展。每天检查三个页面是 45 步;将滑块拖到你自己的数字。
成本计算器
一天的价格检查:3 个页面,每个 15 步
每次请求的输入 token 数: 12,000 · 每次请求的输出 token 数: 600 · 每日请求数: 45
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0119 | $0.356 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0108 | $0.324 |
| MiniMax-M2.7$0.05$0.15 | $0.0311 | $0.932 |
三个模型上 50 步版本的此计算见 代理会话成本。如果你更喜欢 GLM-5.3-Flash(390K 上下文,最多 8,192 个输出 token),它的行在上表中;这里的简短操作回答远低于该限制。每个模型的当前价格在 定价页面 上。
如果不起作用#
从错误文本开始。以下三个是常见嫌疑:
配对
将症状与原因匹配
点击左侧项目,然后点击其配对项
- 401 Unauthorized密钥在
.env中缺失或有拼写错误 - 404 model not found使用了短模型 id 而不是
deepseek-ai/ DeepSeek- V4- Flash- 0731 - {"navigate": "google.com"} 而不是 {"navigate": {"url": ...}}模型返回了错误的操作模式
最后一个在 Browser Use 的支持模型页面(2026 年 11 月 8 日检查)中针对较小的 Qwen 模型有所描述:它们可能返回错误的操作模式。文档建议的修复方法是将正确操作格式的示例放入提示中。将它们添加到任务文本中,例如:
Actions are JSON objects like {"navigate": {"url": "https://..."}}.
Always put the url inside the object.
如果运行一直原地打转,请缩小任务范围:一个页面、一个问题、单行答案。短任务用更少的步骤完成,而更少的步骤是最便宜的修复方法。
下一步:使用自定义 base_url 的 LangChain 如果你围绕浏览器代理构建自己的链,则使用相同的 base_url 思路。


