模型与对比对比
Agent 会话成本:GLM、DeepSeek 或 MiniMax 上的 50 步
计算当每一步都重新发送历史时,一个 50 步 agent 会话的成本,然后在 GLM-5.3-Flash、DeepSeek-V4-Flash 和 MiniMax-M2.7 之间选择。
你的 agent 运行了十分钟,账单却比任务本身还大。这并不奇怪:每一步都会重新发送完整历史,因此输入侧会随每一步增长,最终占据大部分成本。按下面的数字,一个 50 步的会话会发送 885,000 个输入 token,并写入 40,000 个。根据历史会增长到多大、单个回答需要多长来选择模型,然后在表中核对总额。
为什么第 50 步比第 1 步更贵#
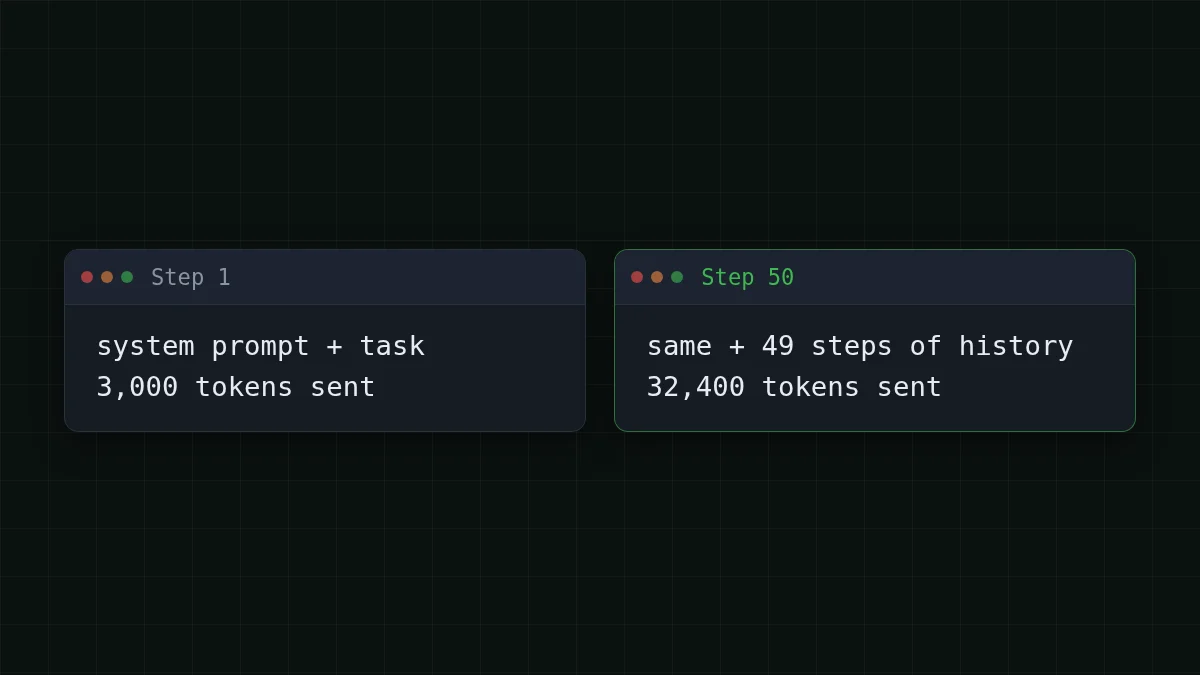
模型在两次调用之间不记得任何东西。为了继续任务,agent 会再次发送所有内容:指令、之前每一步,以及上一步产生的结果。第 1 步发送起始上下文。第 50 步发送起始上下文加上 49 步的历史。如果这个概念对你来说很新,为什么 AI agent 使用这么多 token 用一个 20 步的例子做了说明。
假设 agent 以 3,000 个 token 开始(系统提示、任务、几个文件),每一步向历史中增加约 600 个 token:agent 保留一份经过裁剪的笔记,记录它做了什么、看到了什么,并丢弃其余内容。那么第 50 步会发送 3,000 + 600 × 49 = 32,400 个 token。回答保持在每步约 800 个 token。问题不断增长;回答不会。
50 步的总和#
在算数之前,先猜一下。
猜数字
整个 50 步会话会发送多少个输入 token?
你的猜测
02,000,000
显示答案
答案: 885,000
大约 885,000。第 k 步发送 3,000 + 600 × (k − 1) 个 token,50 步加起来是 885,000——超过 agent 写入的 40,000 个 token 的二十倍。
按你在纸上计算的顺序求和:
- 起始上下文发送 50 次:50 × 3,000 = 150,000。
- 步骤编号 0 到 49 相加为 49 × 50 ÷ 2 = 1,225,每个单位是 600 个 token 的历史:600 × 1,225 = 735,000。
- 输入总计:150,000 + 735,000 = 885,000。
- 输出总计:50 × 800 = 40,000。
历史占 885,000 中的 735,000,而且它的增长速度比步数更快。把任务翻倍到 100 步:99 × 100 ÷ 2 = 4,950,所以历史是 600 × 4,950 = 2,970,000,起始上下文是 100 × 3,000 = 300,000,合计 3,270,000 个输入 token。步数翻倍,输入几乎翻四倍。输出只翻倍:100 × 800 = 80,000。
每个模型上的会话成本#
请求按输入和输出一起计费,所以比较总额。按这种方式计算,对于这个负载,三个模型的总成本都比 OpenRouter 便宜;表中的 OpenRouter 列显示了这一点。价格是实时的,所以表格保持最新。
| 模型 | 输入 $/1M | 输出 $/1M | 费用 | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0193 | $0.033 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0173 | $0.0676 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0503 | $0.603 |
总计 885,000 个输入 token 和 40,000 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
从输入侧来看。这个会话中每 100 个 token 里约有 96 个是输入,所以输入价格决定了大部分总额。目前每 1M token 的输入价格:DeepSeek-V4-Flash $0.015,GLM-5.3-Flash $0.02,MiniMax-M2.7 $0.05。
以及翻倍的情况,在 DeepSeek-V4-Flash 上:
现在换成你自己的负载。我们例子中的平均每一步发送 885,000 ÷ 50 = 17,700 个输入 token,并写入 800 个。一天五个这样的任务是 5 × 50 = 250 步。把数字换成你的;计算器会按实时价格对每一步求和。
成本计算器
一天五个 50 步任务
每次请求的输入 token 数: 17,700 · 每次请求的输出 token 数: 800 · 每日请求数: 250
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0965 | $2.90 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0864 | $2.59 |
| MiniMax-M2.7$0.05$0.15 | $0.251 | $7.54 |
历史能放进窗口吗?#
成本是一个限制。另一个是窗口:大于模型上下文的请求根本无法发送。CheapTokens 模型目录(2026 年 11 月 4 日)列出了这些限制:
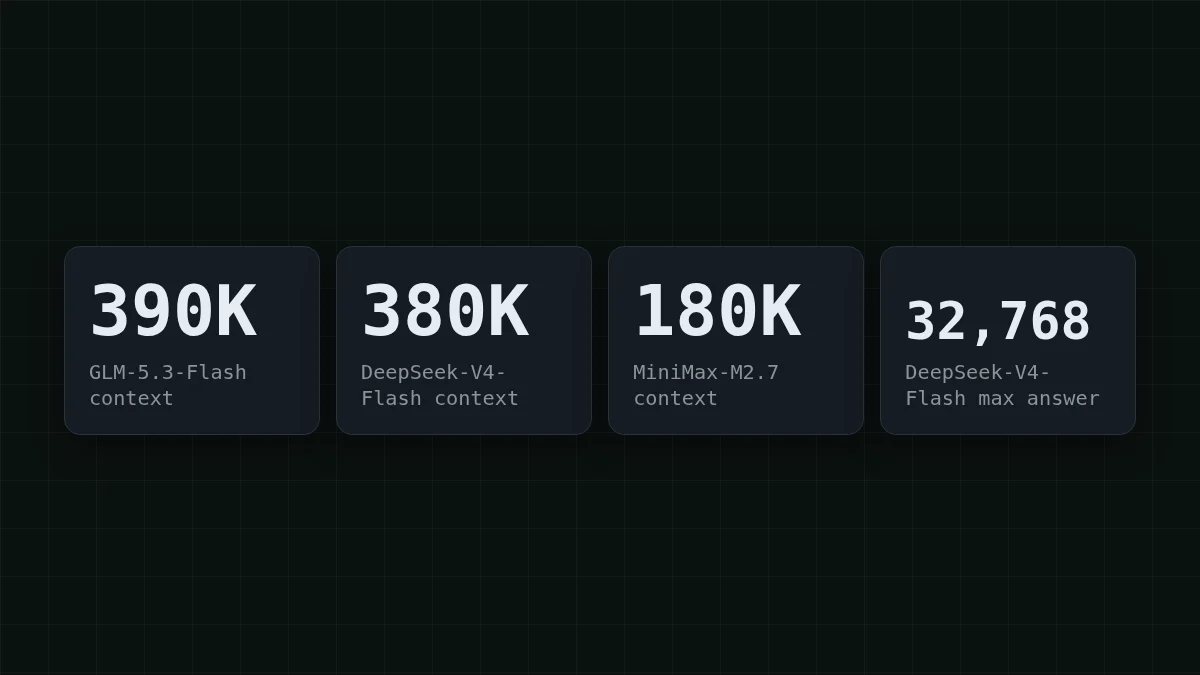
按我们每步 600 个 token 的增长,仅历史在許多步之后就会接近窗口:MiniMax-M2.7 大约在第 290 步(3,000 + 600 × 289 = 176,400),DeepSeek-V4-Flash 大约在第 620 步(3,000 + 600 × 619 = 374,400),GLM-5.3-Flash 大约在第 640 步(3,000 + 600 × 639 = 386,400)。一个 50 步的会话只用到其中任何一个的一小部分。
真实会话更粗糙。如果某一步粘贴了一大段日志,增加了 6,000 个 token 而不是 600 个,MiniMax-M2.7 的 180K 大约在第 30 步就用完:3,000 + 6,000 × 29 = 177,000。同样的任务在更大的窗口中能容纳得久得多。
回答限制则相反。GLM-5.3-Flash 和 MiniMax-M2.7 每个回答最多写 8,192 个 token,DeepSeek-V4-Flash 最多 32,768 个。假设某一步必须生成一份 10,000 token 的报告。在 8,192 的限制下,回复会在上限处停止,finish_reason 会显示 length;在 DeepSeek-V4-Flash 上,它能在一个回答中容纳。
客服机器人的同样求和#
客服机器人是同样的循环,只是里面有人。假设一段对话有 30 轮,系统提示和规则占 1,000 个 token,每轮向历史中增加 300 个 token(客户 100 个,机器人 200 个)。
- 起始上下文,30 次:30 × 1,000 = 30,000。
- 历史:29 × 30 ÷ 2 = 435 个 300 token 的单位,所以 300 × 435 = 130,500。
- 输入总计:30,000 + 130,500 = 160,500。
- 输出总计:30 × 200 = 6,000。
这样一段对话在 GLM-5.3-Flash 上花费 $0.0035,在 DeepSeek-V4-Flash 上花费 $0.003,在 MiniMax-M2.7 上花费 $0.0089。形状是一样的:每 100 个 token 中约有 96 个是输入。每天有数千段对话的机器人会在第一周就感受到这一点,而裁剪历史就是杠杆。滑动窗口还是摘要 展示了如何做。
测量你自己的会话#
上面的假设是整数。你的 agent 有自己的数字,而 API 会准确告诉你:每个响应都带有一个 usage 对象,包含该次调用的输入和输出 token。这个循环与不带工具的 agent 形状相同:历史增长,整个列表被重新发送。这是一个示例;把提示换成你的任务。
import os
import requests

URL = 'https://api.cheaptokens.dev/v1/chat/completions'
HEADERS = {'Authorization': 'Bearer ' + os.environ['CHEAPTOKENS_API_KEY']}

messages = [{'role': 'system', 'content': 'You are a research agent. Work in small steps.'}]
total_in = total_out = 0

for step in range(1, 51):
    messages.append({'role': 'user', 'content': f'Step {step}: continue the task.'})
    r = requests.post(URL, headers=HEADERS, timeout=120, json={
        'model': 'deepseek-ai/DeepSeek-V4-Flash-0731',
        'messages': messages,
        'max_tokens': 800,
    }).json()
    messages.append(r['choices'][0]['message'])
    total_in += r['usage']['prompt_tokens']
    total_out += r['usage']['completion_tokens']
    print(step, r['usage']['prompt_tokens'], r['usage']['completion_tokens'])

print('session:', total_in, 'input,', total_out, 'output')
每行打印的中间数字是该次调用的输入,它每一步都在上升。这个上升就是历史。把最后一行的两个总数代入上面的成本计算器,替换 885000 和 40000,你就得到了自己会话的价格。基础 URL、密钥和模型 ID 在 CheapTokens 文档 中有描述。
你的会话该用哪个模型#
每次会话的价格在表中。它无法显示的是会话是否能容纳,所以根据你的情况选择:
选择你的情况
你的 agent 是什么样子?
选择一个选项以查看答案
短回答,历史保持在 180K 以下
三个都适合。MiniMax-M2.7 的 180K 窗口能容纳数百个像上面那样的步骤,所以按成本表选择。详情见 MiniMax-M2.7。
长历史,不裁剪
GLM-5.3-Flash 拥有三者中最大的窗口,390K,DeepSeek-V4-Flash 以 380K 紧随其后。两者都为有大量工具或日志粘贴的会话留出了空间。详情见 GLM。
需要写长文件或报告的步骤
DeepSeek-V4-Flash:单个回答最多 32,768 个 token,而另外两个是 8,192,外加 380K 窗口。详情见 DeepSeek。
夜间批处理,无人看管
三个模型在任何时段价格都相同,没有高峰时段定价,所以夜间运行的成本与表中一致。根据上面的章节确定窗口和回答限制的大小,并在循环中设置步数限制。
三个模型都位于同一个 CheapTokens 余额上,使用相同的 OpenAI 兼容地址,所以试运行后切换只是更改模型 ID。当前价格在定价页面上;优点的并排比较在 GLM vs DeepSeek vs MiniMax 中。


